Le 1er décembre, vos appels à gemini-2.5-pro passeront sur Gemini 3.8 Flash. Changez vous-même le nom du modèle avant que Google ne le fasse

By Surya Pratap
19 novembre 2026
8 min read
AI & Technology

19 novembre 2026
8 min read
 Voir ce qui est routé, et quoi faire en premierHover to explore
La plupart des dépréciations de modèles se terminent par une erreur. Vos requêtes échouent, vos alertes se déclenchent, et vous migrez. Google a choisi une autre fin pour deux de ses modèles les plus utilisés. À partir du 1er décembre, les requêtes à gemini-2.5-pro et gemini-2.5-flash n'échoueront pas. Un autre modèle y répondra, au prix de ce modèle, pendant que votre code continuera de demander l'ancien. Personne ne vous préviendra. C'est précisément pour cela qu'il faut s'en occuper cette semaine.
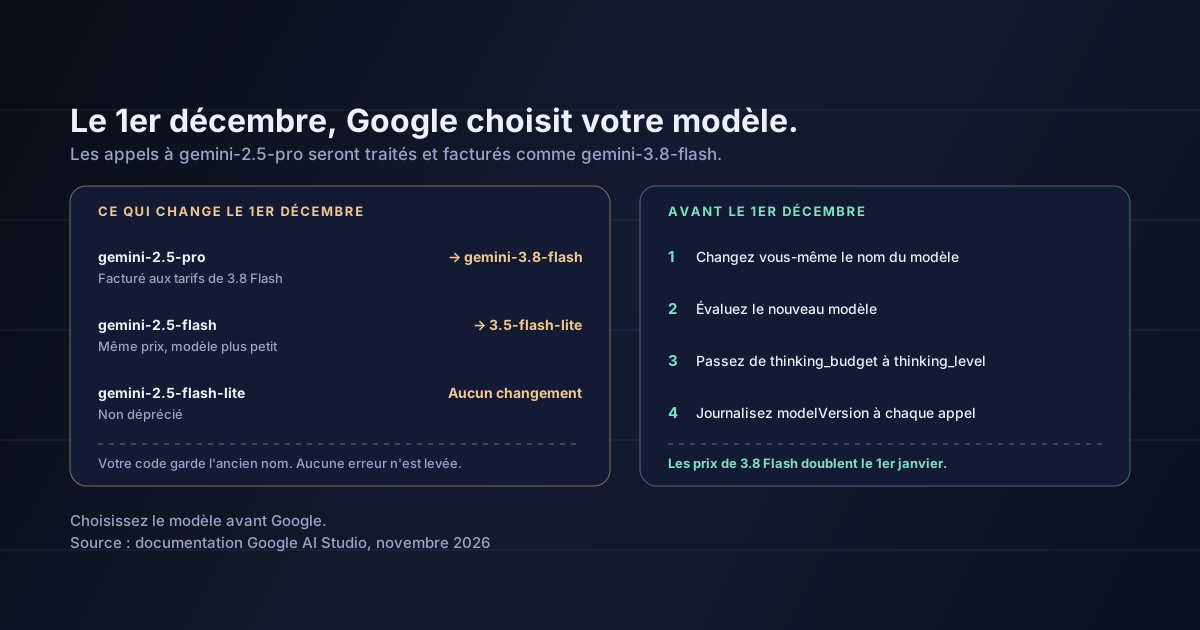
Le 2 novembre, Google a marqué les deux modèles comme dépréciés et fixé la même date pour chacun :
gemini-2.5-pro : « À partir du 1er décembre 2026, toutes les requêtes API adressées à gemini-2.5-pro seront automatiquement routées vers gemini-3.8-flash et facturées aux tarifs de Gemini 3.8 Flash. » Il a déjà disparu du sélecteur de modèles de Google AI Studio.gemini-2.5-flash : à partir de la même date, les requêtes « seront automatiquement routées vers gemini-3.5-flash-lite et facturées aux tarifs de Gemini 3.5 Flash-Lite ».gemini-2.5-flash-lite : il n'est pas déprécié. Google indique qu'il « reste disponible via l'API jusqu'à nouvel ordre ».thought_signature, thinking_level qui remplace thinking_budget, ainsi que la suppression des paramètres d'échantillonnage et des tours de modèle pré-remplis ».Le conseil de Google est direct : mettez à jour le nom du modèle avant le 1er décembre et lisez le guide de migration du nouveau modèle.
Une dépréciation qui renvoie des erreurs fait du bruit. Vous le savez en quelques minutes. Une dépréciation qui route est silencieuse. Vos logs montrent des réponses réussies, vos tableaux de bord restent au vert, et les seuls signaux sont ceux que vous ne surveilliez pas : des réponses qui sonnent différemment, un ticket de support sur une fonctionnalité qui « a empiré », une ligne de coût qui a bougé.
Regardez ce que fait chaque route. gemini-2.5-pro est un modèle Pro ; son remplaçant est un modèle Flash. gemini-2.5-flash passe à un modèle Flash-Lite. Google a peut-être raison de penser que les modèles plus récents et plus petits suffisent pour l'essentiel du trafic. Mais « l'essentiel du trafic », c'est la moyenne de Google, pas votre produit. Si vous avez choisi 2.5 Pro parce qu'un modèle moins cher échouait à vos tests, le 1er décembre annule ce choix sans vous demander votre avis.
Une dépréciation qui échoue vous dit qu'elle a eu lieu. Une dépréciation qui route ne vous le dit que si vous regardez.
Un autre modèle. Les requêtes routées reçoivent leur réponse de gemini-3.8-flash ou de gemini-3.5-flash-lite. Les deux lisent jusqu'à 1 048 576 tokens et écrivent jusqu'à 65 536, donc les limites de contexte ne poseront pas problème. La qualité sur vos tâches reste la question ouverte.
D'autres valeurs par défaut. Le tableau de raisonnement de Google indique que gemini-3.5-flash-lite utilise par défaut le niveau minimal, et gemini-3.8-flash le niveau medium. Pour 3.8 Flash, Google précise que « minimal n'est pas pris en charge et renvoie une erreur ». Si vous n'avez jamais fixé le raisonnement explicitement, la quantité de raisonnement derrière vos réponses changera d'elle-même.
Un autre contrat d'API. Les changements incompatibles ne sont pas cosmétiques. thinking_level remplace thinking_budget. Les appels de fonctions valident désormais thought_signature. Les paramètres d'échantillonnage sont supprimés, tout comme les tours de modèle pré-remplis. Google ne dit pas ce que recevra une requête routée qui envoie encore les anciens paramètres : une erreur, ou un réglage ignoré sans prévenir. Dans les deux cas, mieux vaut le découvrir avant vos utilisateurs.
Une autre facture. Les requêtes sont facturées aux tarifs du nouveau modèle. Le calcul est dans la section suivante, et il comporte une deuxième date.
Par million de tokens, d'après la page des tarifs de Google :
| gemini-2.5-pro aujourd'hui | gemini-3.8-flash jusqu'au 31 décembre | gemini-3.8-flash à partir du 1er janvier 2027 | |
|---|---|---|---|
| Entrée, prompts jusqu'à 200K tokens | 1,25 $ | 0,75 $ | 1,50 $ |
| Entrée, prompts de plus de 200K tokens | 2,50 $ | 0,75 $ | 1,50 $ |
| Sortie, prompts jusqu'à 200K tokens | 10,00 $ | 3,75 $ | 7,50 $ |
| Sortie, prompts de plus de 200K tokens | 15,00 $ | 3,75 $ | 7,50 $ |
3.8 Flash bénéficie d'un prix de lancement jusqu'au 31 décembre. Prenez une étape d'agent avec 50 000 tokens en entrée et 5 000 en sortie. Sur 2.5 Pro, elle coûte environ 0,11 $. Routée en décembre, environ 0,06 $. À partir de janvier, de nouveau environ 0,11 $. Une étape lourde en entrée, avec 150 000 tokens en entrée et 2 000 en sortie, coûte environ 0,21 $ aujourd'hui, 0,12 $ en décembre et 0,24 $ en janvier : plus que ce que vous payez maintenant.
Pour gemini-2.5-flash, le prix ne bouge pas. 2.5 Flash et 3.5 Flash-Lite sont tous deux affichés à 0,30 $ par million de tokens en entrée et 2,50 $ par million de tokens en sortie. Vous payez la même chose pour un modèle plus petit.
# gemini_call.py — choose the model explicitly and log what served it
import logging
from google import genai
from google.genai import types

log = logging.getLogger("llm")
client = genai.Client()

MODEL = "gemini-3.8-flash"   # was "gemini-2.5-pro": change it before 1 December

def ask(prompt: str) -> str:
    resp = client.models.generate_content(
        model=MODEL,
        contents=prompt,
        config=types.GenerateContentConfig(
            # thinking_level replaces thinking_budget on Gemini 3 models
            thinking_config=types.ThinkingConfig(thinking_level="medium"),
        ),
    )
    # modelVersion: "the model version used to generate the response"
    log.info("requested=%s served=%s", MODEL, resp.model_version)
    return resp.text
Changez le nom vous-même. Cherchez gemini-2.5-pro et gemini-2.5-flash dans votre code, votre configuration, votre dépôt de prompts et vos outils no-code. Migrer à votre date vous permet de tester, de déployer progressivement et de revenir en arrière. Être routé à la date de Google ne vous offre rien de tout cela.
Testez le remplaçant, et ses alternatives. Lancez votre jeu d'évaluation sur gemini-3.8-flash ou gemini-3.5-flash-lite à chaque niveau de raisonnement. Si une tâche de niveau Pro échoue sur Flash, testez un modèle plus grand au lieu d'accepter la route. Le successeur proposé par Google n'est pas la seule option.
Corrigez d'abord les changements incompatibles. Remplacez thinking_budget par thinking_level. Supprimez les paramètres d'échantillonnage et les tours de modèle pré-remplis. Vérifiez votre code d'appels de fonctions au regard de la nouvelle validation de thought_signature. Lancez vos tests d'appels d'outils de bout en bout, pas seulement des prompts isolés.
Journalisez modelVersion à chaque appel. La référence de l'API décrit le champ de réponse modelVersion comme « la version du modèle utilisée pour générer la réponse ». Enregistrez-le à côté du modèle demandé. Si les deux divergent un jour, vous le verrez le jour même, et non sur la facture du mois suivant.
Le même jour, un autre prix change
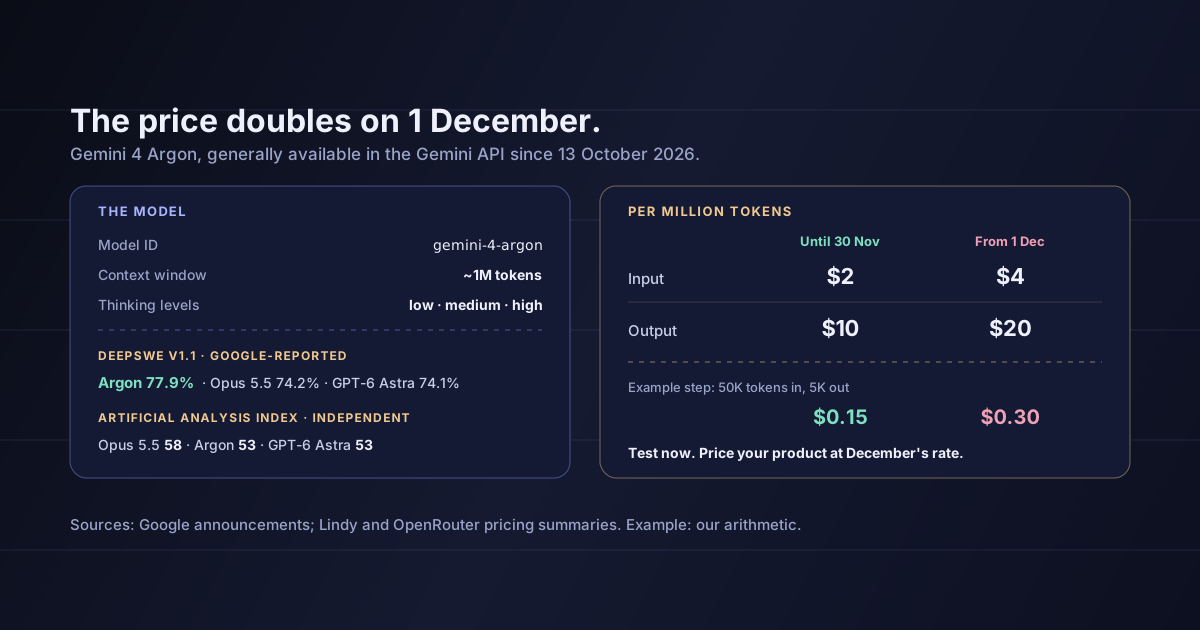
Le 1er décembre marque aussi la fin du prix de lancement de Gemini 4 Carbon. La page des tarifs de Google l'affiche à 2 $ par million de tokens en entrée et 10 $ par million de tokens en sortie jusqu'au 30 novembre, puis à 4 $ et 20 $. Si vous avez basculé quelque chose sur Carbon ou Argon pendant la période de lancement, revérifiez aussi ces marges. Nous avons fait le même calcul pour Gemini 4 Argon.
Que 3.8 Flash soit moins bon que 2.5 Pro pour vous. Il est plus récent et, sur beaucoup de tâches, il peut être meilleur. Je n'ai pas vu Google publier de comparaison directe des deux sur les mêmes tâches. C'est votre jeu d'évaluation qui tranche.
Ce qui se passe sur Vertex AI. Le changelog, la page des dépréciations et celle des tarifs que j'ai consultés couvrent la Gemini API dans Google AI Studio. Ils ne mentionnent pas Vertex AI. Si vous appelez Gemini via Vertex, consultez son propre calendrier de dépréciation.
Comment les requêtes routées traitent les anciens paramètres. Google liste les changements incompatibles, mais ne dit pas si une requête routée qui envoie thinking_budget échoue ou est ajustée sans prévenir. Testez-le au lieu de le supposer.
Que les dates soient définitives. La page des dépréciations de Google précise que les dates d'arrêt sont « les dates les plus précoces possibles auxquelles un modèle pourrait être retiré ». Elles peuvent être repoussées. Planifier pour le 1er décembre reste le choix prudent.
À partir du 1er décembre 2026, les requêtes à la Gemini API adressées à gemini-2.5-pro recevront leur réponse de gemini-3.8-flash et seront facturées à ses tarifs, et celles adressées à gemini-2.5-flash recevront leur réponse de gemini-3.5-flash-lite sans changement de prix. gemini-2.5-flash-lite n'est pas concerné. Google liste des changements incompatibles de l'API pour la transition, dont thinking_level qui remplace thinking_budget, une nouvelle validation des appels de fonctions et la suppression des paramètres d'échantillonnage et des tours pré-remplis. 3.8 Flash coûte moins cher que 2.5 Pro jusqu'au 31 décembre ; à partir du 1er janvier, son prix double, et le travail lourd en entrée finit par coûter plus cher qu'aujourd'hui.
Le risque n'est pas le nouveau modèle. C'est que le changement se produise sans erreur, sans décision et sans test.
Avant le 1er décembre, remplacez chaque gemini-2.5-pro et gemini-2.5-flash par un modèle que vous avez testé, corrigez les changements incompatibles et commencez à journaliser modelVersion pour savoir quel modèle a répondu à chaque requête.
Sources : Google AI Studio, changelog de la Gemini API, entrée du 2 novembre 2026 — la dépréciation de gemini-2.5-pro et gemini-2.5-flash, le routage et la facturation automatiques à partir du 1er décembre 2026, et la liste des changements incompatibles de l'API. Dépréciations — dates de sortie et d'arrêt, statut de gemini-2.5-flash-lite, et la mention que les dates d'arrêt sont les plus précoces possibles. Tarifs — les prix de gemini-2.5-pro, gemini-2.5-flash, gemini-3.8-flash, gemini-3.5-flash-lite et Gemini 4 Carbon. Gemini 3.8 Flash et Gemini 3.5 Flash-Lite — limites de tokens et niveaux de raisonnement. Référence de l'API generateContent — le champ de réponse modelVersion. Tout a été consulté le 19 novembre 2026. Les exemples de coût et la lecture des sections 2 à 6 sont les miens.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.