
Le jeu d'évaluation de votre MVP IA : testez de vraies tâches utilisateur avant le lancement

By Surya Pratap
16 juillet 2026
7 min read
MVP Strategy

16 juillet 2026
7 min read
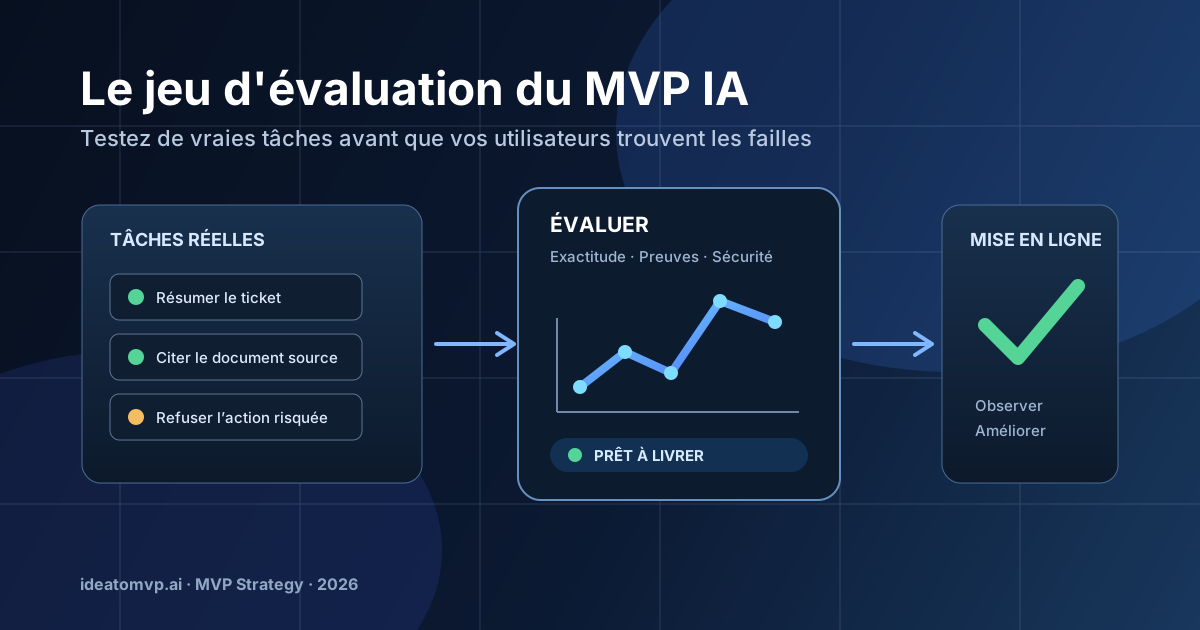
Une démo d'IA peut paraître convaincante tout en échouant sur le travail dont le client a réellement besoin. Elle peut produire une réponse soignée à laquelle il manque une information indispensable, citer un document qui ne soutient pas sa conclusion ou déclencher une action que l'utilisateur n'a jamais voulue. Ces échecs sont difficiles à repérer quand chaque prompt de test est inventé sur le moment.
Pour un produit en phase de démarrage, la réponse pratique n'est pas un gigantesque programme de benchmarks. C'est un petit jeu d'évaluation : une collection versionnée de vraies tâches, de résultats attendus et de règles de notation claires, que vous exécutez chaque fois que le prompt, le modèle, le système de récupération ou le workflow change. Il transforme le « ça a l'air mieux » en preuves comparables.
Les fondateurs commencent souvent par choisir le modèle, parce que c'est visible et facile à discuter. Or les utilisateurs n'achètent pas un modèle ; ils achètent un résultat fiable. Écrivez le travail que votre produit doit accomplir dans les mots d'un client : « transforme ce fil de support en passation », « extrais la date de renouvellement de ce contrat » ou « propose une réponse en t'appuyant uniquement sur notre base de connaissances validée ».
Chaque travail devient un cas de test. Un cas utile comprend l'entrée que fournirait l'utilisateur, le contexte que votre système a le droit d'utiliser, le résultat attendu et l'échec qui rendrait le résultat inacceptable. L'évaluation reste ainsi reliée à la valeur du produit plutôt qu'à un score de benchmark générique.
Pas besoin de centaines d'exemples pour apprendre quelque chose d'important. Commencez avec 15 à 20 cas issus d'appels de découverte, de travail fait à la main, d'entretiens clients, de tickets de support ou de documents que vous avez le droit d'utiliser. Incluez des cas ordinaires, pas seulement des cas limites spectaculaires. Si la tâche courante est ratée, le produit n'est pas utile.
Protégez les données clients en collectant vos exemples
Utilisez dans votre jeu d'évaluation des entrées consenties, anonymisées ou synthétiques. Supprimez les identifiants, les données personnelles et tout contexte client superflu. L'objectif est de conserver la structure de la tâche et les critères de décision, pas de créer une nouvelle copie incontrôlée de données sensibles.
La correspondance exacte de chaînes est généralement trop fragile pour une sortie générative. Notez plutôt les propriétés qui définissent un résultat utile. Pour un extracteur de contrats, cela peut vouloir dire que la date est correcte, que le passage source est cité et que l'incertitude est explicite quand la date est absente. Pour un copilote de support, que le résumé conserve le problème du client, évite les engagements inventés et recommande la prochaine action approuvée.
Une grille simple à trois niveaux fonctionne bien au début : réussi pour un résultat sur lequel l'utilisateur pourrait agir, à revoir pour un résultat partiellement utile, et échec pour une erreur importante, une affirmation non étayée ou un comportement dangereux. Ajoutez une courte justification à côté de chaque résultat non réussi. Ces justifications constituent votre backlog produit.
Un score unique peut masquer la raison pour laquelle un workflow n'est pas prêt. Suivez trois dimensions séparément. La qualité : la réponse résout-elle la tâche ? La sécurité : le système est-il resté dans le comportement autorisé et dans le périmètre de données ? L'exploitation : le workflow répond-il assez vite, et à un coût que l'entreprise peut supporter ?
Cette séparation rend les arbitrages visibles. Un modèle plus gros peut améliorer une tâche de raisonnement difficile tout en poussant le temps de réponse au-delà de ce qu'un assistant intégré au produit peut tolérer. Une mise à jour de la récupération peut améliorer la pertinence tout en augmentant les citations non étayées. Traiter chaque dimension indépendamment vous aide à décider s'il faut ajuster, router autrement, ajouter un point de contrôle humain ou restreindre le périmètre de la fonctionnalité.
Exécutez les mêmes cas avant et après chaque changement significatif : une réécriture du prompt, un nouveau modèle, des instructions système modifiées, de nouveaux segments pour la récupération ou un nouvel outil pour l'agent. Ne livrez pas parce que la dernière sortie impressionne dans une seule conversation. Livrez quand le changement améliore ou préserve les résultats qui comptent pour vos utilisateurs, sans créer de nouveaux problèmes de sécurité.
Votre premier jeu d'évaluation n'est pas une certification. C'est une habitude produit rigoureuse. Conservez les cas, leurs résultats attendus, la grille de notation et les résultats à côté du travail sur la fonctionnalité. Donnez à chaque cas un responsable et une raison d'exister. Quand un client découvre un échec significatif, transformez-le en test de régression anonymisé avant de le corriger.
Un MVP IA devient crédible lorsqu'il est fiable sur la tâche précise qu'il promet d'accomplir. Un jeu d'évaluation compact donne aux fondateurs un moyen d'améliorer délibérément cette fiabilité, avant qu'une démo soignée ne devienne une mauvaise surprise coûteuse en production.


IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.