
LiteLLM comme passerelle de données IA : protéger les informations sensibles de vos clients

By Surya Pratap
15 juillet 2026
8 min read
AI & Technology

15 juillet 2026
8 min read
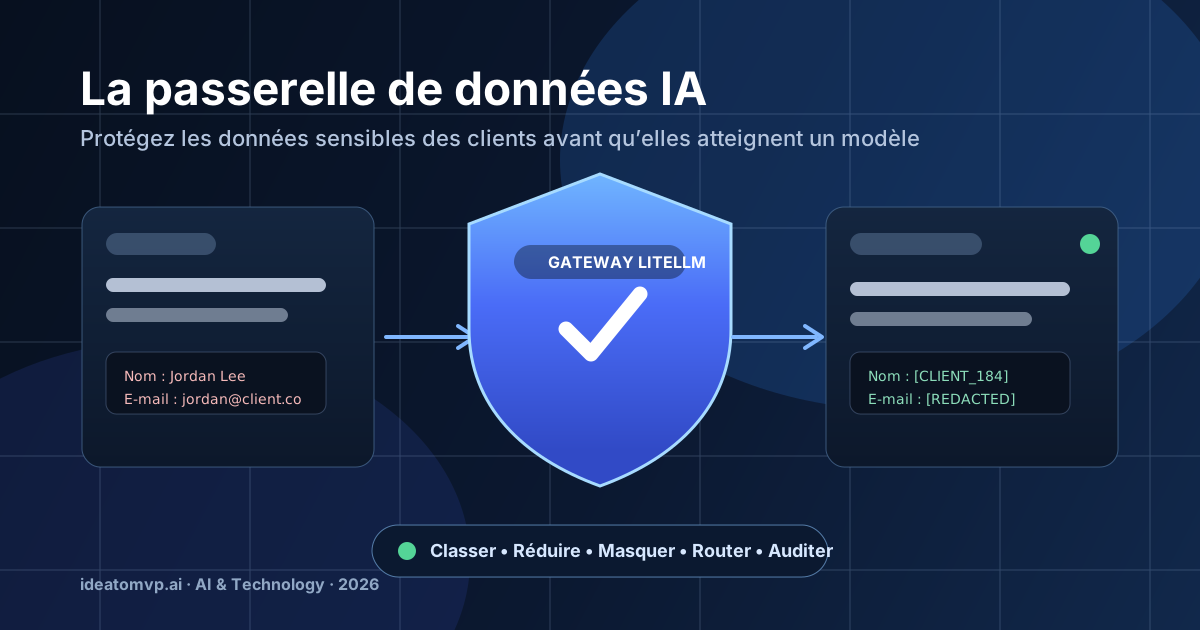
La décision d'architecture IA la plus lourde de conséquences n'est souvent pas le choix du modèle. C'est de décider à quel endroit les données clients franchissent la frontière entre votre application et le système d'un fournisseur de modèles. Une transcription de support peut contenir un numéro de compte. Un formulaire d'admission médicale peut contenir un diagnostic. Un prompt commercial peut contenir un contrat, une dérogation tarifaire ou une feuille de route confidentielle. Envoyer ce contexte directement depuis chaque fonctionnalité vers chaque fournisseur crée un périmètre de données que vous ne pouvez ni voir ni gouverner de manière fiable.
LiteLLM est utile ici, et pas seulement parce qu'il offre aux équipes une API unique pour de nombreux modèles. Utilisé de façon délibérée, il devient une passerelle IA : un point de contrôle unique où appliquer des règles avant qu'une requête ne quitte votre environnement, puis router la requête minimisée vers un fournisseur de modèles approuvé.
Sans passerelle, une équipe produit accumule peu à peu des appels SDK directs dans le chat, le support, la recherche documentaire, l'analytique et les workflows d'agents. Chaque appel peut choisir un fournisseur différent, utiliser des réglages de journalisation différents et transporter une quantité différente de contexte client. Les revues de sécurité deviennent une fouille du code applicatif au lieu de l'examen d'une seule frontière de règles.
Il ne s'agit pas de dire qu'aucune donnée ne doit jamais atteindre un modèle. La bonne question est plus précise : quelles informations sont nécessaires à cette tâche, quels champs sont sensibles, et quel fournisseur est autorisé à traiter le prompt qui en résulte ? Une passerelle donne à ces questions un endroit où elles s'appliquent réellement.
Le masquage n'est pas tout le contrôle
La détection par motifs ne trouve que ce qu'elle sait chercher. Considérez le masquage comme un contrôle parmi d'autres dans une conception en couches : contrats d'entrée structurés, champs sur liste d'autorisation, politique de fournisseurs, contrôles d'accès, règles de conservation et revue de ce que conservent vos journaux. Une passerelle rend ces contrôles cohérents ; elle ne dispense pas de les concevoir.
Choisissez la transformation en fonction de ce que le modèle doit faire. Si le nom d'un client n'apporte rien à une tâche de résumé, remplacez-le par une étiquette générique. Si le modèle doit distinguer deux personnes au fil d'une conversation, utilisez un marqueur stable comme CLIENT_184 et gardez la table de correspondance dans votre propre système. Si un prompt contient un identifiant, un numéro de carte de paiement ou des données que votre politique interdit de faire sortir de l'environnement, bloquez la requête et renvoyez un message sûr à la fonctionnalité appelante.
Le schéma le plus solide consiste généralement à minimiser les données avant de les détecter : construire les prompts à partir d'un petit ensemble typé de champs autorisés, plutôt que d'envoyer un enregistrement complet de la base de données et d'essayer de le nettoyer ensuite.
Ne commencez pas par placer toutes les fonctionnalités IA derrière un moteur de règles complexe. Commencez par le workflow le plus clairement exposé aux données clients : le résumé de tickets de support, l'extraction de documents ou un assistant interne qui a accès aux dossiers clients. Recensez les champs qu'il envoie aujourd'hui, décidez lesquels sont nécessaires et placez un chemin de passerelle unique devant lui. Les règles et la télémétrie qui en résultent vous montreront où le workflow suivant a besoin d'une règle différente.
Le but n'est pas de rendre l'IA inutilisable. C'est de rendre chaque appel à un modèle intentionnel, explicable et réversible. Une couche d'abstraction fondée sur LiteLLM transforme le choix du fournisseur et la protection des données clients, aujourd'hui un détail d'implémentation éparpillé, en une architecture que votre équipe peut inspecter et améliorer.


IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.