
La pile multimodèle : comment les startups réduisent de 85 % leurs coûts de développement IA en 2026

By Surya Pratap
8 juillet 2026
9 min read
AI & Technology

8 juillet 2026
9 min read
Le 7 juillet 2026, Paul Graham a publié une expérience de pensée d'une ligne qui a envahi le Twitter tech : « Imaginez ce que ce sera si, dans 5 ans, les modèles ont autant progressé par rapport à Fable que Fable a progressé par rapport à GPT-3. » Les citations se sont partagées comme toujours : moitié émerveillement, moitié scepticisme. Mais la conversation la plus utile ne portait pas du tout sur 2031. Elle se trouvait dans les réponses, où des développeurs en activité publiaient leurs factures.
$200 par jour. $350 par jour. $500 par jour sur des boucles d'agents intensives. Pas des cas isolés : un flux continu de fondateurs et d'ingénieurs qui disaient la même chose. Les derniers modèles de pointe sont stupéfiants, et faire passer tout son workflow de développement par eux devient discrètement l'un des plus gros postes du budget d'une petite startup. La même semaine, un contre-modèle est devenu viral sur Reddit et X : la pile multimodèle, et ses chiffres méritent l'attention de tout fondateur.
Voici le calcul qui dérange. Les modèles de pointe actuels affichent environ $10 par million de tokens en entrée et $50 par million de tokens en sortie. Les modèles de milieu de gamme des mêmes laboratoires coûtent un cinquième de cela, voire moins. Et pour une grande part de ce que fait réellement un workflow de développement (renommer des variables, écrire du code répétitif, générer des tests à partir d'une spécification claire, corriger des erreurs de lint, itérer sur du CSS), le modèle de milieu de gamme donne pour l'essentiel le même résultat.
Quand vous faites tout passer par le modèle de pointe, vous payez la prime 100 % du temps pour un travail qui n'en a besoin que 20 % du temps, peut-être. C'est ainsi qu'un fondateur seul se retrouve avec une facture IA de $6,000/mois avant d'avoir un seul client payant.
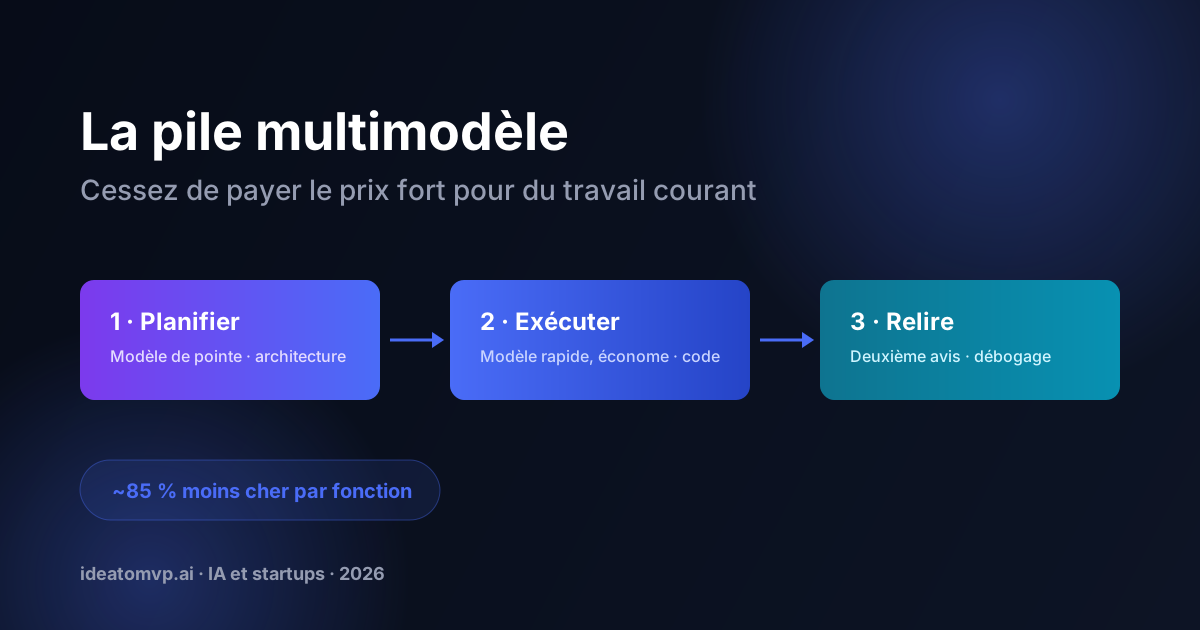
La pile multimodèle devenue virale cette semaine comporte trois étapes, chacune confiée au modèle le mieux adapté, et le mieux tarifé, pour la tâche :
Le calcul par fonctionnalité
Les équipes qui appliquent ce schéma font état d'une baisse des coûts d'environ 85 % par fonctionnalité, pour une qualité comparable ou meilleure : le modèle cher n'intervient que sur les étapes courtes et à fort levier, et la génération gourmande en tokens se fait sur des modèles tarifés pour le volume. Pour une équipe qui livre des dizaines de fonctionnalités par sprint, c'est la différence entre une dépense IA négligeable et votre deuxième poste de coût après les salaires.
Une grande entreprise peut absorber une facture IA gonflée. Une startup en pré-amorçage, non, et surtout, l'habitude s'accumule. Les équipes qui traitent tôt le routage de modèles comme une discipline d'ingénierie finissent avec trois avantages structurels :
L'écart entre GPT-3 et les modèles de pointe actuels est difficile à surestimer, et si les cinq prochaines années le reproduisent, la plupart des débats actuels sur les workflows paraîtront désuets. Mais cet avenir joue dans les deux sens : chaque modèle de pointe du passé a fini par devenir un modèle courant. Le fleuron d'aujourd'hui à $50 par million de tokens sera l'exécutant bon marché de l'an prochain. Une pile multimodèle n'est pas un pari contre les progrès de l'IA : c'est l'architecture qui en profite automatiquement, car chaque nouvelle version prend place dans votre table de routage au niveau que son prix justifie.
Les startups qui gagneront ce cycle ne seront pas celles qui auront le plus dépensé en tokens. Ce seront celles qui auront construit la discipline de dépenser exactement ce que vaut chaque tâche, et qui auront livré plus vite grâce à cela.
Si vous construisez un produit d'IA et voulez de l'aide pour concevoir une architecture de routage de modèles qui garde votre consommation prévisible, réservez un appel de découverte gratuit : c'est exactement le type de système que nous livrons à des fondateurs chaque mois.



IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.