
L'intégration verticale de l'IA en entreprise : maîtriser les couches GPU, modèle et application en 2026

By Surya Pratap
7 juillet 2026
11 min read
AI & Technology

7 juillet 2026
11 min read
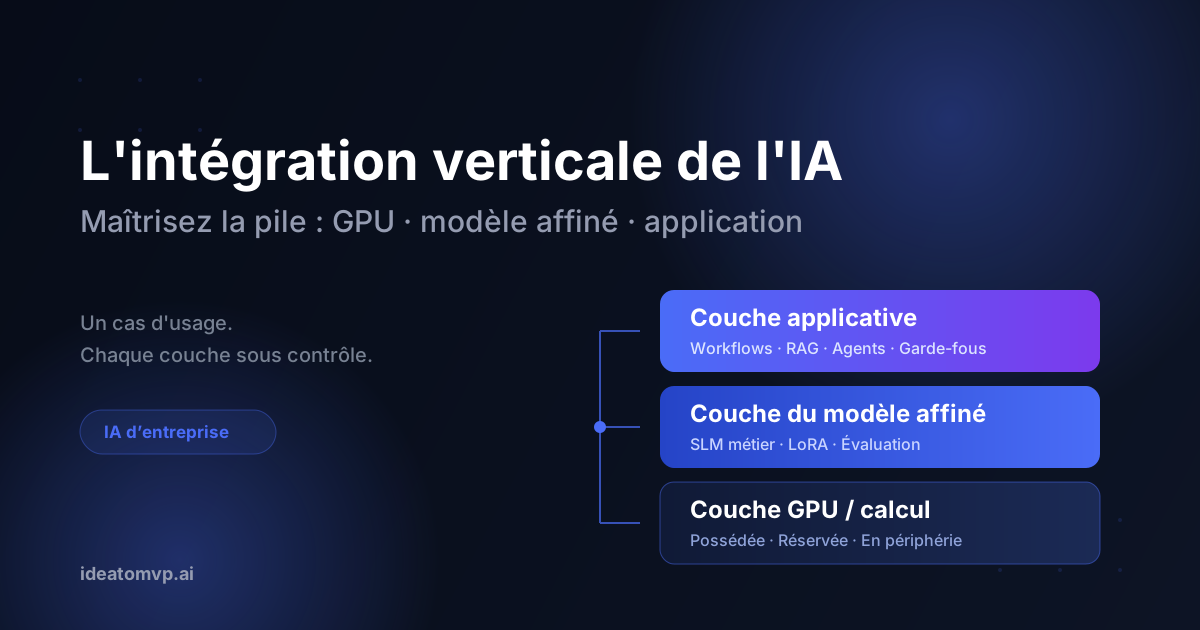
Ces trois dernières années, l'architecture IA par défaut des entreprises a été horizontale : louer un modèle de pointe via une API, le brancher sur une douzaine de workflows et payer au token. C'était rapide pour démarrer et coûteux pour durer. En 2026, les entreprises les plus grandes et les plus sérieuses sur le plan opérationnel font discrètement l'inverse : elles intègrent verticalement leur pile IA, couche par couche, autour des cas d'usage qui pèsent réellement sur leur compte de résultat.
L'intégration verticale en IA signifie la même chose que pour Ford et l'acier ou Apple et le silicium : posséder les couches de votre chaîne de valeur qui créent de la différenciation, au lieu de les louer à un fournisseur qui sert aussi vos concurrents. En IA, ces couches sont au nombre de trois : la couche de calcul (GPU), la couche du modèle et la couche applicative. Cet article passe chacune en revue, explique pourquoi le calcul de l'intégration tient enfin la route, et décrit le séquencement qui permet à une entreprise d'opérer la transition sans mettre l'entreprise en jeu.
Trois forces ont convergé pour rendre rationnelle la possession de la pile, y compris pour des entreprises qui en auraient ri en 2024.
La logique stratégique est celle qu'Alex Karp, de Palantir, martèle publiquement : contrôlez votre calcul, les poids de vos modèles et vos données, ou regardez la valeur de votre savoir propriétaire s'écouler dans l'entraînement d'un autre. L'intégration verticale est la manière dont ce principe devient une architecture.
Posséder la couche de calcul ne veut pas dire construire un data center. Cela veut dire passer de la tarification au token à une capacité que vous contrôlez, sous la forme qui convient à votre échelle :
La règle de décision est le taux d'utilisation. Si votre volume d'inférence est stable et prévisible, la capacité possédée ou réservée l'emporte. S'il est irrégulier et expérimental, gardez cette charge sur du calcul loué et intégrez d'abord les charges stables.
C'est la couche où l'intégration verticale crée un avantage défendable. Une API de pointe donne à chaque concurrent la même intelligence au même prix. Un modèle affiné sur votre historique de transactions, vos conversations de support, vos contrats ou vos rapports de défauts, c'est une intelligence que vous seul possédez.
Le pipeline de fine-tuning moderne est bien plus léger que ne le pensent la plupart des dirigeants :
Le test d'intégration pour la couche du modèle
Posez une seule question : cette tâche bénéficie-t-elle d'un savoir que nous sommes seuls à posséder ? Si oui, faites du fine-tuning et possédez-la. Si non, si un modèle générique bien piloté fait l'affaire, continuez à louer cette tâche et consacrez votre budget d'entraînement là où vos données font la différence.
La couche applicative est l'endroit où le modèle rencontre le métier, et c'est la couche que les entreprises ratent le plus souvent : soit en la confiant à un éditeur SaaS (et en perdant le workflow avec les données), soit en y investissant moins que dans le modèle. Une couche applicative intégrée verticalement comprend :
Aucune entreprise n'intègre tout verticalement d'un coup. Le schéma qui fonctionne va du haut vers le bas, à l'inverse de la lecture du schéma de la pile :
Chaque étape se justifie indépendamment par son propre retour sur investissement, et chaque étape est réversible. C'est ce qui en fait une stratégie plutôt qu'un pari.
L'intégration verticale n'est pas pour vous si vos charges de travail IA sont encore exploratoires, s'il vous manque les données étiquetées qui rendent le fine-tuning rentable, ou si vos tâches principales exigent réellement un raisonnement de niveau frontière et une large connaissance du monde. Dans ces cas, la pile louée n'est pas un piège : c'est le bon outil. L'erreur est d'y rester par défaut une fois que vos charges de travail sont devenues étroites, stables et riches en données.
Les entreprises qui réussissent avec l'IA en 2026 ne sont pas celles qui ont les plus gros budgets d'API. Ce sont celles qui ont identifié leur cas d'usage à plus forte valeur et plus fort volume et qui ont intégré la pile en dessous : une logique applicative qu'elles maîtrisent, un modèle entraîné sur des données qu'elles sont seules à posséder, tournant sur un calcul tarifé comme une infrastructure plutôt que comme un service au compteur. Commencez par le haut de la pile, descendez une couche à la fois, et laissez le retour de chaque couche financer la suivante.
Si vous vous demandez par où commencer (quelle charge de travail affiner en premier, ou si votre volume justifie un calcul en propre), réservez un appel de découverte gratuit et nous dessinerons votre pile avec vous.



IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.