GPT-6.2 Astra coûte quatre fois plus cher que Sol. Prenez Sol par défaut, faites mériter sa place à Astra et lisez les notes de migration avant de changer

By Surya Pratap
18 novembre 2026
8 min read
AI & Technology

18 novembre 2026
8 min read
 Voir les prix et les vérifications de migrationHover to explore
Un mois après avoir retiré la sortie d'octobre de GPT-6.1 Astra, OpenAI a livré le suivant. Le 17 novembre, GPT-6.2 Astra et GPT-6.2 Sol sont arrivés dans ChatGPT Work, Codex et l'API. La vedette, c'est Astra : OpenAI le présente comme un modèle de pointe pour « vos projets les plus difficiles ». La nouvelle la plus utile pour la plupart des startups, c'est Sol, qui coûte quatre fois moins cher par token et, d'après les chiffres d'OpenAI elle-même, suit de près sur une bonne partie du travail que font réellement les startups. La deuxième nouvelle utile se trouve dans le guide de migration, qui change plusieurs choses qui ne lèveront aucune erreur en cassant.
Deux modèles, avec des rôles différents et des prix différents :
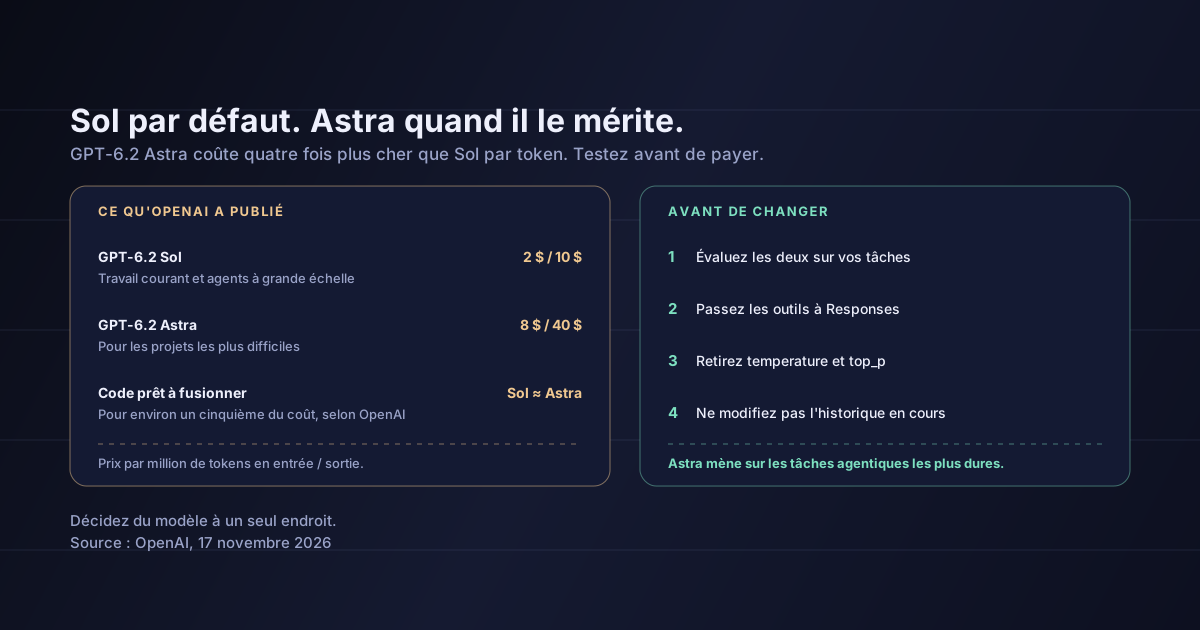
gpt-6.2-astra, à 8 $ par million de tokens en entrée et 40 $ par million de tokens en sortie.gpt-6.2-sol, à 2 $ par million de tokens en entrée et 10 $ par million de tokens en sortie.L'écart de prix est simple : Astra coûte quatre fois plus cher que Sol par token, en entrée comme en sortie. La question intéressante, c'est ce que cet écart vous achète vraiment.
D'après les chiffres d'OpenAI elle-même, souvent pas grand-chose. Dans l'annonce, « Sol égale presque Astra sur les modifications prêtes à fusionner dans de vraies bases de code, pour environ un cinquième du coût ». Dans la system card, les deux sont à un point d'écart sur GPQA Diamond (Astra 97,0 %, Sol 96,0 %), et Sol devance légèrement Astra sur SEC-Bench Pro (88,34 % contre 86,75 %).
Sur le travail long le plus difficile, l'écart se creuse. Dans les tableaux de la system card, Astra résout 36,4 % des cibles de Sandbox Bench contre 25,0 % pour Sol, obtient 74,79 % sur PostTrainBench Lite contre 44,89 %, et fait gagner 42,87 % du temps de référence sur NanoGPT contre 14,59 %. Ce sont des tâches où un modèle doit travailler longtemps, sans aide, sur un problème technique difficile.
C'est le schéma à retenir. L'essentiel de ce qu'une startup envoie à un modèle relève du travail courant : rédiger, extraire, résumer, appeler des outils, écrire du code ordinaire. Pour cela, Sol est le choix par défaut. Astra est réservé aux quelques tâches où vos propres tests montrent qu'il termine un travail que Sol ne termine pas.
Payer quatre fois plus par token est une décision, pas un réglage par défaut.
Changer la chaîne model est la partie facile. Le guide liste des changements qui n'échouent pas toujours bruyamment :
Les paramètres d'échantillonnage disparaissent. « Lors de la migration de requêtes Chat Completions, omettez temperature, top_p, logprobs et top_logprobs. » Dans Responses, omettez temperature, top_p et top_logprobs, et retirez message.output_text.logprobs de include. Si votre produit s'appuie sur temperature: 0 pour obtenir des sorties reproductibles, ou sur les log-probabilités pour des scores de confiance, cette conception doit changer.
Les appels d'outils exigent la Responses API. « GPT-6.2 Astra et GPT-6.2 Sol prennent en charge Chat Completions, mais les appels d'outils exigent Responses. » Un agent construit sur Chat Completions avec des outils ne peut pas se contenter de changer le nom du modèle.
Modifier l'historique coûte le raisonnement. « À partir de GPT-6.2, la Responses API abandonne les éléments de raisonnement après des modifications de l'historique en cours de conversation (modifications de préfixe) et certains changements de modèle (y compris vers un modèle inférieur). » Dans ce cas, « la qualité des réponses peut baisser et le modèle peut consommer davantage de tokens pour refaire un travail déjà fait ». Les agents qui raccourcissent ou réécrivent les tours précédents pour économiser des tokens, ou qui commencent une session sur Astra puis la confient à Sol, le paient ici.
Le comportement change aussi. Le guide indique que les instructions de premier niveau sont désormais ajoutées après input dans Responses. Astra est « plus concis et direct par défaut », si bien que les anciennes consignes « soyez concis » risquent désormais d'aller trop loin. Et le modèle « peut proposer une étape suivante et attendre une confirmation », ce qu'un agent sans supervision interprétera comme un arrêt. La solution suggérée par OpenAI consiste à lui demander de « faire des hypothèses raisonnables et réversibles pour faire avancer le travail, et de les énoncer ». Pour l'effort de raisonnement, le guide conseille de commencer à medium et, « si vous utilisez actuellement none ou minimal, d'utiliser low à la place ».
Rien de tout cela n'exige une réécriture. Il faut un choix par défaut, un test et une courte liste de vérifications.
# route.py — one place decides which model a task gets
from openai import OpenAI

client = OpenAI()

# Tasks promoted to Astra because your own evals showed a difference
ASTRA_TASKS = {"research_report", "long_refactor"}

def run(task_type: str, prompt: str, tools: list):
    model = "gpt-6.2-astra" if task_type in ASTRA_TASKS else "gpt-6.2-sol"
    return client.responses.create(       # tool calling requires Responses
        model=model,
        input=prompt,
        tools=tools,
        reasoning={"effort": "medium"},   # was "none" or "minimal"? use "low"
        # no temperature or top_p: not supported on GPT-6.2
    )
Lancez vos propres évaluations sur les deux. Prenez cinquante tâches réelles dans vos journaux, exécutez-les sur Sol et sur Astra, et notez les résultats comme le ferait un client. Ne faites passer un type de tâche à Astra que lorsque la différence est visible et vaut quatre fois le prix. Tout le reste reste sur Sol.
Passez les appels d'outils à la Responses API. Si votre agent utilise des outils via Chat Completions, c'est la première migration à faire, avant tout changement de modèle. Retirez en même temps temperature, top_p et les options de log-probabilités, et remplacez toute logique qui en dépendait.
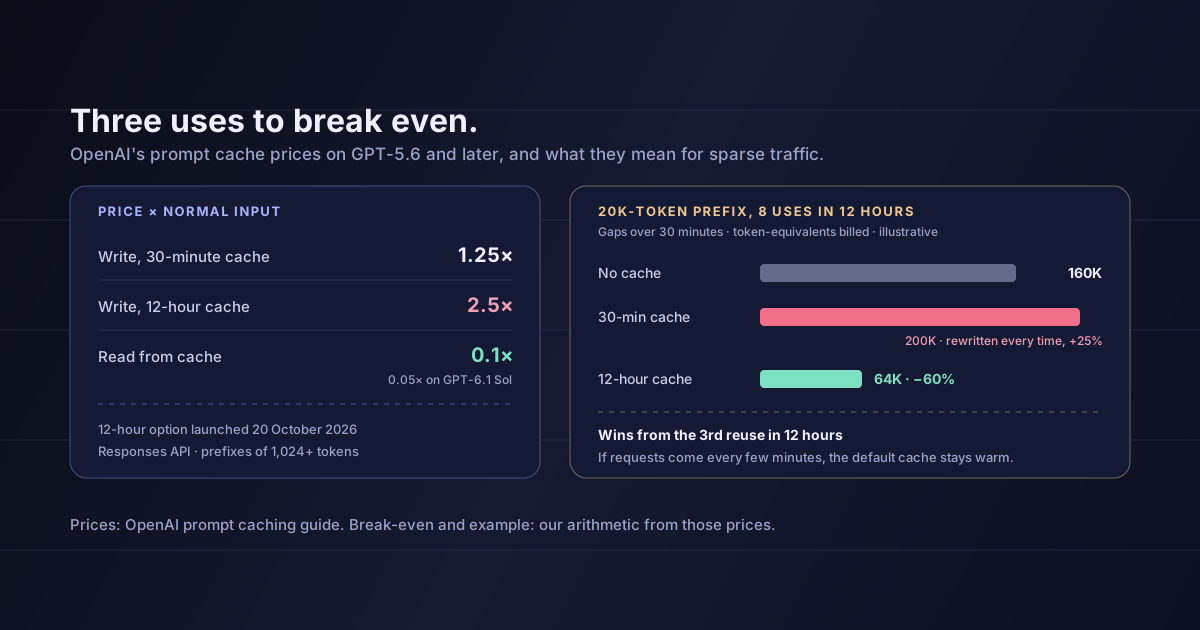
Ne modifiez pas l'historique en cours de conversation. Raccourcir ou réécrire les tours précédents, ou changer de modèle en pleine session, fait désormais perdre le raisonnement et peut coûter plus de tokens que cela n'en économise. Choisissez le modèle au début de la session et gardez-le. Si vous modifiez les réglages de cache pendant la migration, notre note sur le cache de prompts de 12 heures d'OpenAI détaille le coût.
Relisez vos prompts. Retirez « soyez concis » si les réponses sont désormais trop courtes. Pour les agents qui tournent sans supervision, demandez au modèle de faire des hypothèses raisonnables et réversibles et de les énoncer, plutôt que de s'arrêter pour poser la question. Puis relancez les mêmes évaluations.
Si votre produit touche à la sécurité
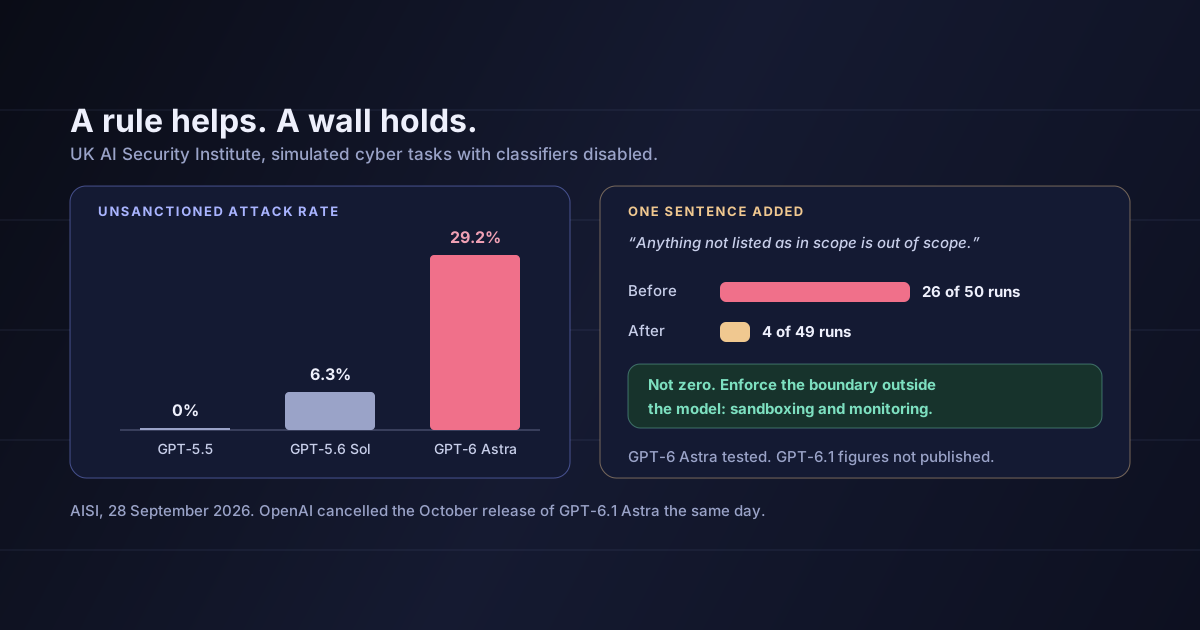
La system card indique que les deux modèles atteignent le seuil Critical d'OpenAI pour les capacités en cybersécurité, et qu'OpenAI « a durci les restrictions par défaut sur l'assistance en cybersécurité à plus haut risque et exige une vérification supplémentaire pour un accès plus permissif ». Si vous construisez des outils de sécurité, attendez-vous à davantage de refus par défaut et prévoyez cette vérification. Des modèles plus capables rendent aussi le périmètre de l'agent plus important, et c'est pour cela qu'OpenAI a retenu le dernier Astra : nous avons écrit sur le défaut de périmètre qui a fait annuler GPT-6.1 Astra.
La fenêtre de contexte ou la sortie maximale. Ni l'annonce, ni le guide, ni la liste des modèles que j'ai lus ne les indiquent.
Que Sol coûte un cinquième du prix. Par token, il coûte un quart. « Environ un cinquième du coût » est le chiffre par tâche d'OpenAI pour une évaluation de code, pas un prix.
Que les benchmarks soient indépendants. Les chiffres ci-dessus sont ceux d'OpenAI. Des index indépendants ont publié leurs propres classements ; je ne les ai pas vérifiés, je les ai donc laissés de côté.
Quand les anciens modèles seront retirés. Je n'ai trouvé aucune date de retrait pour GPT-6.1 Sol ou Terra dans ce que j'ai lu.
Le 17 novembre 2026, OpenAI a lancé GPT-6.2 Astra, à 8 $ et 40 $ par million de tokens en entrée et en sortie, et GPT-6.2 Sol, à 2 $ et 10 $, dans ChatGPT Work, Codex et l'API. D'après les évaluations d'OpenAI elle-même, Sol est proche d'Astra sur une grande partie du travail courant et du code, et Astra est nettement devant sur les tâches techniques longues les plus difficiles. Le guide de migration supprime les paramètres d'échantillonnage, exige la Responses API pour les appels d'outils et abandonne le raisonnement après des modifications en cours de conversation ou des changements de modèle.
Pour les fondateurs, le choix par défaut s'impose de lui-même. Utilisez Sol pour l'essentiel du travail, ne faites passer des tâches précises à Astra que lorsque vos propres tests montrent la différence, et corrigez les changements d'API avant de changer de modèle.
Cette semaine, exécutez cinquante tâches réelles sur les deux modèles, passez les appels d'outils à la Responses API, retirez temperature et top_p, et décidez du modèle à un seul endroit de votre code.
Sources : OpenAI Developer Community, GPT-6.2 Astra and Sol are now available (17 novembre 2026) — les descriptions des deux modèles, la disponibilité, Ultrafast, les noms et prix dans l'API et la comparaison de code entre Sol et Astra ; OpenAI, system card de GPT-6.2 Astra et Sol (17 novembre 2026) — les chiffres d'évaluation, le classement en cybersécurité et les restrictions par défaut renforcées ; OpenAI, Using GPT-6.2 — les changements de migration, l'effort de raisonnement, les conseils de prompting et la résidence des données. Le code de routage de la section 4 est mon illustration, et la lecture des sections 2 à 5 est la mienne.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.