Écrire dans le cache de 12 heures d'OpenAI coûte 2,5×. Sur le papier, c'est rentable dès la troisième requête

By Surya Pratap
21 octobre 2026
8 min read
AI & Technology

21 octobre 2026
8 min read
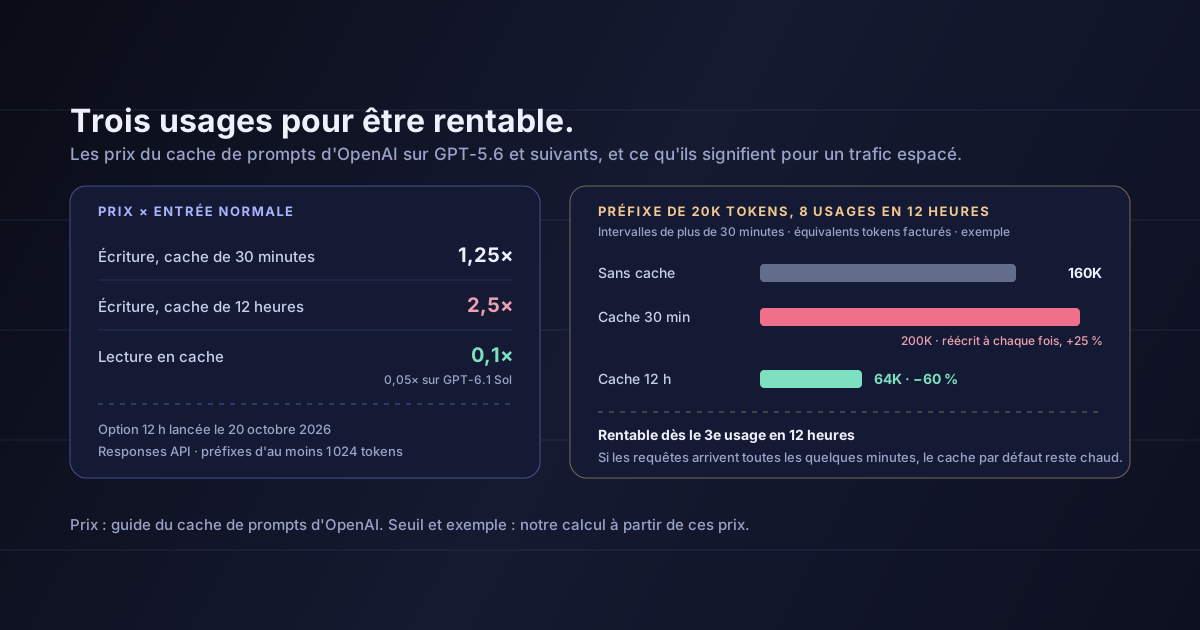 Trois usages pour être rentableHover to explore
Le prompt caching est l'un des rares leviers qui réduisent la facture d'un produit d'IA sans toucher à la qualité. La nouvelle option d'OpenAI fait durer le cache bien plus longtemps, en échange d'un prix plus élevé pour y écrire. Qu'elle vous fasse économiser dépend d'une chose que la plupart des équipes n'ont jamais mesurée : le temps qui sépare les requêtes partageant le même prompt.
Cet article s'appuie sur le guide du prompt caching et le journal des modifications d'OpenAI, ainsi que sur l'article de Runtime Wire. Les prix sont les multiplicateurs publiés par OpenAI pour GPT-5.6 et suivants. Les seuils de rentabilité des sections 3 et 4 sont mes propres calculs à partir de ces multiplicateurs, selon les hypothèses simplifiées indiquées, et ne viennent pas d'OpenAI.
Le 20 octobre 2026, OpenAI a permis aux développeurs d'activer un cache de prompts de 12 heures dans la Responses API, à côté du cache de 30 minutes existant par défaut. OpenAI le destine aux agents persistants : « Les agents persistants, comme dots, réutilisent leur contexte tout au long de la journée », a indiqué son compte développeurs.
Sur GPT-5.6 et suivants, on l'active en réglant prompt_cache_options.ttl sur "12h" au lieu de la valeur par défaut "30m". Les deux sont des durées de vie minimales.
Pour GPT-5.6 et suivants, en multiples du prix normal (hors cache) des tokens en entrée :
| Prix | |
|---|---|
| Écriture, cache de 30 minutes | 1,25× |
| Écriture, cache de 12 heures | 2,5× |
| Lecture en cache | 0,1× (0,05× sur GPT-6.1 Sol) |
Trois autres règles comptent :
prompt_cache_key facultatif permet de séparer les caches par client ou par utilisateur.Sur les modèles antérieurs, l'écriture en cache n'entraîne aucun surcoût, et les options de rétention sont différentes.
Prenons un préfixe — prompt système, définitions d'outils, documents de référence — de taille P, réutilisé N fois en 12 heures. On ignore les tokens de sortie et la partie de chaque prompt qui change : ils coûtent la même chose dans tous les cas.
En cherchant quand le cache de 12 heures coûte moins cher que l'absence de cache, on obtient N > 2,7. Par rapport à un cache de 30 minutes qui expire sans cesse, N > 2,1. Autrement dit : avec ces hypothèses simplifiées, dès la troisième utilisation du même préfixe en 12 heures, le cache de 12 heures l'emporte — à condition que les intervalles soient assez longs pour que le cache par défaut ait expiré.
Quand les requêtes arrivent toutes les quelques minutes, le cache par défaut ne refroidit jamais, et l'option de 12 heures coûte simplement 1,25 × P de plus par fenêtre, pour rien.
Un cache plus long ne fait économiser que si les intervalles entre vos requêtes dépassent la durée du cache par défaut.
Un agent de support fictif dispose d'un préfixe de 20 000 tokens : instructions, schémas d'outils et manuel produit. Un client l'utilise 8 fois au cours d'une journée de travail, environ toutes les une à deux heures. Entrée facturée pour le préfixe, en équivalents tokens :
Soit une baisse de 60 % par rapport à l'absence de cache sur le préfixe — et un enseignement moins évident : pour un trafic espacé comme celui-ci, le cache par défaut peut coûter 25 % de plus que l'absence de cache, parce que l'on paie le surcoût d'écriture sans jamais lire.
Si chaque client a ses propres documents de référence dans le préfixe, chacun nécessite sa propre écriture. L'économie s'applique toujours client par client, mais seulement pour ceux qui reviennent au moins trois fois dans la fenêtre.
Ceux qui y gagnent probablement. Les assistants et agents utilisés quelques fois par jour par client, avec de longues instructions ou de longs documents stables : copilotes internes, assistants de compte, agents planifiés qui se réveillent toutes les une à deux heures, outils B2B utilisés par à-coups au fil de la journée.
Ceux qui n'y gagnent probablement pas. Les fonctions à fort trafic où le même préfixe est sollicité toutes les quelques minutes : le cache par défaut reste déjà chaud. Ni les requêtes ponctuelles, ni les prompts de moins de 1 024 tokens, ni les prompts dont le début change à chaque appel.
Corrigez d'abord le préfixe. Placez tout ce qui est stable au début — instructions, définitions d'outils, documents de référence — et tout ce qui change à la fin. Un horodatage dans la première ligne du prompt système neutralise silencieusement toute durée de cache.
Mesurez avant de basculer. Journalisez, par préfixe, le nombre de réutilisations et les intervalles entre elles, et lisez le nombre de tokens en cache renvoyé par l'API. N'activez les 12 heures que pour les préfixes qui correspondent vraiment à ce profil, pas pour tout.
Vérifiez ce que vous coûte le cache par défaut
Si vous êtes passé à GPT-5.6 ou à une version ultérieure et que votre trafic par préfixe est espacé, regardez votre facture dès maintenant. L'écriture à 1,25× du cache par défaut passe facilement inaperçue, et pour des requêtes espacées de plus de 30 minutes, c'est un pur surcoût. Vous le payez peut-être déjà, avant même de décider quoi que ce soit sur les 12 heures.
Un contexte long et répété est le plus gros coût caché des produits à base d'agents, comme nous l'avons vu quand un seul refactoring a coûté 14,29 dollars en tokens. Le cache est le remède le moins cher — mais seulement s'il correspond à la façon dont vos utilisateurs se comportent réellement.
Que le cache de 12 heures dure toujours 12 heures, ou que les lectures en cache sont garanties. OpenAI décrit les deux durées comme des minimums, et un cache peut tout de même échouer. Les économies réelles seront un peu inférieures à celles du calcul.
Que les seuils de rentabilité viennent d'OpenAI. Ce sont mes calculs à partir des multiplicateurs publiés, en supposant des préfixes identiques et sans tenir compte des correspondances partielles.
Que ces prix s'appliquent à tous les modèles. Ils valent pour GPT-5.6 et suivants ; les modèles antérieurs n'ont pas de surcoût d'écriture et ont d'autres options de rétention, et GPT-6.1 Sol lit à 0,05×.
Que le cache convient aux données sensibles sans vérification. OpenAI précise que les données en cache peuvent être conservées dans le stockage local des GPU. Si vous avez des engagements de conservation des données, vérifiez comment le cache s'y intègre avant de l'allonger.
OpenAI propose désormais un cache de prompts de 12 heures dans la Responses API. Sur GPT-5.6 et suivants, y écrire coûte 2,5× le prix en entrée, contre 1,25× pour le cache de 30 minutes par défaut, et y lire coûte 0,1×. Selon un calcul simplifié, le cache de 12 heures bat à la fois l'absence de cache et un cache de 30 minutes qui expire, dès la troisième réutilisation du même préfixe en 12 heures — mais seulement quand les requêtes sont espacées de plus de 30 minutes. Pour un trafic fréquent, il ajoute un coût, et pour un trafic espacé, le cache par défaut coûte peut-être déjà plus que l'absence de cache.
La décision ne dépend pas de la fonctionnalité. Elle dépend de votre profil de trafic.
Cette semaine, journalisez la fréquence de réutilisation de chaque long préfixe et les intervalles entre les usages. Placez le contenu stable au début de vos prompts. Puis n'activez les 12 heures que pour les préfixes qui reviennent au moins trois fois par jour avec de longs intervalles.
Sources : OpenAI, guide du prompt caching — le cache de 30 minutes par défaut et l'option de 12 heures, le paramètre prompt_cache_options.ttl sur GPT-5.6 et suivants, les prix d'écriture de 1,25× et 2,5× et de lecture de 0,1× (0,05× sur GPT-6.1 Sol), le minimum de 1 024 tokens, la correspondance par préfixe, prompt_cache_key, l'absence de surcoût d'écriture sur les modèles antérieurs et la note sur le stockage local des GPU. OpenAI, journal des modifications de l'API — le lancement du 20 octobre 2026. Runtime Wire — le périmètre de la Responses API, les agents persistants comme usage visé et la citation d'OpenAI Developers sur dots. Les calculs de rentabilité et l'exemple de l'agent de support sont les miens, selon les hypothèses indiquées dans les sections 3 et 4.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.