Gemini 4 Argon est à moitié prix jusqu'au 30 novembre. Testez-le maintenant, mais fixez vos prix au tarif de décembre

By Surya Pratap
23 octobre 2026
8 min read
AI & Technology

23 octobre 2026
8 min read
 Le prix double le 1er décembreHover to explore
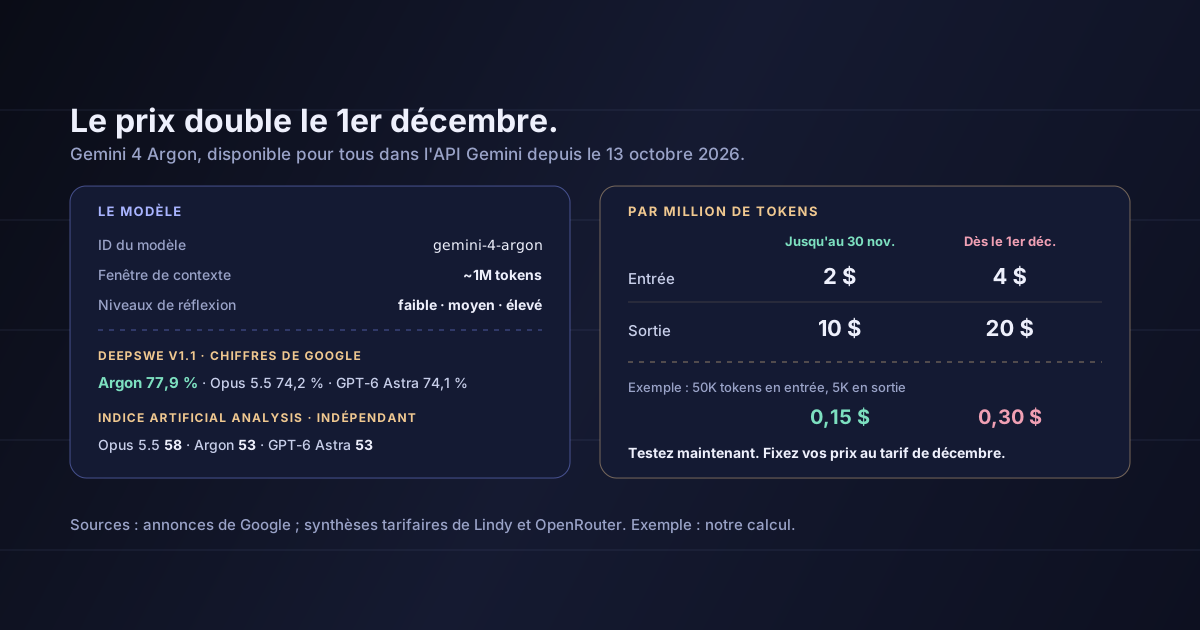
Les nouveaux modèles de pointe arrivent avec deux chiffres que regardent les fondateurs : un score de benchmark et un prix. Gemini 4 Argon en apporte un troisième, plus important : une date. Son prix de lancement court jusqu'au 30 novembre, et le 1er décembre, tous les tarifs par token doublent. Cela change la façon de l'aborder.
Cet article s'appuie sur les annonces de Google « Gemini 4 Argon: our next era of frontier intelligence » et « Gemini 4 Argon is now available for developers », sur les notes de version de l'API Gemini suivies par Releasebot, et sur les synthèses de prix et de caractéristiques de Lindy et d'OpenRouter. La plupart des chiffres de benchmarks viennent de Google lui-même. L'analyse à partir de la section 4 est la mienne.
Google a annoncé Gemini 4 Argon le 30 septembre 2026, en le présentant comme « notre modèle de pointe pour le code en conditions réelles, le travail intellectuel en entreprise et la cyberdéfense ». Il est devenu disponible pour tous le 13 octobre dans l'API Gemini, Google AI Studio, Android Studio et, pour les abonnés Ultra, dans l'environnement de développement Antigravity de Google, sous l'identifiant gemini-4-argon.
Les caractéristiques, telles que résumées à partir de la documentation de Google :
Dans l'application Gemini, il est réservé aux abonnés payants Google AI Pro et Ultra ; les comptes gratuits en sont exclus. Il a aussi été proposé en priorité aux professionnels de la cyberdéfense via le programme Fairwind de Google.
Les chiffres de Google :
| Benchmark | Ce qu'il mesure | Gemini 4 Argon |
|---|---|---|
| DeepSWE v1.1 | Génie logiciel | 77,9 % |
| Vals Index | Travail intellectuel | 68,9 % |
| AutomationBench | Tâches d'automatisation | 51,3 % |
| LVBench | Compréhension de longues vidéos | 91,7 % |
| GraphWalks 256K–1M | Raisonnement sur long contexte | 84,2 % |
Sur DeepSWE, les comptes rendus de la comparaison de Google indiquent 74,2 % pour Claude Opus 5.5 et 74,1 % pour GPT-6 Astra.
Les tests indépendants donnent une image moins tranchée. Sur l'indice d'Artificial Analysis, rapporté par Lindy, Argon obtient 53, à égalité avec GPT-6 Astra, tandis que Claude Opus 5.5 est en tête avec 58.
Google décrit aussi des résultats internes : des agents Argon qui ont aidé à migrer plus de 800 000 lignes du noyau Fuchsia Zircon du C et du C++ vers Rust, et qui ont repéré des optimisations de mémoire libérant plus de 300 Tio dans les centres de données de Google. Ce sont les récits de Google sur son propre travail.
| Jusqu'au 30 novembre 2026 | À partir du 1er décembre 2026 | |
|---|---|---|
| Entrée | 2 $ par million de tokens | 4 $ par million de tokens |
| Sortie | 10 $ par million de tokens | 20 $ par million de tokens |
| Entrée en cache | 0,10 $ par million de tokens | — |
Prenons une étape d'agent typique avec 50 000 tokens en entrée et 5 000 en sortie. Au prix de lancement, elle coûte environ 0,15 dollar. À partir de décembre, environ 0,30 dollar. Une fonctionnalité qui exécute cette étape 20 fois par utilisateur et par jour passe d'environ 3 dollars à environ 6 dollars par utilisateur et par jour.
Le prix de lancement est un bon moment pour tester un modèle et une mauvaise base pour un business plan.
Évaluez maintenant, sur vos tâches. Faites tourner votre propre jeu d'évaluation sur Argon et sur votre modèle actuel tant que les tokens sont bon marché. Comparez la qualité, la latence et le coût par tâche réussie, pas des tableaux de benchmarks. Essayez les trois niveaux de réflexion : le niveau « élevé » ne vaut peut-être pas ses tokens pour vous.
Calculez au tarif de décembre. Si vous adoptez Argon, modélisez vos marges à 4 et 20 dollars. Un plan qui ne tient qu'à 2 et 10 dollars cesse de tenir dans six semaines — et les prix que vous fixez à vos clients en novembre dureront plus longtemps que la remise.
Utilisez le cache pour le long contexte. L'entrée en cache est affichée à 0,10 dollar par million de tokens. Si vous renvoyez sans cesse les mêmes longs documents ou le même code, structurez vos prompts pour que la partie stable vienne en premier. Nous avons détaillé le calcul de rentabilité du cache d'OpenAI ; les mêmes réflexes s'appliquent.
Surveillez la longueur des sorties. Une limite de sortie plus haute est utile pour les migrations, les longs rapports et les gros refactorings, mais la sortie coûte cinq fois plus que l'entrée. Fixez des limites de sortie explicites par fonctionnalité pour qu'une seule longue réponse ne vous réserve pas de mauvaise surprise sur la facture.
Gardez le changement de modèle peu coûteux
Quoi que vous décidiez, gardez le choix du modèle dans la configuration, pas dans le code. Les prix, les classements et les remises de lancement bougent toutes les quelques semaines. Les startups qui en profitent sont celles qui peuvent tester un nouveau modèle en une journée et y basculer une fonctionnalité — ou l'en retirer — avec une évaluation et un changement de configuration.
Pour des tâches courtes et à fort volume, un modèle plus petit et moins cher l'emporte généralement sur le coût. La famille d'Argon comprend elle-même des modèles Flash pour cela.
Qu'Argon est le meilleur modèle pour vous. Les benchmarks de Google lui sont favorables ; un indice indépendant le place au milieu du groupe de tête. Ce sont vos tâches qui tranchent.
Que les prix et les limites sont définitifs. Les chiffres présentés ici viennent des annonces de Google et de synthèses tierces de ses pages de tarifs. Vérifiez les prix en vigueur de l'API Gemini avant de vous engager.
Que les résultats internes de Google sont transposables. Migrer Fuchsia vers Rust avec les ingénieurs et l'infrastructure de Google montre que le modèle sait mener un travail long et structuré. Cela ne dit pas comment il se comportera sur votre code.
Que la sortie par défaut est d'un million de tokens. Elle ne l'est pas : la valeur par défaut est de 65 536. Les sorties plus longues doivent être configurées explicitement, et chaque token supplémentaire est facturé au tarif de sortie.
Gemini 4 Argon est le nouveau modèle de pointe de Google pour le code, les agents et le travail intellectuel, disponible pour tous dans l'API Gemini depuis le 13 octobre 2026, avec une fenêtre de contexte d'environ un million de tokens, des réponses bien plus longues et trois niveaux de réflexion. Les benchmarks de Google le placent en tête ou presque pour le code et le long contexte ; l'indice indépendant d'Artificial Analysis le met au niveau de GPT-6 Astra et derrière Claude Opus 5.5. Il coûte 2 et 10 dollars par million de tokens en entrée et en sortie jusqu'au 30 novembre, puis 4 et 20 à partir du 1er décembre.
Le bon réflexe n'est ni de basculer, ni de l'ignorer. C'est d'utiliser six semaines de tokens à moitié prix pour découvrir, sur vos propres tâches, s'il vaut son prix de décembre.
Avant le 30 novembre, faites tourner votre jeu d'évaluation sur Gemini 4 Argon à chaque niveau de réflexion, comparez le coût par tâche réussie avec votre modèle actuel aux prix de décembre, et décidez seulement ensuite quelles fonctionnalités — s'il y en a — doivent basculer.
Sources : Google, « Gemini 4 Argon: our next era of frontier intelligence » — la description d'Argon, la hausse de la limite de sortie depuis 64K, les chiffres DeepSWE, AutomationBench et LVBench, les affirmations sur Fuchsia, la mémoire et Fairwind, et les prix de lancement et standard. Google, « Gemini 4 Argon is now available for developers » — la disponibilité au 13 octobre dans l'API Gemini, Google AI Studio, Android Studio et Antigravity. Releasebot — la disponibilité générale du 13 octobre et l'identifiant du modèle. Lindy — la date d'annonce du 30 septembre, la disponibilité pour les abonnés, la fenêtre de contexte, la limite de sortie par défaut, les niveaux de réflexion, la date limite des connaissances, les chiffres Vals Index, GraphWalks et autres, le prix de l'entrée en cache et les scores de l'indice d'Artificial Analysis. OpenRouter — le calendrier des prix, les modalités et la longueur de contexte. La comparaison DeepSWE avec Claude Opus 5.5 et GPT-6 Astra est celle rapportée dans la couverture de l'annonce de Google. L'exemple de coût et l'analyse des sections 4 à 6 sont les miens.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.