Google a fait de ses TPU un périphérique PyTorch natif. Pour la plupart des fondateurs, c'est un levier de négociation, pas une migration

By Surya Pratap
22 octobre 2026
8 min read
AI & Technology

22 octobre 2026
8 min read
 Une ligne pour bouger, davantage pour être rapideHover to explore
La plupart des startups d'IA ne se demandent jamais sur quelle puce tourne leur modèle. Elles appellent une API, et le fournisseur décide. Mais de plus en plus hébergent elles-mêmes des modèles à poids ouverts, pour le coût, la confidentialité ou le contrôle — et pour elles, la puce a toujours été Nvidia, parce que c'est là que le code PyTorch tourne sans friction. La publication de Google cette semaine cherche à changer ce choix par défaut.
Cet article s'appuie sur l'annonce de Google Cloud « TorchTPU is now open source: Run native PyTorch on TPUs » et sur les articles de Forkast et de MarkTechPost. Les chiffres de performance et de compatibilité sont ceux de Google et de ses partenaires, sans vérification indépendante. L'analyse à partir de la section 3 est la mienne.
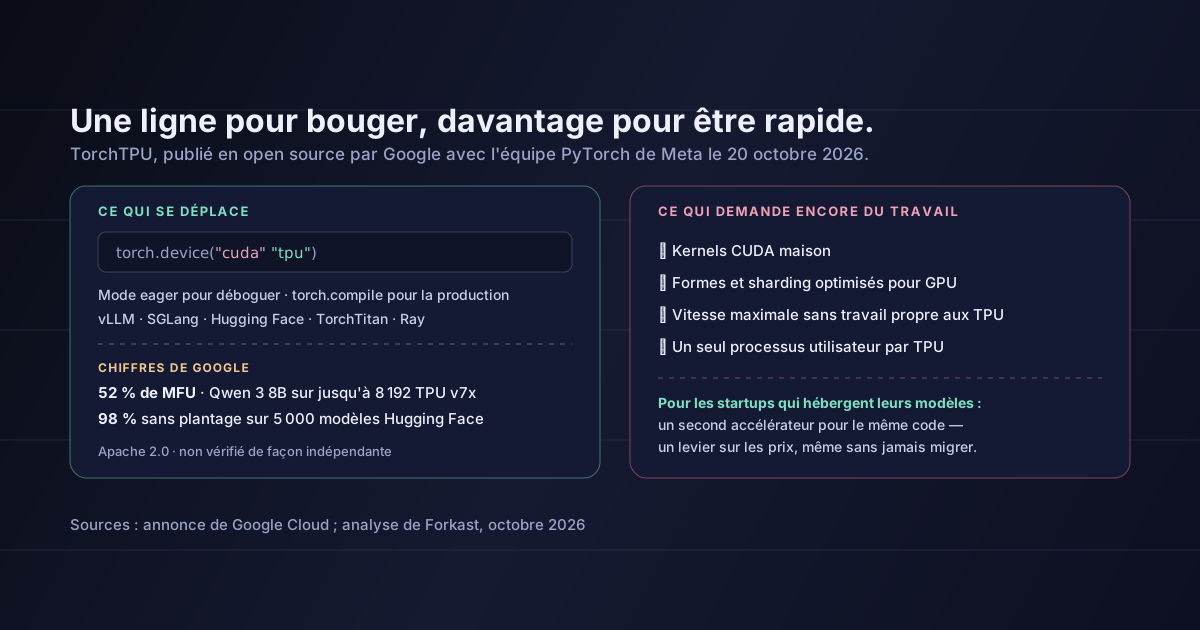
Le 20 octobre 2026, lors de la PyTorch Conference, Google a publié en open source TorchTPU, sa pile PyTorch native pour les Tensor Processing Units. Elle a été développée avec l'équipe PyTorch de Meta et, selon Forkast, est publiée sous licence Apache 2.0.
L'idée centrale : un TPU devient un périphérique PyTorch ordinaire, à côté des GPU et des CPU. Le code qui cible "cuda" peut cibler "tpu" à la place. Google décrit ainsi le flux de travail : « déboguez vos modèles en mode eager, puis passez à des performances de production avec torch.compile ». Les kernels personnalisés s'écrivent en Pallas, le langage de kernels de Google, et non en CUDA.
Une bonne partie de l'écosystème qu'une startup utiliserait réellement est déjà branchée :
device_map="tpu" », ainsi que Diffusers.Google et ses partenaires ont annoncé :
Jana van Greunen, de Meta, y voit « un énorme pas en avant ». Jeff Boudier, de Hugging Face, a déclaré que « la diversité du matériel est essentielle pour rendre l'IA open source accessible à tous ».
Tous ces chiffres viennent du fabricant ou de ses partenaires. Aucun n'a été vérifié de manière indépendante.
Changer de périphérique tient en une ligne. La vitesse, non. L'analyse de Forkast est claire : « on ne peut pas atteindre les performances maximales d'un TPU par un simple changement de périphérique ». En particulier :
Changer de périphérique, c'est une ligne de code. Atteindre les performances maximales sur une autre puce reste de l'ingénierie. La valeur tient au simple fait de pouvoir bouger.
Si vous ne faites qu'appeler des API de modèles, rien ne change directement pour vous. Votre fournisseur choisit ses puces. Tout au plus, plus de concurrence sur le calcul pousse les prix des API à la baisse avec le temps.
Si vous hébergez des modèles à poids ouverts — pour le coût à grand volume, la maîtrise des données ou un modèle affiné maison —, c'est important. Jusqu'ici, le choix réaliste, c'étaient les GPU Nvidia, chez un cloud ou un fournisseur de GPU, à leur prix. Un second accélérateur crédible qui exécute le même code PyTorch et vLLM change cette discussion, même si vous ne migrez jamais.
Si vous entraînez ou affinez des modèles, la prise en charge de TorchTitan et de Hugging Face rend l'essai sur TPU moins coûteux, même si c'est sur les gros entraînements que l'optimisation propre aux TPU rapporte le plus.
Gardez un code indépendant du périphérique. Cherchez dans votre code les "cuda" écrits en dur et remplacez-les par un périphérique configurable. Privilégiez les opérations PyTorch standard et des bibliothèques bien maintenues plutôt que du CUDA écrit à la main, sauf si vous avez mesuré que vous en avez besoin.
Servez vos modèles via des couches portables. Si vous hébergez des modèles, faites tourner l'inférence avec vLLM ou SGLang et chargez les modèles via Hugging Face. Ce sont les couches que TorchTPU prend en charge : le même déploiement peut viser l'un ou l'autre accélérateur.
Mesurez votre propre charge de travail. Faites tourner votre modèle, avec vos longueurs de prompt et vos tailles de lot, sur les deux, et comparez le coût par million de tokens à la latence dont vous avez besoin. Les benchmarks des fabricants utilisent leurs meilleurs cas ; le vôtre est le seul chiffre qui compte.
Servez-vous-en pour négocier. Même un petit benchmark réel sur TPU vous donne une alternative crédible quand vous discutez de remises sur engagement ou de capacité GPU réservée. L'option a de la valeur avant même d'être exercée.
La portabilité, c'est la même habitude partout
Garder le code de vos modèles indépendant d'un seul fabricant de puces, c'est la version matérielle du conseil que nous avons donné après l'ordonnance américaine sur DeepSeek : savoir de quoi dépend votre stack, et faire du remplacement d'un élément un changement de configuration, pas une refonte.
Que les TPU sont désormais plus rapides ou moins chers que les GPU pour vous. Cela dépend de votre modèle, de votre trafic et de vos prix. Les chiffres publiés viennent de Google et de ses partenaires, sur des charges de travail qu'ils ont choisies.
Que le code PyTorch tourne sans modification à pleine vitesse. Il tourne, selon Google, avec des modifications minimes. Obtenir une bonne utilisation demande toujours un travail propre aux TPU.
Que les TPU sont faciles à obtenir. Les TPU sont disponibles via Google Cloud. La disponibilité, les quotas et les prix pour les petites entreprises ne faisaient pas partie de cette annonce.
Que la position de Nvidia a changé. Un backend open source ne fait pas bouger le marché à lui seul. Il réduit un coût de changement, pour les équipes qui hébergent leurs modèles.
Google et Meta ont publié TorchTPU en open source, faisant des TPU de Google un périphérique PyTorch natif sous licence Apache 2.0, avec vLLM, SGLang, Hugging Face, TorchTitan et Ray par-dessus. Google annonce une bonne utilisation et une bonne compatibilité, mais les chiffres sont les siens, et les performances maximales demandent toujours une ingénierie propre aux TPU ; les kernels CUDA maison ne se transposent pas.
Pour les startups qui ne font qu'appeler des API, cela change peu de chose. Pour celles qui hébergent des modèles, cela crée un second accélérateur réaliste pour le même code — ce qui est utile même si vous ne changez jamais.
Si vous hébergez des modèles, supprimez ce sprint les « cuda » écrits en dur dans votre code, servez vos modèles avec vLLM ou SGLang et faites un benchmark de votre propre charge sur TPU. Puis apportez le résultat à votre prochaine discussion sur le prix des GPU.
Sources : Google Cloud, « TorchTPU is now open source: Run native PyTorch on TPUs », octobre 2026 — le développement conjoint avec Meta, le mode eager et torch.compile, les kernels Pallas, les intégrations avec vLLM, SGLang, llm-d, Hugging Face, TorchTitan, Ray, TorchRec et VeRL, la citation sur device_map="tpu", le chiffre de 52 % de MFU sur jusqu'à 8 192 puces TPU v7x, les chiffres de débit de Zenteiq et les citations de Jana van Greunen et de Jeff Boudier. Forkast — la date du 20 octobre, la licence Apache 2.0, le passage de « cuda » à « tpu », les 98 % d'exécutions sans plantage sur 5 000 modèles Hugging Face et les 97 % de parité numérique, ainsi que les limites : performances maximales nécessitant un travail propre aux TPU, kernels CUDA non portables, processus unique en espace utilisateur et jeu d'instructions propriétaire. MarkTechPost — couverture de la publication. L'analyse des sections 3 à 6 est la mienne.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.