Os termos empresariais da Meta deixam os seus crawlers entrar no seu site a partir de 30 de outubro. A Meta tirou «train», não o crawling

By Surya Pratap
19 de outubro de 2026
8 min read
Startup Strategy

19 de outubro de 2026
8 min read
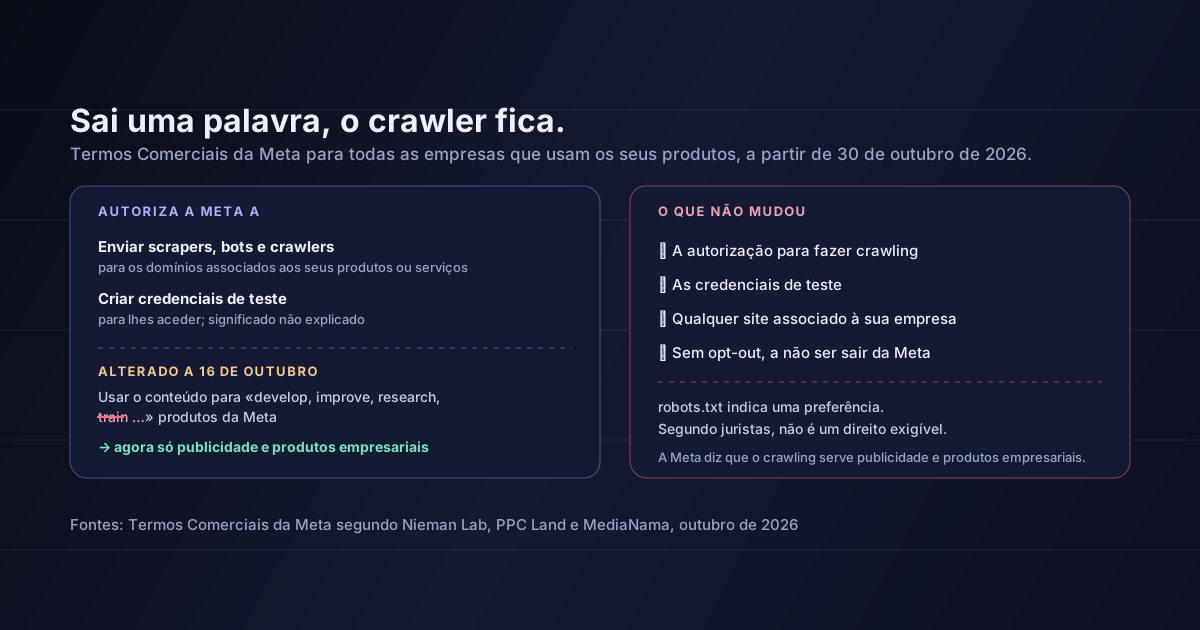 Sai uma palavra, o crawler ficaHover to explore
A maioria dos fundadores aceitou os termos empresariais da Meta sem os ler. Precisava de uma página do Facebook, de um perfil empresarial no Instagram ou de uma conta de anúncios, e os termos vinham com isso. A versão que entra em vigor a 30 de outubro merece ser lida, porque um dos parágrafos é sobre o seu site, não sobre as suas contas na Meta.
Este artigo baseia-se no texto do parágrafo sobre crawling citado pela PPC Land, nas notícias da Nieman Lab (primeiro artigo, seguimento) e na cobertura da MediaNama. Não vi o texto revisto completo; a descrição da alteração vem dessas notícias. A leitura a partir da secção 3 é minha e não constitui aconselhamento jurídico.
Os Termos Comerciais da Meta aplicam-se às empresas que usam os seus produtos para fins comerciais: páginas do Facebook, contas empresariais do Instagram, Meta Business Suite, publicidade. A versão prevista para 30 de outubro continha este parágrafo, reproduzido aqui na redação original em inglês:
"You authorise us (or any entity acting on our behalf) to use automated software (such as web scrapers, bots, robots, spiders, crawlers and user agents) and create test credentials to access, index, cache, analyse, collect, retrieve or crawl the domains, web pages or URLs (and any content available through them) that are associated with your products or services, or that are made available through your or users' use of Meta Company Products and services, and to periodically pull updates from such domains, web pages or URLs. Meta may use any content from such domains, web pages or URLs to provide, develop, improve, research, train and maintain the integrity of, the Meta Company Products, services and features provided under these Commercial Terms and any other applicable supplemental terms."
No texto, os user agents são agentes de software que visitam um site de forma automática.
Há três partes que importam:
A 15 de outubro, a Nieman Lab publicou a opinião de três juristas segundo a qual o parágrafo, tal como estava escrito, podia servir para defender que a Meta pode fazer scraping de sites de notícias e usar o conteúdo para treinar a sua IA. Quase todas as organizações de notícias têm uma conta empresarial na Meta. O porta-voz da Meta Andy Stone classificou de «falsas» as notícias de que os termos permitiriam fazer scraping de sites de notícias.
A 16 de outubro, a Meta reviu os termos. Segundo as notícias, a empresa:
Um porta-voz da Meta disse: «Ouvimos-vos e queremos esclarecer: os termos de crawling que consolidámos só se aplicavam aos nossos produtos de publicidade e empresariais», acrescentando que «os proprietários de conteúdo podem usar o robots.txt para indicar as suas preferências».
A revisão mudou o que a Meta diz que vai fazer com o conteúdo. Segundo as notícias, não mudou a autorização para o recolher:
Os juristas não ficaram tranquilos. James Grimmelmann, da Universidade de Cornell, disse à Nieman Lab que a redação revista continuava suficientemente ampla para abranger o treino de IA. Benjamin Sobel, da Universidade do Wisconsin, lembrou que o robots.txt exprime uma preferência mas não cria um direito exigível de impedir o scraping. Associações de editores europeias, britânicas e norte-americanas pediram a intervenção dos reguladores.
A Meta tirou a palavra que descrevia o que pode fazer com o seu conteúdo. Manteve o parágrafo que lhe permite recolhê-lo.
Isto não é só um problema dos editores. Se tem uma página do Facebook, uma conta empresarial do Instagram ou anúncios na Meta, é parte destes termos, e o seu site está «associado aos seus produtos ou serviços».
Mapeie o que está acessível. Liste os domínios ligados às suas contas e anúncios na Meta: site de marketing, documentação, blogue, centro de ajuda, app. Decida quais aceita que um terceiro faça crawling, guarde em cache e analise ao abrigo de termos que não negociou.
Separe o marketing do produto. Mantenha o produto no seu próprio subdomínio e atrás da sua própria autenticação. Uma conta de teste criada pelo crawler de outra empresa não deve conseguir ver dados de clientes, preços negociados em privado ou qualquer coisa atrás de um início de sessão que não mostraria a um desconhecido.
Indique a sua preferência na mesma. O robots.txt não é exigível, mas é o sinal para o qual a própria Meta remete. Defina regras para os crawlers publicados pela Meta, e para os crawlers de IA em geral, nos domínios que importam. Depois verifique os registos do servidor para ver o que chega de facto.
Esteja atento a registos desconhecidos. «Credenciais de teste» significa contas. Procure registos e inícios de sessão que não se comportem como clientes, e decida antecipadamente o que fará se se revelarem automatizados.
Leia os termos que aceitou sem ler
Crie um lembrete para ler os termos empresariais de cada plataforma de que depende — Meta, Google, LinkedIn, o seu fornecedor de pagamentos, a sua cloud — sempre que mudarem. As cláusulas que importam a uma startup na era da IA são sobre crawling, uso de conteúdo e treino, e estão cada vez mais em termos que aceitou para fazer anúncios, e não num contrato que negociou.
Se o seu conteúdo é o seu produto — uma base de conhecimento, um conjunto de dados, investigação original, artigos pagos —, isto pesa ainda mais. O nosso manual de GEO trata de ser citado pelos sistemas de IA; esta é a outra face da mesma questão: ser recolhido por eles sem que lhe peçam.
Alguns fundadores leem esta história do outro lado. Se o seu produto depende de fazer crawling de sites alheios, repare no que aconteceu: uma empresa com o peso da Meta incluiu o consentimento para crawling e treino em termos que os clientes não podiam negociar, e as críticas obrigaram-na a mudá-los num dia.
A lição não é sobre a posição jurídica da Meta, que os advogados contestam. É que o consentimento escondido nos termos de uma plataforma é frágil, pública e comercialmente. Dados de treino licenciados, ou para os quais os proprietários deram consentimento claro, demoram mais a obter e são muito mais difíceis de lhe tirarem. E se um regulador perguntar, como a FTC acabou de perguntar à OpenAI e à Anthropic, se as suas afirmações batem certo com a sua prática, «os termos permitiam-no» é uma resposta fraca.
Que a Meta está a treinar IA com o seu site. A Meta diz que o crawling se aplica apenas a publicidade e produtos empresariais, e classificou de falsas as notícias sobre o scraping de sites de notícias. Os termos definem o que a Meta pode fazer, não o que faz.
Que os termos revistos permitem o treino de IA. Alguns juristas acham que a redação continua suficientemente ampla; a Meta discorda. Nenhum tribunal se pronunciou.
Que conheço a redação final. O texto revisto é descrito aqui a partir das notícias; verifique os termos que a Meta publicar antes de 30 de outubro.
Que o robots.txt o protege. Indica uma preferência. Como notou Sobel, não cria um direito exigível.
A partir de 30 de outubro, todas as empresas que usam produtos da Meta autorizam a Meta a enviar scrapers e crawlers, e a criar credenciais de teste, para os sites associados aos seus produtos. A Meta reservava-se inicialmente o direito de usar esse conteúdo para treinar os seus produtos; depois das notícias da Nieman Lab, retirou «train» e limitou o uso a publicidade e produtos empresariais. O crawling, as credenciais de teste, o âmbito alargado e a ausência de opt-out mantêm-se, e os juristas dizem que a redação revista continua ampla.
Para as startups, a conclusão prática é simples. A exposição do seu site depende agora, em parte, de termos que aceitou para ter uma página do Facebook.
Antes de 30 de outubro, liste todos os domínios ligados às suas contas na Meta, ponha tudo o que for sensível atrás da sua própria autenticação, defina no robots.txt as suas preferências para os crawlers da Meta e de outras empresas de IA, e comece a vigiar os registos do servidor e os registos de utilizadores à procura de visitantes automatizados.
Fontes: PPC Land — o texto completo do parágrafo sobre crawling tal como publicado originalmente para 30 de outubro de 2026, a quem se aplica e a recusa da Meta em explicar as credenciais de teste. Nieman Lab, 15 de outubro de 2026 — a leitura dos três juristas. Nieman Lab — a revisão e a opinião dos especialistas de que continua ampla. MediaNama — a remoção de «train», a limitação a publicidade e produtos empresariais, a declaração do porta-voz da Meta sobre o robots.txt, os comentários de James Grimmelmann e Benjamin Sobel, a ausência de opt-out e os apelos das associações de editores. A data de revisão de 16 de outubro, o comentário de Andy Stone sobre notícias «falsas» e o uso quase universal de contas empresariais da Meta pelas organizações de notícias vêm da cobertura dos artigos da Nieman Lab. A leitura das secções 3 a 6 é minha e não constitui aconselhamento jurídico.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.