O Gemini 4 Argon está a metade do preço até 30 de novembro. Teste-o já, mas defina os seus preços à tarifa de dezembro

By Surya Pratap
23 de outubro de 2026
8 min read
AI & Technology

23 de outubro de 2026
8 min read
 O preço duplica a 1 de dezembroHover to explore
Os novos modelos de fronteira chegam com dois números em que os fundadores reparam: uma pontuação num benchmark e um preço. O Gemini 4 Argon traz um terceiro, que importa mais: uma data. O preço de lançamento dura até 30 de novembro, e a 1 de dezembro todas as tarifas por token duplicam. Isso muda a forma como o deve abordar.
Este artigo baseia-se nos anúncios da Google «Gemini 4 Argon: our next era of frontier intelligence» e «Gemini 4 Argon is now available for developers», nas notas de versão da Gemini API acompanhadas pela Releasebot e nos resumos de preços e especificações da Lindy e da OpenRouter. A maioria dos números de benchmarks é da própria Google. A leitura a partir da secção 4 é minha.
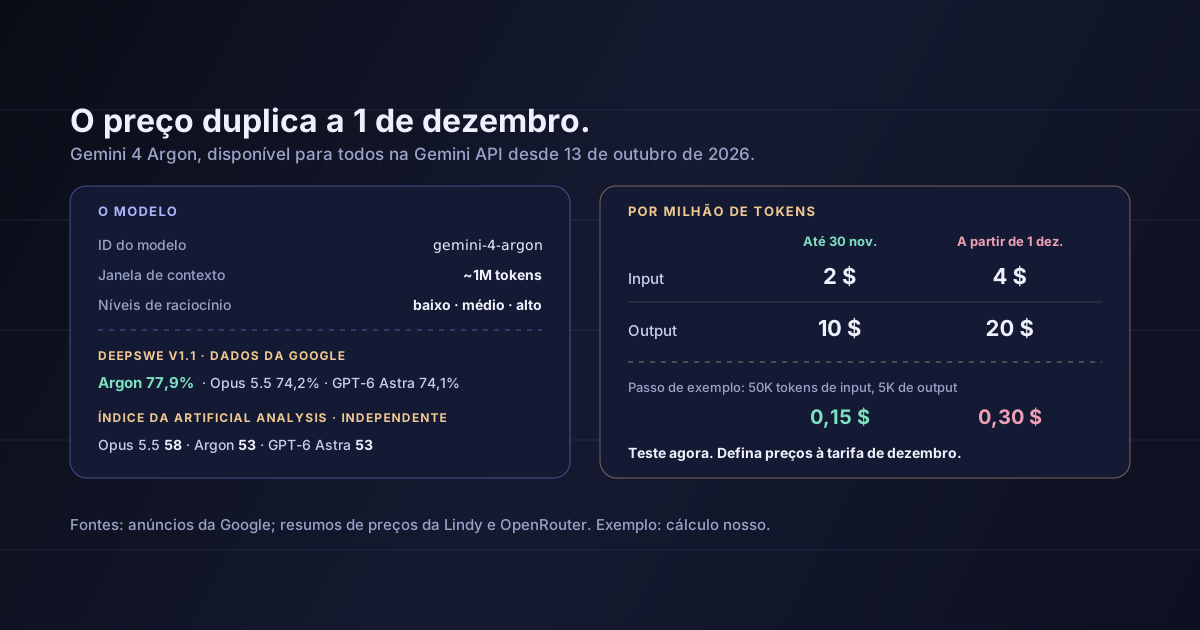
A Google anunciou o Gemini 4 Argon a 30 de setembro de 2026, descrevendo-o como «o nosso modelo de fronteira para programação no mundo real, trabalho do conhecimento nas empresas e ciberdefesa». Ficou disponível para todos a 13 de outubro na Gemini API, no Google AI Studio, no Android Studio e, para os subscritores Ultra, no ambiente de programação Antigravity da Google, com o ID de modelo gemini-4-argon.
As especificações, resumidas a partir da documentação da Google:
Na app Gemini está disponível para os subscritores pagos do Google AI Pro e Ultra; as contas gratuitas ficam de fora. Também chegou primeiro aos profissionais de ciberdefesa, através do programa Fairwind da Google.
Os números da própria Google:
| Benchmark | O que mede | Gemini 4 Argon |
|---|---|---|
| DeepSWE v1.1 | Engenharia de software | 77,9% |
| Vals Index | Trabalho do conhecimento | 68,9% |
| AutomationBench | Tarefas de automação | 51,3% |
| LVBench | Compreensão de vídeos longos | 91,7% |
| GraphWalks 256K–1M | Raciocínio com contexto longo | 84,2% |
No DeepSWE, a cobertura da comparação da Google indica 74,2% para o Claude Opus 5.5 e 74,1% para o GPT-6 Astra.
Os testes independentes dão uma imagem menos favorável. No índice da Artificial Analysis, segundo a Lindy, o Argon obtém 53, empatado com o GPT-6 Astra, enquanto o Claude Opus 5.5 lidera com 58.
A Google descreve também resultados internos: agentes Argon que ajudaram a migrar mais de 800 000 linhas do kernel Fuchsia Zircon de C e C++ para Rust, e que identificaram otimizações de memória que libertaram mais de 300 TiB nos centros de dados da Google. São relatos da Google sobre o seu próprio trabalho.
| Até 30 de novembro de 2026 | A partir de 1 de dezembro de 2026 | |
|---|---|---|
| Input | 2 $ por milhão de tokens | 4 $ por milhão de tokens |
| Output | 10 $ por milhão de tokens | 20 $ por milhão de tokens |
| Input em cache | 0,10 $ por milhão de tokens | — |
Considere um passo típico de um agente com 50 000 tokens de input e 5000 de output. Ao preço de lançamento custa cerca de 0,15 dólares. A partir de dezembro, cerca de 0,30. Uma funcionalidade que executa esse passo 20 vezes por utilizador e por dia passa de cerca de 3 dólares para cerca de 6 dólares por utilizador e por dia.
O preço de lançamento é uma boa altura para testar um modelo e uma má base para um plano de negócio.
Avalie já, nas suas tarefas. Corra o seu próprio conjunto de avaliação no Argon e no seu modelo atual enquanto os tokens são baratos. Compare qualidade, latência e custo por tarefa concluída com sucesso, e não tabelas de benchmarks. Experimente os três níveis de raciocínio; o «alto» pode não compensar os seus tokens no seu caso.
Faça as contas à tarifa de dezembro. Se adotar o Argon, modele as suas margens a 4 e 20 dólares. Um plano que só funciona a 2 e 10 deixa de funcionar daqui a seis semanas — e os preços que fixar aos clientes em novembro vão durar mais do que o desconto.
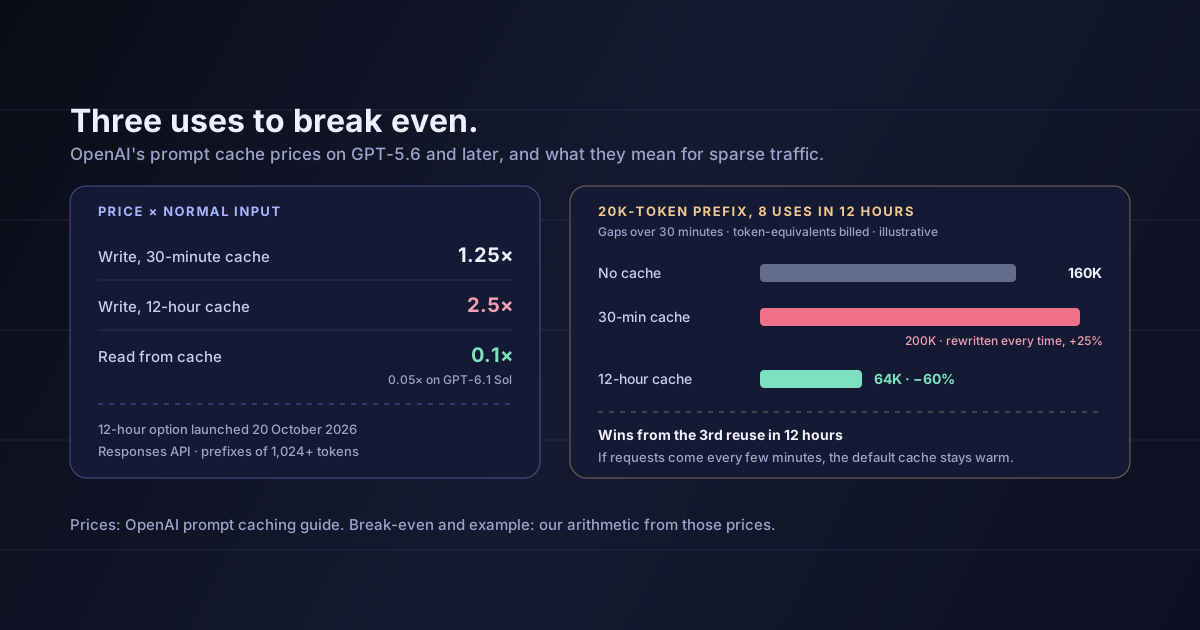
Use a cache para contexto longo. O input em cache está listado a 0,10 dólares por milhão de tokens. Se envia repetidamente os mesmos documentos longos ou o mesmo código, estruture os prompts para que a parte estável venha primeiro. Já fizemos as contas do ponto de equilíbrio da cache da OpenAI; os mesmos hábitos aplicam-se.
Controle o tamanho do output. Um limite de output mais alto é útil para migrações, relatórios longos e grandes refactorings, mas o output custa cinco vezes mais do que o input. Defina limites de output explícitos por funcionalidade, para que uma única resposta longa não surpreenda a sua fatura.
Mantenha barata a troca de modelo
Decida o que decidir, mantenha a escolha do modelo na configuração, e não no código. Preços, classificações e descontos de lançamento mudam a cada poucas semanas. As startups que ganham com isso são as que conseguem testar um modelo novo num dia e passar uma funcionalidade para ele — ou tirá-la dele — com uma avaliação e uma alteração de configuração.
Para tarefas curtas e de grande volume, um modelo mais pequeno e barato costuma ganhar em custo. A própria família do Argon inclui modelos Flash para isso.
Que o Argon é o melhor modelo para si. Os benchmarks da Google favorecem-no; um índice independente coloca-o a meio do grupo de fronteira. As suas tarefas é que decidem.
Que os preços e os limites são definitivos. Os números aqui vêm dos anúncios da Google e de resumos de terceiros das suas páginas de preços. Confirme os preços em vigor da Gemini API antes de se comprometer.
Que os resultados internos da Google são transferíveis. Migrar o Fuchsia para Rust com os engenheiros e a infraestrutura da Google mostra que o modelo consegue fazer trabalho longo e estruturado. Não diz como se vai sair no seu código.
Que o output predefinido é de um milhão de tokens. Não é: o predefinido é 65 536. Outputs mais longos têm de ser configurados explicitamente, e cada token adicional é faturado à tarifa de output.
O Gemini 4 Argon é o novo modelo de fronteira da Google para código, agentes e trabalho do conhecimento, disponível para todos na Gemini API desde 13 de outubro de 2026, com uma janela de contexto de cerca de um milhão de tokens, respostas muito mais longas e três níveis de raciocínio. Os benchmarks da Google colocam-no no topo ou perto em código e contexto longo; o índice independente da Artificial Analysis coloca-o ao nível do GPT-6 Astra e atrás do Claude Opus 5.5. Custa 2 e 10 dólares por milhão de tokens de input e de output até 30 de novembro, e 4 e 20 a partir de 1 de dezembro.
A jogada útil não é mudar nem ignorá-lo. É usar seis semanas de tokens a metade do preço para descobrir, nas suas próprias tarefas, se ele vale o preço de dezembro.
Antes de 30 de novembro, corra o seu conjunto de avaliação no Gemini 4 Argon em cada nível de raciocínio, compare o custo por tarefa concluída com o seu modelo atual aos preços de dezembro e só depois decida que funcionalidades — se alguma — devem mudar.
Fontes: Google, «Gemini 4 Argon: our next era of frontier intelligence» — a descrição do Argon, o aumento do limite de output a partir de 64K, os valores do DeepSWE, AutomationBench e LVBench, as afirmações sobre o Fuchsia, a memória e o Fairwind, e os preços de lançamento e normal. Google, «Gemini 4 Argon is now available for developers» — a disponibilidade a partir de 13 de outubro na Gemini API, no Google AI Studio, no Android Studio e no Antigravity. Releasebot — a disponibilidade geral a 13 de outubro e o ID do modelo. Lindy — a data de anúncio de 30 de setembro, a disponibilidade para subscritores, a janela de contexto, o limite de output predefinido, os níveis de raciocínio, a data-limite do conhecimento, os valores do Vals Index, GraphWalks e outros benchmarks, o preço do input em cache e as pontuações do índice da Artificial Analysis. OpenRouter — o calendário de preços, as modalidades e o comprimento de contexto. A comparação no DeepSWE com o Claude Opus 5.5 e o GPT-6 Astra é a noticiada na cobertura do anúncio da Google. O exemplo de custo e a leitura das secções 4 a 6 são meus.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.