Escrever na cache de 12 horas da OpenAI custa 2,5×. No papel, compensa a partir do terceiro pedido

By Surya Pratap
21 de outubro de 2026
8 min read
AI & Technology

21 de outubro de 2026
8 min read
 Três usos para compensarHover to explore
O prompt caching é uma das poucas alavancas que reduzem a fatura de um produto de IA sem mexer na qualidade. A nova opção da OpenAI faz a cache durar muito mais, a troco de um preço mais alto para escrever nela. Se isso lhe poupa dinheiro depende de algo que a maioria das equipas nunca mediu: quanto tempo passa entre os pedidos que partilham o mesmo prompt.
Este artigo baseia-se no guia de prompt caching e no registo de alterações da OpenAI, e na cobertura da Runtime Wire. Os preços são os multiplicadores publicados pela OpenAI para o GPT-5.6 e posteriores. Os pontos de equilíbrio das secções 3 e 4 são contas minhas a partir desses multiplicadores, com os pressupostos simplificados aí indicados, e não da OpenAI.
A 20 de outubro de 2026, a OpenAI deixou os programadores ativar uma cache de prompts de 12 horas na Responses API, ao lado da cache de 30 minutos que já vinha por predefinição. A OpenAI apresentou-a a pensar em agentes persistentes: «Os agentes persistentes, como o dots, reutilizam contexto ao longo do dia», escreveu a sua conta para programadores.
No GPT-5.6 e posteriores, define-se com prompt_cache_options.ttl em "12h" em vez do valor predefinido "30m". Ambos são tempos de vida mínimos.
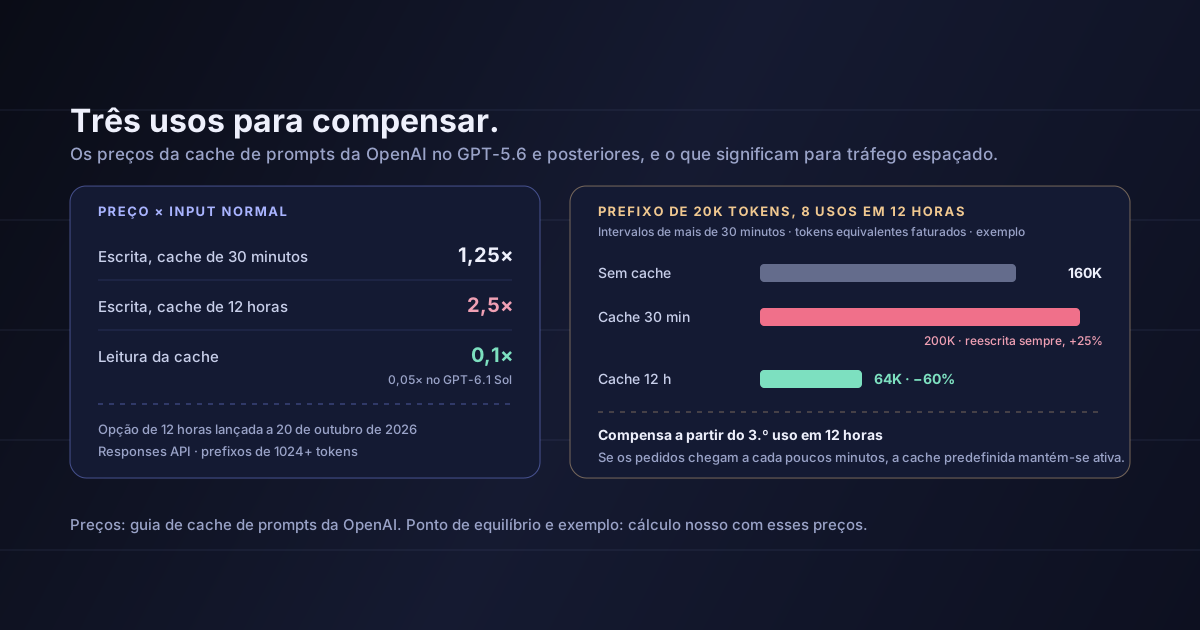
Para o GPT-5.6 e posteriores, como múltiplos do preço normal (sem cache) dos tokens de input:
| Preço | |
|---|---|
| Escrita, cache de 30 minutos | 1,25× |
| Escrita, cache de 12 horas | 2,5× |
| Leitura da cache | 0,1× (0,05× no GPT-6.1 Sol) |
Há outras três regras que importam:
prompt_cache_key opcional mantém caches separadas por cliente ou utilizador.Nos modelos anteriores não há custo adicional por escrever na cache, e as opções de retenção são diferentes.
Tome um prefixo — prompt de sistema, definições de ferramentas, material de referência — de tamanho P, reutilizado N vezes em 12 horas. Deixe de fora os tokens de output e a parte de cada prompt que muda; custam o mesmo em todos os casos.
Resolvendo para saber quando a cache de 12 horas fica mais barata do que não usar cache, obtém-se N > 2,7. Face a uma cache de 30 minutos que está sempre a expirar, N > 2,1. Ou seja: com estes pressupostos simplificados, a partir do terceiro uso do mesmo prefixo em 12 horas, a cache de 12 horas ganha — desde que os intervalos sejam suficientemente longos para a cache predefinida ter expirado.
Quando os pedidos chegam a cada poucos minutos, a cache predefinida nunca arrefece, e a opção de 12 horas custa simplesmente mais 1,25 × P por janela, sem ganho nenhum.
Uma cache mais longa só poupa dinheiro quando os intervalos entre os seus pedidos são mais longos do que a duração da cache predefinida.
Um agente de apoio de exemplo tem um prefixo de 20 000 tokens: instruções, esquemas de ferramentas e um manual do produto. Um cliente usa-o 8 vezes ao longo de um dia de trabalho, mais ou menos uma vez a cada uma ou duas horas. Input faturado pelo prefixo, em tokens equivalentes:
É um corte de 60% face a não usar cache no prefixo — e mostra algo menos óbvio: com tráfego espaçado como este, a cache predefinida pode custar 25% mais do que não usar cache nenhuma, porque paga o acréscimo de escrita sem nunca chegar a ler.
Se cada cliente tiver o seu próprio material de referência no prefixo, cada um precisa da sua própria escrita. A poupança continua a aplicar-se por cliente, mas só para os clientes que voltam três ou mais vezes dentro da janela.
Provavelmente compensa. Assistentes e agentes usados algumas vezes por dia por cliente, com instruções ou documentos longos e estáveis: copilotos internos, assistentes de conta, agentes agendados que acordam a cada uma ou duas horas, ferramentas B2B usadas aos bocados ao longo do dia de trabalho.
Provavelmente não compensa. Funcionalidades com muito tráfego em que o mesmo prefixo é usado a cada poucos minutos — a cache predefinida já se mantém ativa. Também não compensa em pedidos pontuais, prompts com menos de 1024 tokens nem prompts cujo início muda a cada chamada.
Corrija primeiro o prefixo. Ponha no início tudo o que é estável — instruções, definições de ferramentas, material de referência — e no fim tudo o que muda. Uma marca temporal na primeira linha do prompt de sistema anula silenciosamente qualquer duração de cache.
Meça antes de mudar. Registe, por prefixo, quantas vezes é reutilizado e os intervalos entre usos, e veja as contagens de tokens em cache que a API devolve. Ligue as 12 horas só para os prefixos que encaixam mesmo nesse padrão, e não para tudo.
Verifique quanto lhe custa a cache predefinida
Se passou para o GPT-5.6 ou posterior e o seu tráfego por prefixo é espaçado, veja a sua fatura agora. A escrita a 1,25× da cache predefinida passa facilmente despercebida e, com pedidos espaçados de mais de 30 minutos, é puro custo extra. É um custo que talvez já esteja a pagar, antes de decidir o que quer que seja sobre as 12 horas.
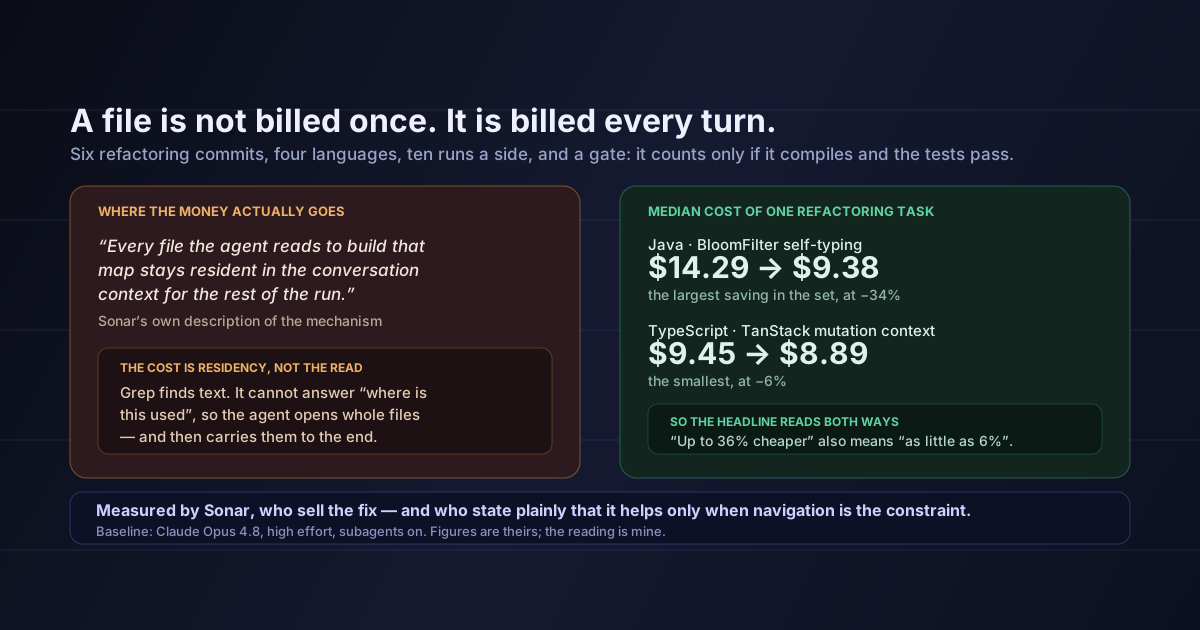
O contexto longo e repetido é o maior custo escondido dos produtos com agentes, como vimos quando um único refactoring custou 14,29 dólares em tokens. A cache é a solução mais barata — mas só quando corresponde à forma como os seus utilizadores realmente se comportam.
Que a cache de 12 horas dura sempre 12 horas, ou que as leituras em cache estão garantidas. A OpenAI descreve ambos os tempos de vida como mínimos, e uma cache pode falhar na mesma. A poupança real será um pouco menor do que a das contas.
Que os pontos de equilíbrio são da OpenAI. São contas minhas a partir dos multiplicadores publicados, assumindo prefixos idênticos e sem contar correspondências parciais.
Que estes preços se aplicam a todos os modelos. Aplicam-se ao GPT-5.6 e posteriores; os modelos anteriores não têm acréscimo de escrita e têm outras opções de retenção, e o GPT-6.1 Sol lê a 0,05×.
Que a cache é adequada a dados sensíveis sem verificação. A OpenAI refere que os dados em cache podem ficar guardados em armazenamento local das GPU. Se tem compromissos de retenção de dados, verifique como a cache encaixa neles antes de a alongar.
A OpenAI oferece agora uma cache de prompts de 12 horas na Responses API. No GPT-5.6 e posteriores, escrever nela custa 2,5× o preço de input, contra 1,25× na cache predefinida de 30 minutos, e ler custa 0,1×. Em contas simplificadas, a cache de 12 horas bate tanto a ausência de cache como uma cache de 30 minutos que expira, a partir da terceira reutilização do mesmo prefixo em 12 horas — mas só quando os pedidos têm mais de 30 minutos de intervalo. Com tráfego frequente, acrescenta custo; com tráfego espaçado, a cache predefinida pode já estar a custar mais do que não usar cache.
A decisão não depende da funcionalidade. Depende do seu padrão de tráfego.
Esta semana, registe com que frequência cada prefixo longo é reutilizado e os intervalos entre usos. Passe o conteúdo estável para o início dos seus prompts. Depois, ligue as 12 horas só para os prefixos que voltam três ou mais vezes por dia com intervalos longos.
Fontes: OpenAI, guia de prompt caching — a cache predefinida de 30 minutos e a opção de 12 horas, o parâmetro prompt_cache_options.ttl no GPT-5.6 e posteriores, os preços de escrita de 1,25× e 2,5× e de leitura de 0,1× (0,05× no GPT-6.1 Sol), o mínimo de 1024 tokens, a correspondência por prefixos, prompt_cache_key, a ausência de acréscimo de escrita nos modelos anteriores e a nota sobre o armazenamento local das GPU. OpenAI, registo de alterações da API — o lançamento de 20 de outubro de 2026. Runtime Wire — o âmbito da Responses API, os agentes persistentes como uso previsto e a citação da OpenAI Developers sobre o dots. As contas de equilíbrio e o exemplo do agente de apoio são meus, com os pressupostos indicados nas secções 3 e 4.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.