A Google transformou as suas TPU num dispositivo nativo do PyTorch. Para a maioria dos fundadores, é um trunfo negocial, não uma migração

By Surya Pratap
22 de outubro de 2026
8 min read
AI & Technology

22 de outubro de 2026
8 min read
 Uma linha para mudar, mais trabalho para ser rápidoHover to explore
A maioria das startups de IA nunca pensa em que chip corre o seu modelo. Chamam uma API, e o fornecedor decide. Mas cada vez mais alojam modelos de pesos abertos por custo, privacidade ou controlo — e para essas, o chip tem sido a Nvidia, porque é aí que o código PyTorch corre sem atrito. O lançamento da Google desta semana é uma tentativa de mudar essa opção por omissão.
Este artigo baseia-se no anúncio da Google Cloud «TorchTPU is now open source: Run native PyTorch on TPUs» e na cobertura da Forkast e da MarkTechPost. Os números de desempenho e compatibilidade são da Google e dos seus parceiros, sem verificação independente. A leitura a partir da secção 3 é minha.
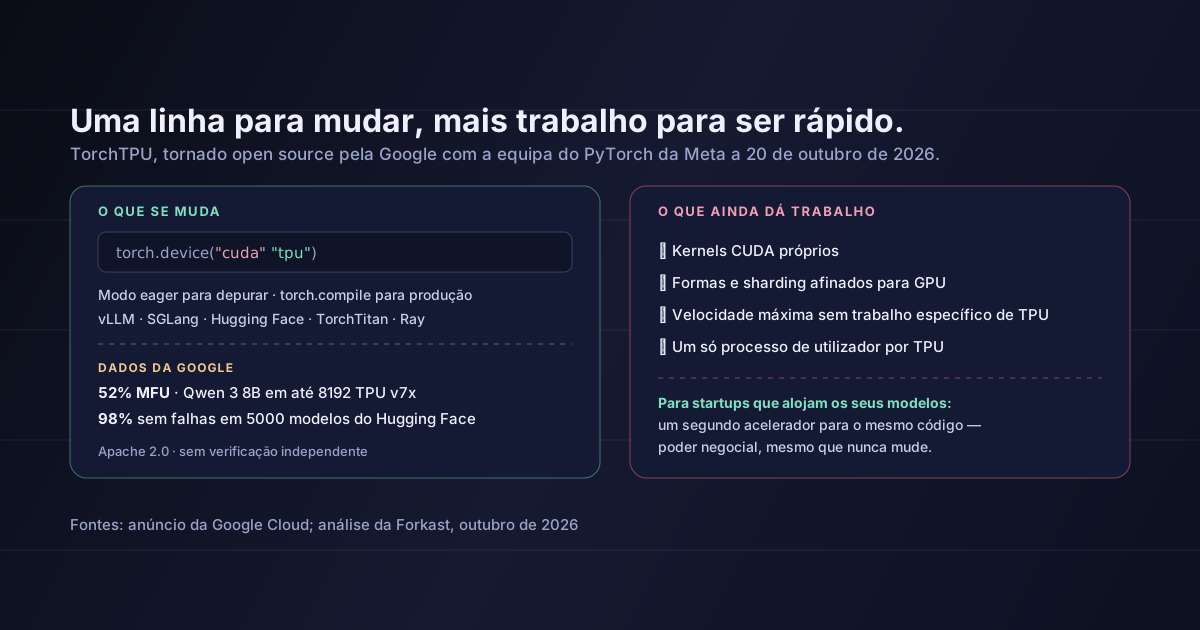
A 20 de outubro de 2026, na PyTorch Conference, a Google tornou open source o TorchTPU, a sua stack nativa do PyTorch para as Tensor Processing Units. Foi desenvolvido com a equipa do PyTorch da Meta e, segundo a Forkast, é publicado sob licença Apache 2.0.
A ideia central é que uma TPU passa a ser um dispositivo PyTorch comum, ao lado das GPU e das CPU. O código que aponta para "cuda" pode apontar para "tpu". A Google descreve o fluxo de trabalho assim: «depure os seus modelos em modo eager e depois passe para desempenho de produção com torch.compile». Os kernels próprios escrevem-se em Pallas, a linguagem de kernels da Google, em vez de CUDA.
Grande parte do ecossistema que uma startup realmente usaria já está ligada:
device_map="tpu"», além do Diffusers.A Google e os seus parceiros indicaram:
Jana van Greunen, da Meta, chamou-lhe «um enorme passo em frente». Jeff Boudier, da Hugging Face, disse que «a diversidade de hardware é essencial para tornar a IA open source acessível a todos».
Todos estes números são do fabricante ou de parceiros. Nenhum foi testado de forma independente.
Mudar o dispositivo é uma linha. A velocidade, não. A análise da Forkast é direta: «não se consegue o desempenho máximo de uma TPU com uma simples troca de dispositivo». Em concreto:
Mudar o dispositivo é uma linha de código. Tirar o máximo de outro chip continua a ser engenharia. O valor está em poder mudar.
Se só chama API de modelos, nada muda diretamente para si. O seu fornecedor escolhe os chips. Quando muito, mais concorrência na computação empurra os preços das API para baixo com o tempo.
Se aloja modelos de pesos abertos — por custo em grande volume, controlo dos dados ou um modelo próprio com fine-tuning —, isto importa. Até agora, a opção realista eram as GPU da Nvidia, numa cloud ou num fornecedor de GPU, ao preço deles. Um segundo acelerador credível que corre o mesmo código PyTorch e vLLM muda essa conversa, mesmo que nunca mude.
Se treina ou faz fine-tuning, o suporte do TorchTitan e do Hugging Face torna mais barato experimentar em TPU, embora seja nos grandes treinos que a afinação específica para TPU compensa mais.
Mantenha o código independente do dispositivo. Procure no seu código "cuda" escrito de forma fixa e substitua-o por um dispositivo configurável. Prefira operações PyTorch padrão e bibliotecas bem suportadas a CUDA escrito à mão, a menos que tenha medido que precisa dele.
Disponibilize os modelos através de camadas portáveis. Se aloja modelos, faça a inferência com vLLM ou SGLang e carregue os modelos através do Hugging Face. São as camadas que o TorchTPU suporta, por isso a mesma implementação pode apontar para qualquer um dos aceleradores.
Meça a sua própria carga de trabalho. Corra o seu modelo, com os seus comprimentos de prompt e tamanhos de lote, nos dois, e compare o custo por milhão de tokens à latência de que precisa. Os benchmarks dos fabricantes usam os melhores casos deles; o seu é o único número que importa.
Use-o para negociar. Mesmo um benchmark pequeno e real em TPU dá-lhe uma alternativa credível quando discute descontos por compromisso de utilização ou capacidade de GPU reservada. A opção tem valor antes de ser exercida.
A portabilidade é o mesmo hábito em todo o lado
Manter o código dos seus modelos livre de um único fabricante de chips é a versão de hardware do conselho que demos depois da ordem dos EUA sobre a DeepSeek: saber de que depende a sua stack e fazer com que trocar uma peça seja uma alteração de configuração, e não uma reconstrução.
Que as TPU são agora mais rápidas ou mais baratas do que as GPU para si. Depende do seu modelo, do seu tráfego e dos seus preços. Os números publicados vêm da Google e dos parceiros, em cargas de trabalho escolhidas por eles.
Que o código PyTorch corre sem alterações à velocidade máxima. Corre, segundo a Google, com alterações mínimas. Conseguir uma boa utilização continua a exigir trabalho específico para TPU.
Que as TPU são fáceis de obter. As TPU estão disponíveis através da Google Cloud. A disponibilidade, as quotas e os preços para empresas pequenas não fizeram parte deste anúncio.
Que a posição da Nvidia mudou. Um backend open source não move o mercado sozinho. Reduz um custo de mudança, para as equipas que alojam os seus modelos.
A Google e a Meta tornaram open source o TorchTPU, fazendo das TPU da Google um dispositivo nativo do PyTorch sob licença Apache 2.0, com vLLM, SGLang, Hugging Face, TorchTitan e Ray por cima. A Google indica boa utilização e compatibilidade, mas os números são seus, e o desempenho máximo continua a exigir engenharia específica para TPU; os kernels CUDA próprios não passam.
Para startups que só chamam API, muda pouco. Para as que alojam modelos, cria um segundo acelerador realista para o mesmo código — o que é útil mesmo que nunca mude.
Se aloja modelos, retire neste sprint o «cuda» fixo do seu código, disponibilize os modelos com vLLM ou SGLang e faça um benchmark da sua própria carga em TPU. Depois, leve o resultado para a próxima conversa sobre o preço das GPU.
Fontes: Google Cloud, «TorchTPU is now open source: Run native PyTorch on TPUs», outubro de 2026 — o desenvolvimento conjunto com a Meta, o modo eager e o torch.compile, os kernels Pallas, as integrações com vLLM, SGLang, llm-d, Hugging Face, TorchTitan, Ray, TorchRec e VeRL, a citação sobre device_map="tpu", o valor de 52% de MFU em até 8192 chips TPU v7x, os números de capacidade da Zenteiq e as citações de Jana van Greunen e Jeff Boudier. Forkast — a data de 20 de outubro, a licença Apache 2.0, a troca de «cuda» por «tpu», os 98% de execuções sem falhas em 5000 modelos do Hugging Face e os 97% de paridade numérica, e as limitações: o desempenho máximo exige trabalho específico de TPU, os kernels CUDA não são portáveis, o processo único de espaço de utilizador e o conjunto de instruções proprietário. MarkTechPost — cobertura do lançamento. A leitura das secções 3 a 6 é minha.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.