Em 1º de dezembro, suas chamadas ao gemini-2.5-pro passam a rodar no Gemini 3.8 Flash. Troque você mesmo o nome do modelo antes que o Google faça isso

By Surya Pratap
19 de novembro de 2026
8 min read
AI & Technology

19 de novembro de 2026
8 min read
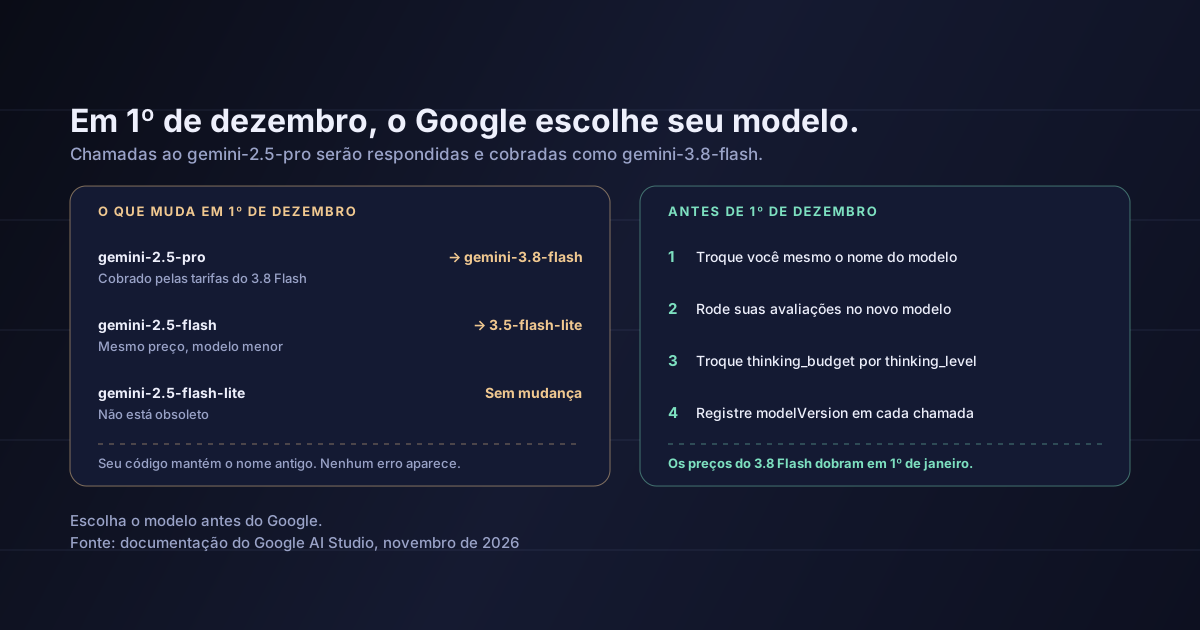 Veja o que é roteado e o que fazer primeiroHover to explore
A maioria das descontinuações de modelos termina com um erro. Suas requisições falham, os alertas disparam e você migra. O Google escolheu outro final para dois dos seus modelos mais usados. A partir de 1º de dezembro, as requisições ao gemini-2.5-pro e ao gemini-2.5-flash não vão falhar. Outro modelo vai respondê-las, e elas serão cobradas pelo preço desse modelo, enquanto seu código continua pedindo o antigo. Ninguém vai avisar você. É exatamente por isso que o assunto merece sua atenção nesta semana.
Em 2 de novembro, o Google marcou os dois modelos como obsoletos e definiu a mesma data para ambos:
gemini-2.5-pro: "A partir de 1º de dezembro de 2026, todas as requisições de API ao gemini-2.5-pro serão roteadas automaticamente para o gemini-3.8-flash e cobradas pelas tarifas do Gemini 3.8 Flash." Ele já sumiu do seletor de modelos do Google AI Studio.gemini-2.5-flash: a partir da mesma data, as requisições "serão roteadas automaticamente para o gemini-3.5-flash-lite e cobradas pelas tarifas do Gemini 3.5 Flash-Lite".gemini-2.5-flash-lite: não está obsoleto. O Google diz que ele "continua disponível pela API até novo aviso".thought_signature, thinking_level substituindo thinking_budget, e a remoção dos parâmetros de amostragem e dos turnos de modelo pré-preenchidos".O conselho do Google é direto: atualize o nome do modelo antes de 1º de dezembro e leia o guia de migração do novo modelo.
Uma descontinuação que devolve erros faz barulho. Você fica sabendo em minutos. Uma descontinuação que roteia é silenciosa. Seus logs mostram respostas bem-sucedidas, seus painéis continuam verdes e os únicos sinais são aqueles que você não estava observando: respostas que soam diferentes, um chamado de suporte sobre um recurso que "piorou", uma linha de custo que mudou.
Repare no que cada rota faz. O gemini-2.5-pro é um modelo Pro; o substituto é um modelo Flash. O gemini-2.5-flash passa para um modelo Flash-Lite. Talvez o Google tenha razão e os modelos mais novos e menores bastem para a maior parte do tráfego. Mas "a maior parte do tráfego" é a média do Google, não o seu produto. Se você escolheu o 2.5 Pro porque um modelo mais barato reprovou nos seus testes, o dia 1º de dezembro desfaz essa escolha sem perguntar.
Uma descontinuação que dá erro avisa que aconteceu. Uma descontinuação que roteia só avisa se você estiver olhando.
Outro modelo. As requisições roteadas são respondidas pelo gemini-3.8-flash ou pelo gemini-3.5-flash-lite. Os dois leem até 1.048.576 tokens e escrevem até 65.536, então os limites de contexto não serão o problema. A qualidade nas suas tarefas é a pergunta em aberto.
Outros padrões. A tabela de raciocínio do Google mostra que o gemini-3.5-flash-lite usa por padrão o nível minimal, e o gemini-3.8-flash, o nível medium. No 3.8 Flash, o Google avisa que "minimal não é suportado e retorna um erro". Se você nunca definiu o raciocínio de forma explícita, a quantidade de raciocínio por trás das suas respostas vai mudar sozinha.
Outro contrato de API. As mudanças incompatíveis não são cosméticas. thinking_level substitui thinking_budget. As chamadas de função agora validam thought_signature. Os parâmetros de amostragem foram removidos, assim como os turnos de modelo pré-preenchidos. O Google não diz o que recebe uma requisição roteada que ainda envia os parâmetros antigos: um erro ou um ajuste ignorado sem aviso. Nos dois casos, é melhor descobrir antes dos seus usuários.
Outra conta. As requisições são cobradas pelas tarifas do novo modelo. As contas estão na próxima seção, e elas trazem uma segunda data.
Por milhão de tokens, segundo a página de preços do Google:
| gemini-2.5-pro hoje | gemini-3.8-flash até 31 de dezembro | gemini-3.8-flash a partir de 1º de janeiro de 2027 | |
|---|---|---|---|
| Entrada, prompts de até 200K tokens | 1,25 $ | 0,75 $ | 1,50 $ |
| Entrada, prompts acima de 200K tokens | 2,50 $ | 0,75 $ | 1,50 $ |
| Saída, prompts de até 200K tokens | 10,00 $ | 3,75 $ | 7,50 $ |
| Saída, prompts acima de 200K tokens | 15,00 $ | 3,75 $ | 7,50 $ |
O 3.8 Flash tem preço de lançamento até 31 de dezembro. Pegue um passo de agente com 50.000 tokens de entrada e 5.000 de saída. No 2.5 Pro, ele custa cerca de 0,11 $. Roteado em dezembro, cerca de 0,06 $. A partir de janeiro, de novo cerca de 0,11 $. Um passo pesado em entrada, com 150.000 tokens de entrada e 2.000 de saída, custa cerca de 0,21 $ hoje, 0,12 $ em dezembro e 0,24 $ em janeiro: mais do que você paga agora.
Para o gemini-2.5-flash, o preço não muda. O 2.5 Flash e o 3.5 Flash-Lite aparecem os dois a 0,30 $ por milhão de tokens de entrada e 2,50 $ por milhão de tokens de saída. Você paga o mesmo por um modelo menor.
# gemini_call.py — choose the model explicitly and log what served it
import logging
from google import genai
from google.genai import types

log = logging.getLogger("llm")
client = genai.Client()

MODEL = "gemini-3.8-flash"   # was "gemini-2.5-pro": change it before 1 December

def ask(prompt: str) -> str:
    resp = client.models.generate_content(
        model=MODEL,
        contents=prompt,
        config=types.GenerateContentConfig(
            # thinking_level replaces thinking_budget on Gemini 3 models
            thinking_config=types.ThinkingConfig(thinking_level="medium"),
        ),
    )
    # modelVersion: "the model version used to generate the response"
    log.info("requested=%s served=%s", MODEL, resp.model_version)
    return resp.text
Troque o nome você mesmo. Procure gemini-2.5-pro e gemini-2.5-flash no seu código, na sua configuração, no seu repositório de prompts e em qualquer ferramenta no-code. Migrar na sua própria data permite testar, liberar aos poucos e voltar atrás. Ser roteado na data do Google não dá nada disso.
Teste o substituto, e as alternativas. Rode seu conjunto de avaliação no gemini-3.8-flash ou no gemini-3.5-flash-lite em cada nível de raciocínio. Se uma tarefa de nível Pro falhar no Flash, teste um modelo maior em vez de aceitar a rota. O sucessor indicado pelo Google não é a única opção.
Corrija primeiro as mudanças incompatíveis. Troque thinking_budget por thinking_level. Remova os parâmetros de amostragem e os turnos de modelo pré-preenchidos. Revise seu código de chamadas de função diante da nova validação de thought_signature. Rode seus testes de chamadas de ferramentas de ponta a ponta, não só prompts isolados.
Registre modelVersion em cada chamada. A referência da API descreve o campo de resposta modelVersion como "a versão do modelo usada para gerar a resposta". Registre-o ao lado do modelo que você pediu. Se os dois divergirem algum dia, você verá no mesmo dia, e não na fatura do mês seguinte.
No mesmo dia, outro preço muda
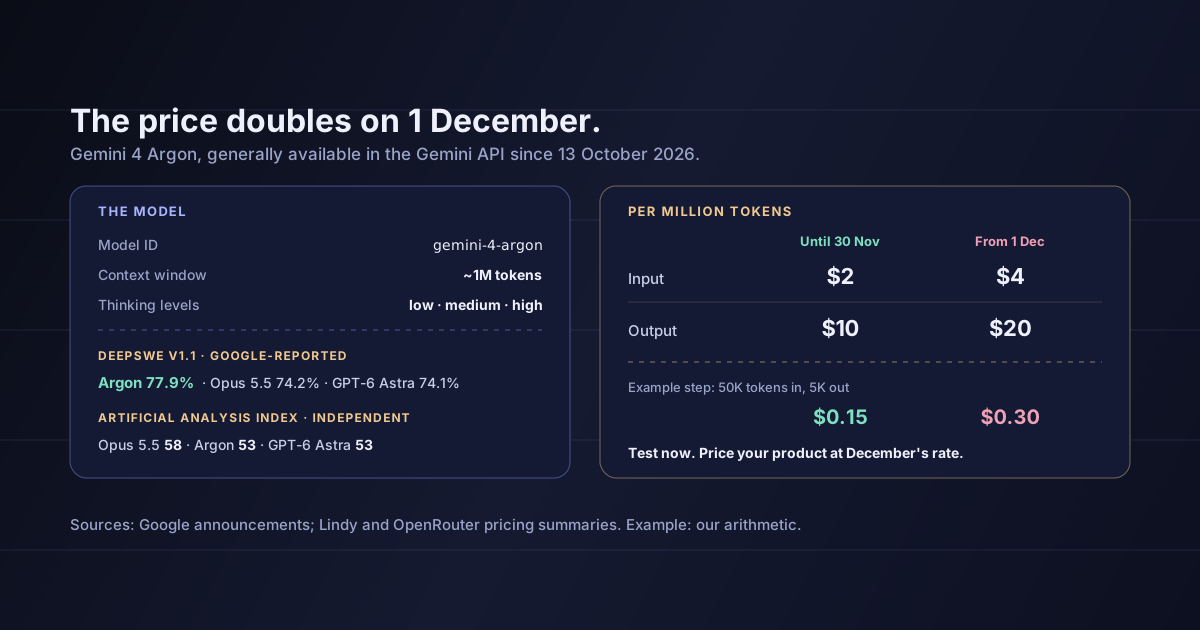
O dia 1º de dezembro também marca o fim do preço de lançamento do Gemini 4 Carbon. A página de preços do Google o lista a 2 $ por milhão de tokens de entrada e 10 $ por milhão de tokens de saída até 30 de novembro, e depois a 4 $ e 20 $. Se você levou algo para o Carbon ou o Argon durante o período de lançamento, revise também essas margens. Fizemos as mesmas contas para o Gemini 4 Argon.
Que o 3.8 Flash seja pior que o 2.5 Pro para você. Ele é mais novo e, em muitas tarefas, pode ser melhor. Não vi o Google publicar uma comparação direta dos dois nas mesmas tarefas. Quem decide é o seu conjunto de avaliação.
O que acontece no Vertex AI. O changelog, a página de descontinuações e a de preços que consultei tratam da Gemini API no Google AI Studio. Eles não mencionam o Vertex AI. Se você chama o Gemini pelo Vertex, consulte o calendário de descontinuação dele.
Como as requisições roteadas tratam os parâmetros antigos. O Google lista as mudanças incompatíveis, mas não diz se uma requisição roteada que envia thinking_budget falha ou é ajustada sem aviso. Teste em vez de supor.
Que as datas sejam definitivas. A página de descontinuações do Google diz que as datas de desligamento são "as datas mais cedo possíveis em que um modelo pode ser retirado". Elas podem ser adiadas. Planejar para 1º de dezembro continua sendo a escolha segura.
A partir de 1º de dezembro de 2026, as requisições à Gemini API para o gemini-2.5-pro serão respondidas pelo gemini-3.8-flash e cobradas pelas tarifas dele, e as requisições para o gemini-2.5-flash serão respondidas pelo gemini-3.5-flash-lite sem mudança de preço. O gemini-2.5-flash-lite não é afetado. O Google lista mudanças incompatíveis na API para a transição, entre elas thinking_level substituindo thinking_budget, uma nova validação nas chamadas de função e a remoção dos parâmetros de amostragem e dos turnos pré-preenchidos. O 3.8 Flash custa menos que o 2.5 Pro até 31 de dezembro; a partir de 1º de janeiro, o preço dobra, e o trabalho pesado em entrada acaba custando mais do que hoje.
O risco não é o novo modelo. É a mudança acontecer sem um erro, sem uma decisão e sem um teste.
Antes de 1º de dezembro, substitua cada gemini-2.5-pro e gemini-2.5-flash por um modelo que você testou, corrija as mudanças incompatíveis e comece a registrar modelVersion para saber qual modelo respondeu a cada requisição.
Fontes: Google AI Studio, changelog da Gemini API, entrada de 2 de novembro de 2026 — a descontinuação do gemini-2.5-pro e do gemini-2.5-flash, o roteamento e a cobrança automáticos a partir de 1º de dezembro de 2026, e a lista de mudanças incompatíveis na API. Descontinuações — datas de lançamento e de desligamento, a situação do gemini-2.5-flash-lite e a nota de que as datas de desligamento são as mais cedo possíveis. Preços — os preços do gemini-2.5-pro, gemini-2.5-flash, gemini-3.8-flash, gemini-3.5-flash-lite e Gemini 4 Carbon. Gemini 3.8 Flash e Gemini 3.5 Flash-Lite — limites de tokens e níveis de raciocínio. Referência da API generateContent — o campo de resposta modelVersion. Tudo consultado em 19 de novembro de 2026. Os exemplos de custo e a leitura das seções 2 a 6 são meus.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.