
O conjunto de avaliação do seu MVP de IA: teste tarefas reais de utilizadores antes do lançamento

By Surya Pratap
16 de julho de 2026
7 min read
MVP Strategy

16 de julho de 2026
7 min read
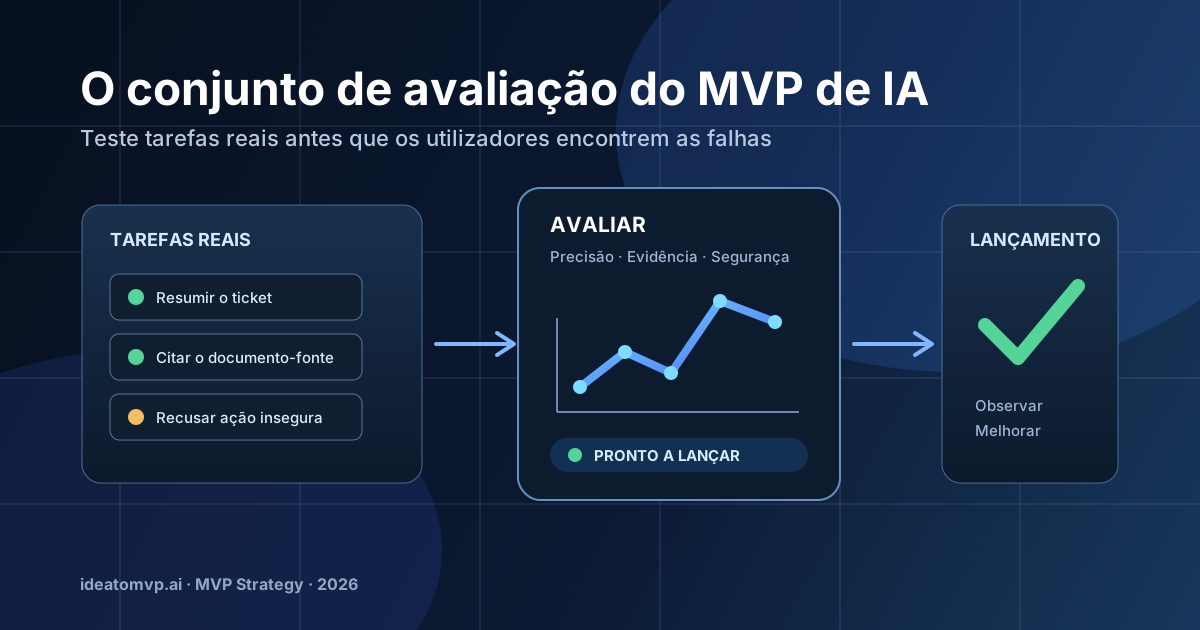
Uma demo de IA pode parecer convincente e, ainda assim, falhar no trabalho de que o cliente realmente precisa. Pode produzir uma resposta polida a que falta um facto obrigatório, citar um documento que não sustenta a conclusão ou executar uma ação que o utilizador nunca quis. Estas falhas são difíceis de ver quando cada prompt de teste é inventado na hora.
A resposta prática para um produto em fase inicial não é um enorme programa de benchmarks. É um pequeno conjunto de avaliação: uma coleção versionada de tarefas reais, resultados esperados e regras de pontuação claras, que executa sempre que o prompt, o modelo, o sistema de recuperação ou o fluxo de trabalho mudam. Transforma o «isto parece melhor» em evidência que pode comparar.
Os fundadores começam muitas vezes pela escolha do modelo, porque é visível e fácil de discutir. Mas os utilizadores não compram um modelo; compram um resultado fiável. Escreva o trabalho que o seu produto deve concluir com as palavras que um cliente usaria: «transforma esta conversa de suporte numa passagem de caso», «extrai a data de renovação deste contrato» ou «sugere uma resposta usando apenas a nossa base de conhecimento aprovada».
Cada trabalho torna-se um caso de teste. Um caso útil inclui a entrada que o utilizador forneceria, o contexto que o seu sistema pode usar, o resultado esperado e a falha que tornaria o resultado inaceitável. Assim, a avaliação mantém-se ligada ao valor do produto e não a uma pontuação genérica de benchmark.
Não precisa de centenas de exemplos para aprender algo importante. Comece com 15 a 20 casos tirados de chamadas de descoberta, trabalho feito manualmente, entrevistas com clientes, pedidos de suporte ou documentos que tenha autorização para usar. Inclua casos comuns, não apenas casos-limite dramáticos. Se a tarefa habitual sair errada, o produto não é útil.
Proteja os dados dos clientes ao recolher exemplos
Use no seu conjunto de avaliação entradas consentidas, anonimizadas ou sintéticas. Remova credenciais, informação pessoal e contexto de cliente desnecessário. O objetivo é preservar a estrutura da tarefa e os critérios de decisão, não criar mais uma cópia descontrolada de dados sensíveis.
A correspondência exata de cadeias de texto costuma ser demasiado frágil para resultados generativos. Pontue antes as propriedades que definem um resultado útil. Num extrator de contratos, isso pode significar que a data está correta, que a passagem de origem é indicada e que a incerteza fica explícita quando a data não existe. Num copiloto de suporte, pode significar que o resumo preserva o problema do cliente, evita compromissos inventados e recomenda a próxima ação aprovada.
No início, funciona bem uma rubrica simples de três níveis: aprovado para um resultado com base no qual o utilizador pode agir, precisa de revisão para um resultado parcialmente útil e reprovado para um erro material, uma afirmação sem suporte ou um comportamento inseguro. Acrescente uma razão curta ao lado de cada resultado não aprovado. Essas razões são o seu backlog de produto.
Uma única pontuação pode esconder a razão pela qual um fluxo não está pronto para lançar. Acompanhe três dimensões em separado. A qualidade pergunta se a resposta resolve a tarefa. A segurança pergunta se o sistema se manteve dentro do comportamento permitido e do perímetro de dados. As operações perguntam se o fluxo responde com rapidez suficiente e a um custo que o negócio consiga suportar.
Esta separação torna visíveis os compromissos. Um modelo maior pode melhorar uma tarefa de raciocínio difícil, mas empurrar o tempo de resposta para lá do que um assistente dentro do produto tolera. Uma atualização da recuperação pode melhorar a relevância e, ao mesmo tempo, aumentar as citações sem suporte. Tratar cada dimensão de forma independente ajuda a decidir se deve afinar, encaminhar de outra forma, acrescentar um ponto de controlo humano ou reduzir o âmbito da funcionalidade.
Execute os mesmos casos antes e depois de cada alteração relevante: uma reescrita do prompt, um modelo novo, instruções de sistema alteradas, novos fragmentos de recuperação ou uma nova ferramenta do agente. Não lance porque o resultado mais recente parece impressionante numa única conversa. Lance quando a alteração melhora ou preserva os resultados que importam aos seus utilizadores e não cria novas falhas de segurança.
O seu primeiro conjunto de avaliação não é uma certificação. É um hábito de produto disciplinado. Guarde os casos, os resultados esperados, a rubrica de pontuação e os resultados junto do trabalho da funcionalidade. Dê a cada caso um responsável e uma razão de existir. Quando um cliente descobrir uma falha relevante, transforme-a num teste de regressão anonimizado antes de a corrigir.
Um MVP de IA torna-se credível quando é fiável na tarefa concreta que promete fazer. Um conjunto de avaliação compacto dá aos fundadores uma forma de melhorar essa fiabilidade de forma deliberada, antes que uma demo polida se transforme numa surpresa cara em produção.


IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.