
LiteLLM como gateway de dados de IA: proteger a informação sensível dos seus clientes

By Surya Pratap
15 de julho de 2026
8 min read
AI & Technology

15 de julho de 2026
8 min read
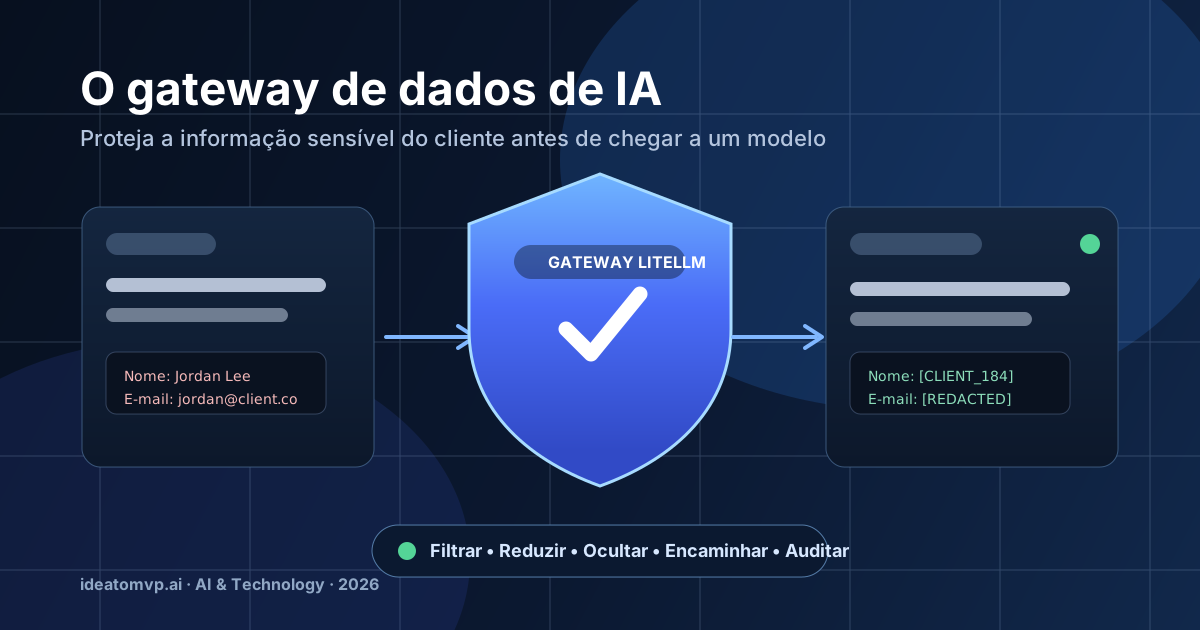
A decisão de arquitetura de IA com mais consequências muitas vezes não é o modelo que escolhe. É decidir onde os dados dos clientes atravessam a fronteira entre a sua aplicação e o sistema de um fornecedor de modelos. Uma transcrição de suporte pode conter um número de conta. Um formulário de admissão clínica pode conter um diagnóstico. Um prompt comercial pode conter um contrato, uma exceção de preço ou um roteiro confidencial. Enviar esse contexto diretamente de cada funcionalidade para cada fornecedor cria um perímetro de dados que não consegue ver nem governar de forma fiável.
O LiteLLM é útil aqui, e não apenas porque dá às equipas uma única API para muitos modelos. Usado de forma deliberada, torna-se um gateway de IA: um único ponto controlado onde aplicar políticas antes de qualquer pedido sair do seu ambiente, encaminhando depois o pedido já minimizado para um fornecedor de modelos aprovado.
Sem um gateway, uma equipa de produto vai acumulando chamadas diretas a SDK no chat, no suporte, na pesquisa de documentos, na análise de dados e nos fluxos de agentes. Cada chamada pode escolher um fornecedor diferente, usar definições de registo diferentes e levar uma quantidade diferente de contexto do cliente. As revisões de segurança passam a ser uma busca pelo código da aplicação, em vez da revisão de uma única fronteira de políticas.
Isto não é um argumento para proibir que quaisquer dados cheguem a um modelo. A pergunta útil é mais restrita: que informação é necessária para esta tarefa, que campos são sensíveis e que fornecedor está aprovado para processar o prompt resultante? Um gateway dá a essas perguntas um lugar onde são aplicadas.
Ocultar dados não é o controlo todo
A deteção por padrões só encontra aquilo que sabe procurar. Trate a ocultação como um controlo dentro de um desenho por camadas: contratos de entrada estruturados, campos em lista de permissões, política de fornecedores, controlos de acesso, regras de retenção e revisões daquilo que os seus registos guardam. Um gateway torna esses controlos coerentes; não elimina a necessidade de os desenhar.
Escolha a transformação com base no que o modelo precisa de fazer. Se o nome de um cliente não acrescenta nada a uma tarefa de resumo, substitua-o por uma etiqueta genérica. Se o modelo tiver de distinguir duas pessoas ao longo de uma conversa, use um marcador estável como CLIENT_184 e guarde a correspondência no seu próprio sistema. Se um prompt incluir uma credencial, um número de cartão de pagamento ou dados que a sua política proíbe de sair do ambiente, bloqueie o pedido e devolva uma mensagem segura à funcionalidade que o fez.
O padrão mais sólido costuma ser minimizar os dados antes de os detetar: construir os prompts a partir de um conjunto pequeno e tipado de campos permitidos, em vez de enviar um registo completo da base de dados e tentar limpá-lo depois.
Não comece por colocar todas as funcionalidades de IA atrás de um motor de políticas complexo. Comece pelo fluxo com a exposição mais evidente de dados de clientes: o resumo de pedidos de suporte, a extração de documentos ou um assistente interno com acesso aos registos de clientes. Mapeie os campos que envia hoje, decida quais são necessários e coloque um único caminho de gateway à frente dele. A política e a telemetria resultantes vão mostrar onde o próximo fluxo precisa de uma regra diferente.
O objetivo não é tornar a IA inutilizável. É tornar cada chamada a um modelo intencional, explicável e reversível. Uma camada de abstração baseada no LiteLLM transforma a escolha do fornecedor e a proteção dos dados dos clientes, hoje um detalhe de implementação disperso, numa arquitetura que a sua equipa pode inspecionar e melhorar.


IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.