Integração vertical de IA nas empresas: ser dono das camadas de GPU, modelo e aplicação em 2026

Surya Pratap
By Surya Pratap

7 de julho de 2026

11 min read

AI & Technology
Integração vertical de IA: as camadas de GPU, modelo ajustado e aplicação

Nos últimos três anos, a arquitetura de IA empresarial por omissão foi horizontal: alugar um modelo de fronteira através de uma API, ligá-lo a uma dúzia de fluxos de trabalho e pagar por token. Era rápido para começar e caro para continuar. Em 2026, as maiores empresas, e as mais sérias do ponto de vista operacional, estão discretamente a fazer o contrário: a integrar verticalmente o seu stack de IA, camada a camada, à volta dos casos de uso que realmente mexem na conta de resultados.

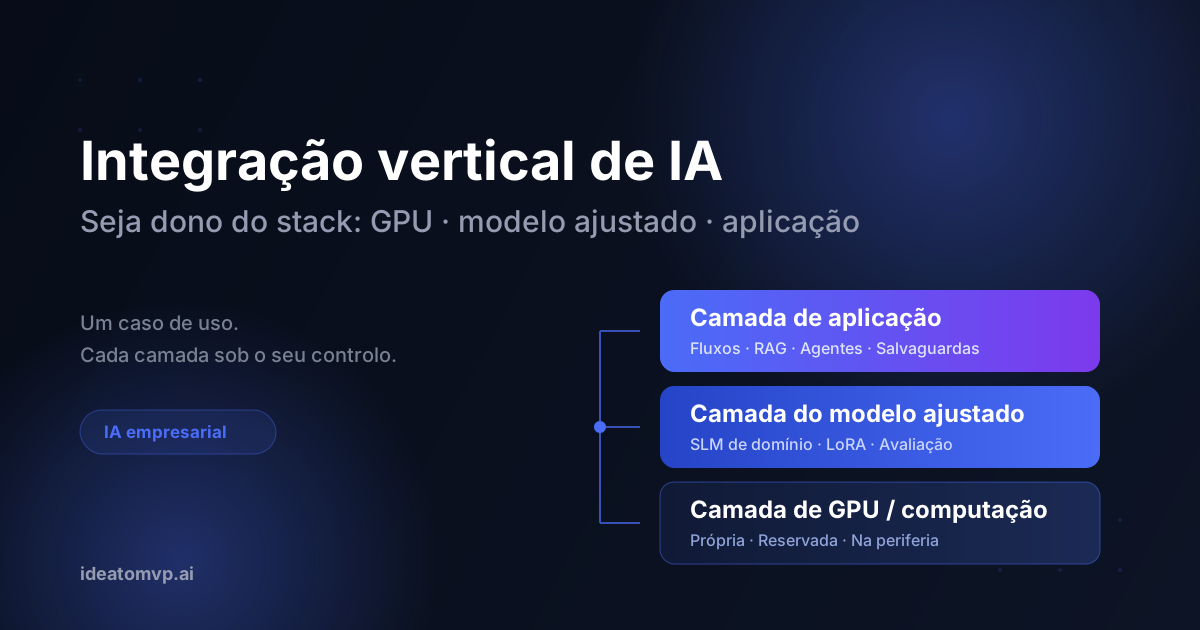
Integração vertical em IA significa o mesmo que significou para a Ford e o aço ou para a Apple e o silício: ser dono das camadas da sua cadeia de valor que criam diferenciação, em vez de as alugar a um fornecedor que também serve os seus concorrentes. Em IA, essas camadas são três: a camada de computação (GPU), a camada de modelo e a camada de aplicação. Este artigo percorre cada uma, explica porque é que as contas da integração finalmente batem certo e descreve a sequência que permite a uma empresa fazer a transição sem pôr a empresa em jogo.

Porquê a integração vertical, e porquê agora

Três forças convergiram para tornar racional a posse do stack, mesmo para empresas que em 2024 se teriam rido da ideia.

  • Os custos de API deixaram de crescer com o valor. As empresas que usam IA em fluxos de produção relatam faturas mensais de API de cinco e seis dígitos em que a maioria dos tokens é gasta em tarefas repetitivas e restritas (classificação, extração, resumo) que não precisam de todo de um modelo de fronteira. Pagar preços de topo por inferência rotineira é o equivalente em IA a correr tarefas em lote em instâncias cloud a pedido de gama alta.
  • Os modelos de pesos abertos fecharam a diferença de qualidade em tarefas restritas. Um modelo pequeno ajustado, treinado com os seus próprios dados etiquetados, já bate rotineiramente um modelo de fronteira guiado por prompts na tarefa específica para que foi treinado, com uma fração da latência e do custo. A diferença só importa no raciocínio aberto, que é uma minoria das cargas de trabalho empresariais.
  • A soberania dos dados tornou-se um tema do conselho de administração. Os setores regulados (saúde, finanças, defesa, jurídico) podem cada vez menos enviar os seus dados mais valiosos para uma API de terceiros, ponto final. A escolha não é «alugar ou possuir»; é «possuir ou não implementar».

A lógica estratégica é a mesma que Alex Karp, da Palantir, tem repetido publicamente: controle a sua computação, os pesos dos seus modelos e os seus dados, ou veja o valor do seu conhecimento proprietário escorrer para o treino de outra pessoa. A integração vertical é a forma como esse princípio se torna arquitetura.

Camada 1: a camada de GPU / computação

Ser dono da camada de computação não significa construir um centro de dados. Significa passar do preço por token para capacidade que controla, na forma que se adequar à sua escala:

  • Cloud de GPU reservada: capacidade A100/H100 contratada a fornecedores como CoreWeave, Lambda ou os níveis reservados dos hiperescaladores. É o ponto de entrada para a maioria das empresas: custo previsível, sem investimento de capital e sem equipa de operações de hardware.
  • Hardware de inferência próprio: um pequeno bastidor de placas L40S ou de classe RTX para inferência estável e sensível à latência. Uma única GPU moderna serve um modelo ajustado de 7B a centenas de utilizadores em simultâneo; o hardware paga-se face às faturas de API em meses, não em anos.
  • Inferência na periferia: modelos quantizados a correr nas instalações ou no dispositivo quando os dados não podem sair do edifício: redes hospitalares, fábricas, salas de negociação.

A regra de decisão é a utilização. Se o seu volume de inferência for estável e previsível, ganha a capacidade própria ou reservada. Se for irregular e experimental, mantenha essa carga de trabalho em computação alugada e integre primeiro as estáveis.

Camada 2: a camada do modelo ajustado

É nesta camada que a integração vertical cria uma vantagem defensável. Uma API de fronteira dá a todos os concorrentes a mesma inteligência ao mesmo preço. Um modelo ajustado com o seu histórico de transações, as suas conversas de suporte, os seus contratos e os seus relatórios de defeitos é uma inteligência que só a sua empresa tem.

O pipeline moderno de fine-tuning é muito mais leve do que a maioria dos executivos supõe:

  • Escolha do modelo base: comece por um modelo de pesos abertos (Llama, Phi, Gemma, Mistral) dimensionado para a tarefa. A maioria das tarefas empresariais cai no intervalo de 3B–8B.
  • Treino eficiente em parâmetros: o LoRA e o QLoRA adaptam um modelo base com milhares de exemplos numa única GPU em horas. O verdadeiro trabalho não é a computação, é a curadoria de dados: a qualidade dos seus exemplos etiquetados decide a qualidade do modelo.
  • Ciclos de avaliação: um conjunto de teste reservado, pontuado com a sua métrica de negócio real e executado em cada retreino. É esta disciplina que separa os programas de modelos em produção dos projetos de ciência.
  • Cadência de retreino: retreinos mensais ou trimestrais com dados de produção recentes. Cada ciclo alarga a distância entre o seu modelo e tudo o que um concorrente consiga obter com engenharia de prompts.

O teste de integração para a camada de modelo

Faça uma só pergunta: esta tarefa beneficia de conhecimento que só nós temos? Se sim, faça fine-tuning e seja dono dela. Se não, se um modelo genérico com bons prompts fizer o trabalho, continue a alugar essa tarefa e invista o orçamento de treino onde os seus dados são a vantagem.

Camada 3: a camada de aplicação

A camada de aplicação é onde o modelo encontra o negócio, e é a camada que as empresas mais vezes fazem mal: ou a entregam a um fornecedor SaaS (e perdem o fluxo de trabalho juntamente com os dados) ou investem nela menos do que no modelo. Uma camada de aplicação integrada verticalmente inclui:

  • Infraestrutura de disponibilização: vLLM ou TGI para inferência de alto débito, com imposição de saída estruturada para que os sistemas a jusante recebam JSON válido e não prosa.
  • Recuperação (RAG) sobre o seu próprio conhecimento: os seus documentos, vetorizados e indexados na sua infraestrutura, para que o modelo responda a partir da sua fonte de verdade e não dos seus dados de treino.
  • Encaminhamento inteligente: o coração pragmático do stack. Encaminhe 70–80% dos pedidos para o seu modelo ajustado; escale os 20–30% verdadeiramente difíceis e abertos para uma API de fronteira. A integração vertical não é pureza: é pôr cada pedido na camada mais barata que o resolva bem.
  • Salvaguardas e auditoria: filtragem de entradas e saídas, tratamento de dados pessoais e registo completo dos pedidos. Quando o stack é seu, a conformidade deixa de ser um questionário do fornecedor e torna-se uma propriedade da sua arquitetura.

A sequência: como as empresas fazem realmente a mudança

Nenhuma empresa integra verticalmente tudo de uma vez. O padrão que funciona vai de cima para baixo, ao contrário da forma como se lê o diagrama do stack:

  • Seja dono primeiro da camada de aplicação. Construa os seus fluxos de trabalho, a recuperação e o encaminhamento sobre API de fronteira alugadas. É aqui que aprende como é a sua distribuição real de pedidos, que são os dados de que precisa para todas as decisões seguintes.
  • Integre a camada de modelo para a sua tarefa de maior volume. Escolha a carga de trabalho que mais gasta em API, ajuste um modelo pequeno para ela e coloque-o atrás do encaminhador. Meça a qualidade e o custo face à referência da API.
  • Integre a computação quando a utilização o justificar. Quando a sua inferência alojada internamente estiver estável, passe-a da cloud de GPU a pedido para capacidade reservada ou própria e fixe o piso de custos.

Cada passo justifica-se por si só pelo seu próprio retorno, e cada passo é reversível. É isso que faz disto uma estratégia e não uma aposta.

Quando não integrar

A integração vertical não é para si se as suas cargas de trabalho de IA ainda forem exploratórias, se lhe faltarem os dados etiquetados que tornam o fine-tuning compensador ou se as suas tarefas principais exigirem realmente raciocínio à escala da fronteira e um conhecimento amplo do mundo. Nesses casos, o stack alugado não é uma armadilha: é a ferramenta certa. O erro é ficar nele por omissão depois de as suas cargas de trabalho se terem tornado restritas, estáveis e ricas em dados.

Conclusão

As empresas que ganham com a IA em 2026 não são as que têm os maiores orçamentos de API. São as que identificaram o seu caso de uso de maior valor e maior volume e integraram o stack por baixo dele: lógica de aplicação que controlam, um modelo treinado com dados que só elas têm, a correr em computação com preço de infraestrutura em vez de um serviço faturado ao consumo. Comece no topo do stack, desça uma camada de cada vez e deixe que o retorno de cada camada financie a seguinte.

Se está a ponderar por onde começar (que carga de trabalho ajustar primeiro, ou se o seu volume justifica computação própria), marque uma chamada de descoberta gratuita e desenhamos o seu stack consigo.


IdeaToMVP Academy

Want to build with AI — not just read about it?

4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.

Explore the Academy →
Share this post :