
O stack multimodelo: como as startups estão a cortar 85% nos custos de programação com IA em 2026

By Surya Pratap
8 de julho de 2026
9 min read
AI & Technology

8 de julho de 2026
9 min read
A 7 de julho de 2026, Paul Graham publicou uma experiência mental de uma linha que tomou conta do Twitter tecnológico: «Imagine como será se, daqui a 5 anos, os modelos tiverem melhorado em relação ao Fable tanto quanto o Fable melhorou em relação ao GPT-3.» As citações dividiram-se como sempre: metade espanto, metade ceticismo. Mas a conversa mais útil nem sequer era sobre 2031. Estava nas respostas, onde developers no ativo publicaram as suas faturas.
$200 por dia. $350 por dia. $500 por dia em ciclos intensivos de agentes. Não eram casos isolados: era um fluxo constante de fundadores e engenheiros a dizer o mesmo. Os modelos de fronteira mais recentes são espantosos, e passar todo o fluxo de desenvolvimento por eles está, discretamente, a tornar-se uma das maiores rubricas do orçamento de uma pequena startup. Na mesma semana, um padrão alternativo tornou-se viral no Reddit e no X: o stack multimodelo, e os números por trás dele merecem a atenção de qualquer fundador.
Eis as contas incómodas. Os modelos de fronteira atuais custam, a preço de tabela, cerca de $10 por milhão de tokens de entrada e $50 por milhão de tokens de saída. Os modelos de gama média dos mesmos laboratórios custam um quinto disso ou menos. E para uma grande parte do que um fluxo de desenvolvimento realmente faz (mudar nomes de variáveis, escrever código repetitivo, gerar testes a partir de uma especificação clara, corrigir erros de lint, iterar sobre CSS), o modelo de gama média produz essencialmente o mesmo resultado.
Quando passa tudo pelo modelo de fronteira, paga o prémio 100% do tempo por trabalho que só precisa dele talvez 20% do tempo. É assim que um fundador a solo acaba com uma fatura de IA de $6,000/mês antes de ter um único cliente pagante.
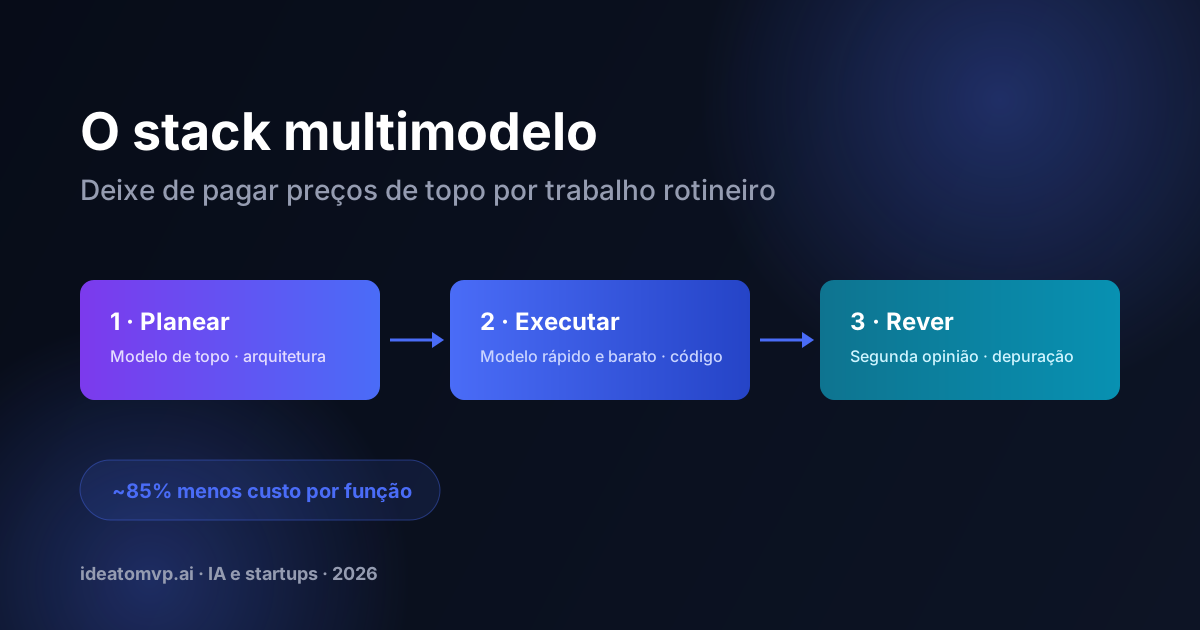
O stack multimodelo que se tornou viral esta semana tem três fases, cada uma encaminhada para o modelo mais adequado, e com melhor preço, para a tarefa:
As contas por funcionalidade
As equipas que aplicam este padrão relatam uma redução de custos de cerca de 85% por funcionalidade, com qualidade comparável ou melhor, porque o modelo caro só intervém nos passos curtos e de maior impacto, e a geração cheia de tokens acontece em modelos com preço de volume. Numa equipa que entrega dezenas de funcionalidades por sprint, é a diferença entre os gastos com IA serem um erro de arredondamento ou o seu segundo maior custo a seguir aos salários.
Uma grande empresa consegue absorver uma fatura de IA inflacionada. Uma startup em fase pre-seed não consegue e, mais importante, o hábito acumula-se. As equipas que cedo tratam o encaminhamento de modelos como uma disciplina de engenharia acabam com três vantagens estruturais:
É difícil exagerar a distância entre o GPT-3 e os modelos de fronteira atuais, e se os próximos cinco anos a repetirem, a maioria dos debates de hoje sobre fluxos de trabalho vai parecer antiquada. Mas esse futuro corta nos dois sentidos: todos os modelos de fronteira do passado acabaram por se tornar modelos comuns. O modelo de topo de hoje a $50 por milhão de tokens é o executor barato do próximo ano. Um stack multimodelo não é uma aposta contra o progresso da IA: é a arquitetura que beneficia dele automaticamente, porque cada novo lançamento entra na sua tabela de encaminhamento no nível que o seu preço justifica.
As startups que vencerem este ciclo não serão as que mais gastaram em tokens. Serão as que criaram a disciplina de gastar exatamente o que cada tarefa vale, e que lançaram mais depressa por causa disso.
Se está a construir um produto de IA e quer ajuda para desenhar uma arquitetura de encaminhamento de modelos que mantenha os seus gastos previsíveis, marque uma chamada de descoberta gratuita: é exatamente o tipo de sistema que entregamos a fundadores todos os meses.



IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.