Een AI-tutor evenaarde menselijke experts voor 1/918e van de kosten. Het was het goedkoopste geteste model

By Surya Pratap
2 oktober 2026
9 min read
AI & Technology

2 oktober 2026
9 min read
 Prijs per punt, niet per tokenHover to explore
De meeste vergelijkingen tussen AI-modellen gaan over wat de modellen kunnen. Deze gaat over wat de mensen die ze gebruikten leerden, gemeten vooraf en achteraf, tegen een controlegroep en tegen menselijke experts. Het nuttigste resultaat voor founders heeft niets met onderwijs te maken.
Alles hieronder komt uit 'StudentBench: AI and human tutoring yield equivalent GRE learning gains' van Curtis Northcutt, Inaara Hasmani, Kevin Feng, Trevor Khangi, Andreas Plesner en Jonas Mueller van Handshake AI Research, een preprint die op 23 september 2026 verscheen en op 30 september werd herzien. De geanonimiseerde data is openbaar. Handshake beheert ook het StudentBench-tutorplatform dat het onderzoek gebruikte. De interpretatie vanaf sectie 3 is van mij.
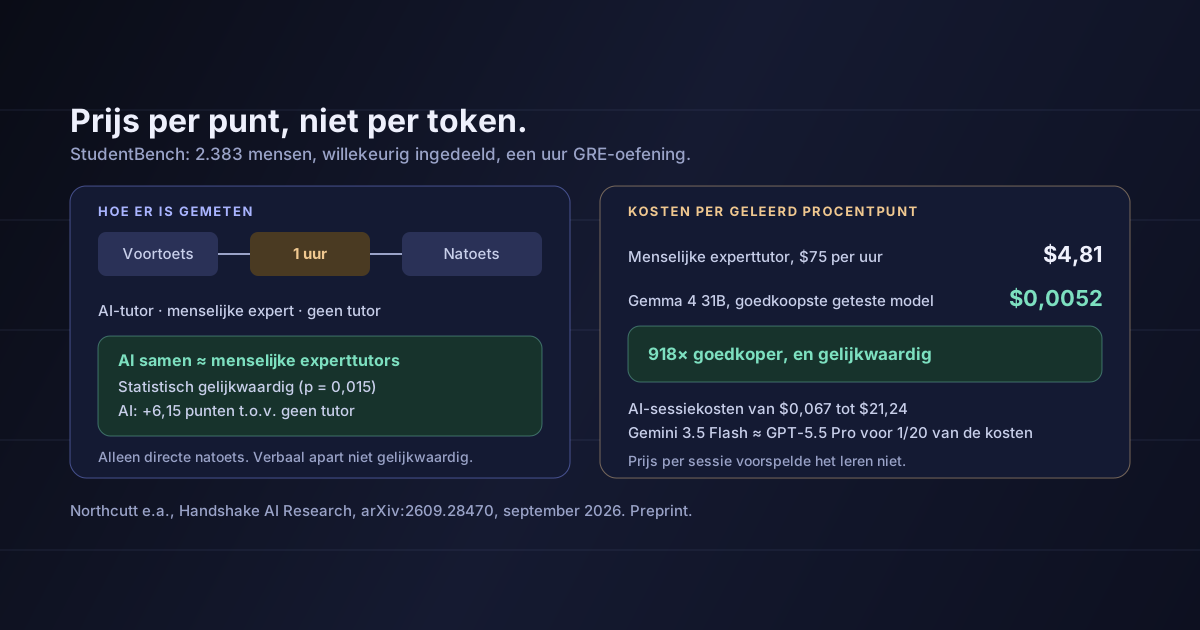
Het onderzoek wierf 2.383 volwassenen, de meesten tussen 18 en 24 jaar, om zich voor te bereiden op de GRE, een toelatingstoets voor masteropleidingen. Elke sessie had dezelfde opbouw:
De leerwinst was de score op de natoets min de score op de voortoets, in procentpunten. De menselijke tutors waren voormalige schrijvers van GRE-vragen of tutors met minstens vijf jaar ervaring, en ze mochten de vragen van de natoets niet zien.
AI-tutoring als geheel was statistisch gelijkwaardig aan tutoring door menselijke experts op GRE-leerwinst (p = 0,015, binnen een marge van een kwart standaarddeviatie). Het gemiddelde verschil tussen AI en mens was −0,58 procentpunt. Beide deden het beter dan geen tutor: AI-tutoring voegde 6,15 punten toe ten opzichte van de controlegroep.
Zes van de AI-tutors haalden afzonderlijk de gelijkwaardigheidstoets tegen de menselijke tutors. In vijf van de zeven GRE-onderdelen deed de beste AI-tutor het gemiddeld beter dan de menselijke tutors.
Dan de kosten.
De prijs van een model zei bijna niets over hoeveel een student ermee zou leren. Alleen het leren meten zei dat.
Dit is de les die verder reikt dan tutoring. De auteurs vergeleken de modellen niet op een benchmark of op prijs per token. Ze vergeleken ze op kosten per eenheid van het resultaat waarvoor het product bestaat: hier dollars per procentpunt leerwinst.
Zo bekeken verandert de rangorde van de modellen. Een model dat per sessie 300 keer meer kost, is het alleen waard als het 300 keer meer oplevert van wat je verkoopt, en in dit onderzoek deed de dure kant dat niet.
De meeste AI-producten worden andersom geprijsd en gebouwd. Het team kiest een capabel, duur model omdat dat veilig voelt, meet de kosten per aanroep en meet nooit wat elke aanroep voor de gebruiker oplevert. Zonder dat resultaat weet je niet of een model dat twintig keer goedkoper is het werk net zo goed zou doen.
Eén secundaire uitkomst is makkelijk over het hoofd te zien. In de kwantitatieve sessies hingen snellere AI-antwoorden samen met meer berichten van studenten, meer berichten met meer goed opgeloste oefenvragen, en meer goede oefening met grotere leerwinst (allemaal p < 0,002).
Het is een correlatie, geen gecontroleerd experiment, en de auteurs presenteren het ook zo. Maar het wijst op iets wat founders vaak onderschatten: in een interactief product is latency geen technisch detail. Als een trager, slimmer model minder oefenrondes betekent, kan de gebruiker uiteindelijk minder leren — of krijgen — in plaats van meer.
Het waardevolste aan StudentBench voor een founder is hoe er is gemeten, en het meeste daarvan is goedkoop na te bootsen.
Meet vooraf en achteraf. Bepaal welk resultaat je product verandert en meet het aan het begin en eind van een sessie. Tevredenheidsscores en tijd in de app zijn geen resultaten.
Houd een controlegroep zonder AI. Zonder die groep kun je niet zien welk deel van de verbetering door je product komt en welk deel er toch al was gekomen. Hier leverde ook geen tutor wat winst op.
Vergelijk modellen op dezelfde gebruikers. Deel gebruikers willekeurig in bij twee of drie modellen en vergelijk resultaten, niet alleen kosten. Een goedkoper model dat gelijkwaardig blijkt, is een brutomargebeslissing die klaarligt.
Deel de kosten door het resultaat. Rapporteer kosten per eenheid resultaat — per opgelost ticket, per goed antwoord, per geleerd punt — en neem modelbeslissingen op dat getal.
Voor teams die AI-training inkopen of geven, is de uitkomst bemoedigend, maar in beperkte zin. Bij oefenen met duidelijke goede antwoorden kan een AI-tutor in één sessie een menselijke expert evenaren, voor een fractie van de kosten. Daarmee is het verstandig om AI-tutors in te zetten voor oefening tussen live sessies door.
Het laat niet zien dat AI een menselijke docent vervangt. Het onderzoek mat één uur en een directe natoets. Of de winst blijft, en of AI-tutoring net zo goed werkt voor open vaardigheden, zijn vragen die het niet stelde.
Het is een preprint van het bedrijf dat het platform beheert. Handshake AI Research voerde het onderzoek uit op Handshake's eigen StudentBench-dienst. De data is openbaar gemaakt, wat helpt, maar het onderzoek is niet peer-reviewed.
De menselijke groep was klein. Zo'n 140 sessies met een menselijke tutor tegen meer dan 2.100 met AI. De gelijkwaardigheid is vastgesteld voor AI als geheel; de afzonderlijke vergelijkingen hebben minder onderbouwing.
Het verbale deel liet op zichzelf geen gelijkwaardigheid zien. De totaaluitkomst combineert het kwantitatieve en het verbale deel. Voor het verbale deel apart is gelijkwaardigheid niet aangetoond, en daar hadden de menselijke tutors de hoogste gemiddelde winst in alle drie de verbale onderdelen.
De winst is direct gemeten. Er is geen uitgestelde toets gedaan. Wat een uur later zichtbaar is, hoeft een maand later niet meer zichtbaar te zijn, voor geen van beide groepen.
De menselijke kosten zijn een referentietarief. Het cijfer van $4,81 gebruikt een gepubliceerd tarief van $75 per uur uit een bron van 2018. Werkelijke tutorprijzen lopen sterk uiteen, wat de factor verandert, maar niet de richting.
Ik heb niet de afzonderlijke uitkomst van elk model gecontroleerd. Het artikel geeft sommige cijfers alleen in grafieken. Ik heb alleen de uitkomsten gebruikt die in de tekst staan.
StudentBench is een van de zorgvuldigste vergelijkingen tot nu toe tussen onderwijs door AI en door mensen: gerandomiseerd, gecontroleerd, met menselijke experttutors en open data. Voor een uur GRE-oefening was AI-tutoring even effectief als een menselijke expert, en het goedkoopste geteste model hoorde bij de modellen die hen evenaarden.
Voor founders zit de blijvende les in de methode. De auteurs kozen modellen op kosten per eenheid van het resultaat dat voor hen telde, en maten dat resultaat tegen een controlegroep. Daarmee kwam een model van $0,067 op het niveau van menselijke experts, en bleek de duurste optie niet de juiste keuze.
Voordat je een model kiest op prijs of reputatie: meet wat elk model echt oplevert voor je gebruikers, en deel de kosten daardoor.
Bron: Curtis Northcutt, Inaara Hasmani, Kevin Feng, Trevor Khangi, Andreas Plesner en Jonas Mueller, 'StudentBench: AI and human tutoring yield equivalent GRE learning gains', arXiv:2609.28470, v1 van 23 september 2026, v2 van 30 september 2026: de 2.383 deelnemers, de opzet met voortoets, een uur conditie en parallelle natoets, de 13 AI-tutorconfiguraties per onderdeel en de menselijke experttutors, de totale gelijkwaardigheidsuitkomst (p = 0,015), het verschil van −0,58 punt, de winst van 6,15 punten ten opzichte van de controlegroep, de zes afzonderlijke gelijkwaardigheden, de uitkomst in vijf van de zeven onderdelen, de sessiekosten van $0,067 en $21,24, de gelijkwaardigheid van Gemma 4 31B (p = 0,044) en $0,0052 tegen $4,81 per procentpunt bij $75 per uur, de vergelijking tussen Gemini 3.5 Flash en GPT-5.5 Pro, de correlaties tussen latency en betrokkenheid, de groepsgroottes, de uitkomst voor alleen het verbale deel en de genoemde beperkingen, alles zoals daar gerapporteerd. Geanonimiseerde data en code: StudentBench op GitHub. De interpretatie in secties 3 tot en met 6 is van mij. Over waarom kleine modellen smalle taken vaak winnen, zie het meeste waarvoor je agent een LLM aanroept is een ja of een nee. Over het tijdsprobleem in AI-training voor bedrijven, zie AI-training is meer dan verdubbeld; 56% krijgt geen tijd om het te volgen.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.