Het meeste waarvoor je agent een LLM aanroept is een ja of een nee

By Surya Pratap
21 september 2026
11 min read
AI & Technology

21 september 2026
11 min read
 Vier beslissingen en één zinHover to explore
Af en toe is een lancering het lezen waard om de premisse en niet om de cijfers. Deze heeft een premisse die mij juist lijkt en cijfers die niemand buiten het bedrijf heeft gecontroleerd, een ongebruikelijke combinatie die je zorgvuldig uit elkaar moet houden.
Dit artikel werkt vanuit LangChains "Building a harness with Jev" van Sydney Runkle en Hunter Lovell, gepubliceerd op 17 september 2026; TypeSafe AI's eigen aankondiging; een praktische API-rondleiding; en MindStudio's sceptische lezing van de claims. Elk prestatiecijfer hieronder is van TypeSafe zelf. Paragraaf 7 zegt wat dat betekent. Het betoog vanaf paragraaf 2 is van mij.
TypeSafe AI bracht Jev uit, wat het een System One-model noemt: een klasse die het omschrijft als modellen die gemaakt zijn om snelle, gestructureerde beslissingen te nemen die software direct verwerkt, in plaats van om tekst te genereren. LangChain publiceerde diezelfde week een harness die erop is gebouwd.
De vorm van het ding: je geeft het een state en een set getypeerde vragen, en het beantwoordt ze allemaal in één ronde met kansen erbij. Drie vraagtypen:
Choice — kies er één uit maximaal 255 opties, met een kans per optieScore — plaats de invoer op een geordende schaal van 2 tot 10 niveausNoul — een ja of een nee, teruggegeven als één getal tussen 0 en 1from typesafe_sdk import Choice, Noul, TypeSafeClient
client = TypeSafeClient()
response = client.system_one(
state={"ticket": "I was charged twice"},
questions={
"department": Choice(
instructions="Which team handles this",
criteria={"billing": "Payment issues", "technical": "Bugs"},
),
"urgent": Noul(instructions="Message conveys urgency"),
},
)
Twee architectuurverschillen doen het werk. Het model sampelt alle uitvoer in één query parallel in plaats van autoregressief, en daar komt de latencyclaim vandaan. En het is getraind met wat TypeSafe RLCD noemt, reinforcement learning voor gekalibreerde beslissingen, dat niet optimaliseert voor een antwoord dat een menselijke beoordelaar goedkeurt, maar voor een antwoord met een kans erbij die weergeeft hoe vaak dat antwoord juist is.
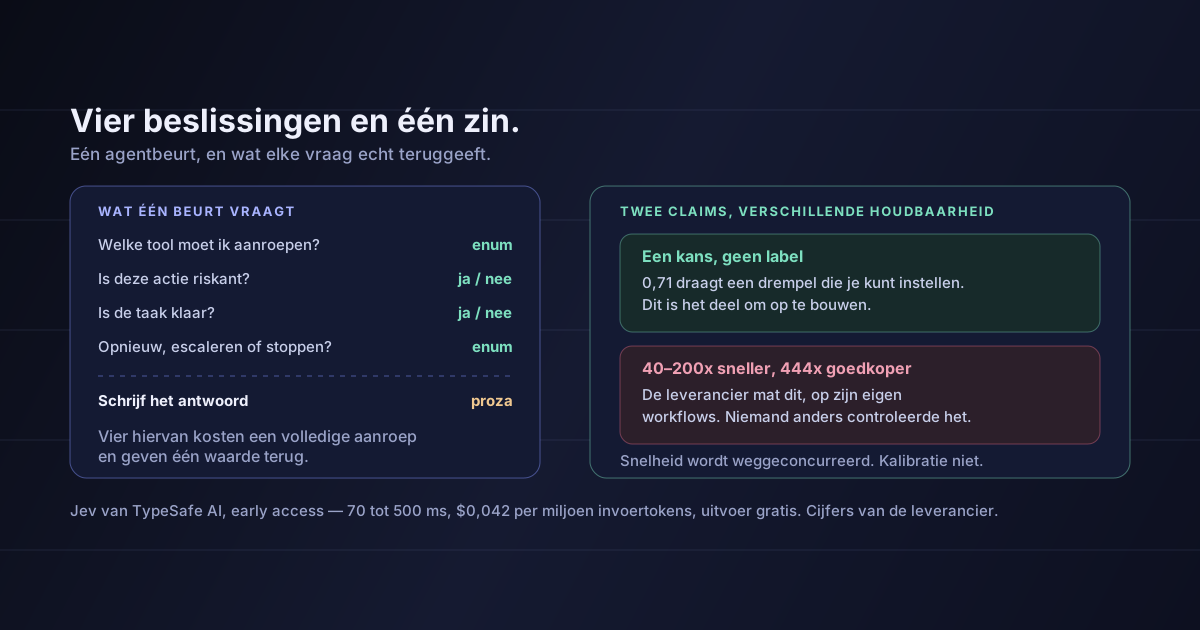
De gepubliceerde cijfers: 70–500 ms end-to-end, $0,042 per miljoen invoertokens met gratis uitvoer, en op de eigen workflow-evaluaties van het bedrijf 193,6× sneller en 444,6× goedkoper dan de frontier-modellen waarmee is vergeleken. De context is begrensd op 64k tokens totaal, 32k voor de state.
Haal de leverancier weg en kijk waar een agentbeurt werkelijk uit bestaat.
Welke tool moet ik aanroepen? Een enum. Eén uit elf opties.
Is deze actie riskant genoeg om te stoppen? Een ja of een nee.
Is de taak klaar? Een ja of een nee, elke ronde opnieuw gesteld.
Opnieuw proberen, escaleren of opgeven? Weer een enum.
En dan, één keer, aan het eind: schrijf het antwoord. Dat heeft een taalmodel nodig, en niets hiervan vervangt dat.
Het dure deel van een agentbeurt is zelden het schrijven. Het zijn de veertig kleine beslissingen die elk een volledige modelaanroep kosten.
Elk van die beslissingen gaat nu door een model dat gemaakt is om zinnen te produceren, geprijsd per token, autoregressief genererend, en wordt daarna bij het parsen weer teruggebracht tot één woord. Je betaalt generatieprijzen en generatielatency voor werk waarvan de hele uitvoer in één byte past.
Die bewering kost niets om te toetsen en hangt er niet van af of ook maar één cijfer van TypeSafe klopt. Het is dezelfde beweging als OLTP van analytics scheiden, of een cache van een database: twee toegangspatronen in één component omdat nog niemand had opgemerkt dat het er twee waren.
Voordelen in snelheid en kosten worden weggeconcurreerd. Binnen twee kwartalen zijn er vier van deze dingen en is de prijs die van de op een na goedkoopste. Kalibratie is het deel waar ik daadwerkelijk op zou bouwen.
Het verschil in de praktijk. Een LLM die je vraagt "is dit urgent?" geeft urgent terug. Een gekalibreerde classifier geeft 0,71 terug.
Een label geeft je een vertakking. Een kans geeft je een drempel, en een drempel is een knop:
Blokkeren boven 0,9, markeren voor review vanaf 0,6, loggen daaronder. Eén vraag, drie gedragingen, geen extra modelaanroepen. Met een kaal label krijg je één gedrag en geen enkele manier om precisie tegen recall af te wegen.
Dit is de maatregel die ik bepleitte in het stuk over Anthropics oversight-cijfers: bepaal hoeveel items een mens per week beoordeelt en verschuif de drempel tot dat is wat binnenkomt. Die rekensom kun je niet op labels doen.
Lage confidence is precies het geval dat naar een trager, capabeler model zou moeten escaleren. De meeste routing gokt vandaag de complexiteit op basis van de invoer; een gekalibreerde score meet de onzekerheid over de uitvoer, en dat is wat je eigenlijk wilde weten.
Het belangrijke woord is gekalibreerd. Elk model geeft een getal als je erom vraagt, en de softmax-kans op een token is geen uitspraak over juistheid. Of de kalibratie van Jev standhoudt is precies het soort ding dat meting door derden nodig heeft — en die heeft het niet gehad.
TypeSafe claimt dat Jev een gegarandeerd foutpercentage van 0% op structured output heeft, gepresenteerd als een wiskundige eigenschap van de architectuur en niet als een meetresultaat. Letterlijk genomen, en ik heb geen reden eraan te twijfelen, betekent dat dat het model niets kan teruggeven buiten het schema dat je hebt gedeclareerd.
Vorm is geen juistheid
Een garantie over het type is een garantie dat het antwoord goed gevormd is, niet dat het klopt. Vraag je welke van elf tools moet worden aangeroepen, dan krijg je altijd een van de elf — en dat kan elke keer de verkeerde van de elf zijn, zonder parsefout die je waarschuwt. Daar moet je helder over zijn, want "hallucineert nooit" doet al de ronde als omschrijving van dit model, en het betekent iets veel smallers dan het klinkt: het hallucineert nooit een vorm. Niets in de architectuur voorkomt een zelfverzekerd foute classificatie.
Dat gezegd: malformed output elimineren is een echte operationele winst, en wie ooit een agent heeft opgeleverd weet waarom: het pad van opnieuw proberen na een parsefout is waar een verrassende hoeveelheid latency, kosten en vreemd gedrag huist. Een hele klasse faalgevallen wegnemen is iets waard, ook als het niet de klasse is waar je het meest wakker van ligt.
Voordat je hier welk product dan ook beoordeelt: zoek uit of de premisse jouw systeem beschrijft. Dat is een uur werk en het antwoord blijft geldig, welke leverancier je uiteindelijk ook kiest.
Instrumenteer elke modelaanroep die je agent doet en deel ze in:
| Categorie | Toets | Wat het je vertelt |
|---|---|---|
| Beslissing | De uitvoer wordt teruggebracht tot een enum, een boolean of een getal | Kandidaat voor een classifier |
| Extractie | De uitvoer is een klein vast schema uit een grotere invoer | Kandidaat, als het schema stabiel is |
| Generatie | De uitvoer is proza dat een mens of een ander systeem leest | Blijft op een taalmodel |
| Redenering | De uitvoer is een plan in meerdere stappen waarvan de tussenstappen ertoe doen | Blijft, en waarschijnlijk op je beste model |
Reken daarna twee getallen uit: het aandeel aanroepen in de eerste twee categorieën, en het aandeel uitgaven. In de meeste agent-stacks die ik heb gezien is het eerste getal hoog en het tweede lager maar bij lange na niet evenredig — beslissingen zijn meestal korte prompts, dus afzonderlijk goedkoop en talrijk genoeg om in totaal mee te tellen, en ze domineren de latency omdat ze op het kritieke pad van elke ronde staan.
De grens die ik zou aanhouden:
Zijn beslissingen en extractie samen minder dan een derde van je aanroepen, dan is dit een optimalisatie en moet je het negeren tot er iets anders is opgelost. Zijn ze meer dan twee derde — het gebruikelijke geval bij alles met een tool-loop — dan zitten er al twee workloads in je architectuur en ben je één leverancierskeuze verwijderd van ze kunnen splitsen.
Jev is early access, dus de praktische vraag is wat je nu kunt doen. Drie opties, in oplopende inspanning.
Bundel de vragen die je al stelt. De goedkoopste winst hier heeft niets met nieuwe modellen te maken. Doet je loop vier losse aanroepen om vier dingen over dezelfde state te beslissen, stel die vier dan in één aanroep met een gestructureerd schema. Je betaalt de state één keer in plaats van vier.
Verplaats de makkelijke beslissingen nu al naar een klein model. "Is de taak klaar" heeft je beste model niet nodig. Een klein model met constrained decoding handelt de meeste poortvragen af, en je kunt het percentage onenigheid met je huidige model meten voordat je iets omzet.
Bouw de drempel voordat je de kans hebt. Schrijf de poort met twee niveaus — blokkeren erboven, review ertussen, loggen eronder — ook al is het middelste niveau nog een stub. Komt er een gekalibreerde score, dan sluit je een getal aan in plaats van een control flow te herontwerpen.
Houd de evaluatieset modelonafhankelijk. Wil je ooit een beslissing naar een classifier verplaatsen, dan is wat er een klus van twee uur in plaats van twee weken van maakt: een gelabelde set met de invoer van die beslissing en de juiste antwoorden. De meeste teams hebben die voor hun end-to-end-taak en helemaal niet voor de losse beslissingen daarbinnen.
Die laatste is de echte voorwaarde. Je kunt een beslissing niet veilig naar een goedkoper model verplaatsen zonder manier om te zien of hij slechter werd, en die set bouwen is werk dat je jezelf verschuldigd bent, of er ooit een System One-model in beeld komt of niet.
Elk prestatiecijfer hier is zelf gerapporteerd. Geen onafhankelijke partij heeft Jev gebenchmarkt. Het model zit achter een wachtlijst, de evaluaties zijn niet op publieke benchmarks, en de vergelijkingscijfers komen van het bedrijf dat het product verkoopt. Dat maakt ze niet onwaar; het maakt ze ongeverifieerd, en ze verdienen precies de korting die je op de eigen cijfers van elke leverancier zou toepassen.
TypeSafe publiceert zijn eigen methodologische grenzen, en die zijn reëel. De workflow-evaluaties zijn gebouwd door het eigen model capabilities-team, waarvan het bedrijf erkent dat dat ze kan vertekenen. De vergelijkingsbasis is het gemiddelde van twee frontier-modellen. De demo's gebruikten vereenvoudigde queries met leesbare sleutels. Alle lof voor het publiceren daarvan; het doet er niet minder toe.
"193,6× sneller, 444,6× goedkoper" is een plafond, geen verwachting. TypeSafe zegt dat zelf: het verwacht dat deze aan de bovenkant van de praktijkwinst liggen. Het kopcijfer citeren als wat jij krijgt, is het voorbehoud van het bedrijf verkeerd lezen.
Ik heb het niet gebruikt. Alles hierboven is gelezen uit gepubliceerd materiaal. Ik beveel de architectuurvraag aan, niet het product.
De kalibratieclaims zou ik het liefst gecontroleerd zien. Het is het deel met echte technische waarde en het deel dat van buitenaf het moeilijkst te verifiëren is, en een kalibratiecurve die op de workflows van de leverancier standhoudt hoeft dat op de jouwe niet te doen. Doe je een pilot, meet de kalibratie dan op je eigen data voordat je een drempel aan iets belangrijks hangt.
Over de lancering zal op de cijfers worden gediscussieerd, en die discussie kan buiten het bedrijf nog niemand beslechten.
Het deel dat niet van de cijfers afhangt is de opsplitsing. Een agent-loop is vooral een beslismachine met achteraan een schrijver eraan geschroefd, en de sector bedient beide helften al twee jaar vanuit hetzelfde onderdeel omdat dat het enige beschikbare was. Iemand zou het opmerken. Dat er nu een leverancier, een trainingsmethode en een LangChain-integratie aan die observatie hangen, is minder interessant dan de observatie zelf.
Instrumenteer je agent en zoek uit welk deel van zijn modelaanroepen iets teruggeeft dat je meteen terugbrengt tot één waarde. Is dat getal twee derde, dan heb je al twee workloads — en je had ze hoe dan ook moeten splitsen, wie de tweede uiteindelijk ook verkoopt.
Bronnen: LangChain, "Building a harness with Jev", door Sydney Runkle en Hunter Lovell, 17 september 2026 — de harness-framing, de vraagtypen en de use cases routing en guardrail. TypeSafe AI, "Introducing System One Models & Jev" — de System One-definitie, de parallelle sampler, RLCD, het latencybereik van 70–500 ms, de $0,042 per miljoen invoertokens met gratis uitvoer, de workflowcijfers 193,6× en 444,6×, de claim van nul typefouten en de methodologische voorbehouden die in paragraaf 7 worden aangehaald, alle van TypeSafe zelf. Een praktische gids voor Jev — het SDK-oppervlak, het plafond van 255 opties op Choice, en de contextlimieten van 64k totaal en 32k state. MindStudio, "RLCD vs RLHF" — het ontbreken van enige onafhankelijke verificatie. Het opsplitsingsargument, het pleidooi voor kalibratie boven snelheid, het onderscheid vorm-versus-juistheid en alle aanbevelingen zijn van mij. Voor de kostenmechaniek waar dit bovenop zit, zie elk bestand dat je agent leest blijft op de rekening staan, en voor het drempelargument zie Anthropics cijfers over agent-oversight.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.