OpenAI zet een watermerk op ChatGPT-tekst in de EU. In de API staat het uit, tenzij je het aanzet

By Surya Pratap
18 oktober 2026
8 min read
AI & Technology

18 oktober 2026
8 min read
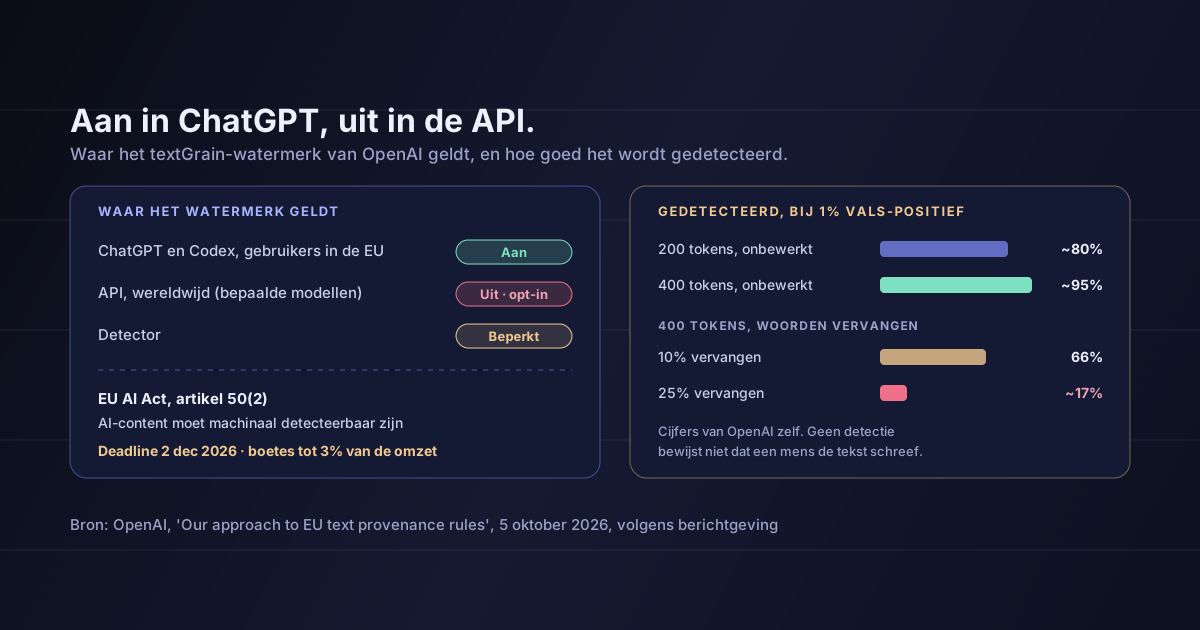 Aan in ChatGPT, uit in de APIHover to explore
De meeste berichtgeving over het watermerk van OpenAI ging over de vraag of je straks kunt zien dat een werkstuk uit ChatGPT komt. Voor founders zit het nuttigste detail in één regel van de aankondiging: in de API blijft het watermerk standaard uit. De compliance van ChatGPT is het werk van OpenAI. Een product dat op de API is gebouwd, moet misschien zelf een keuze maken.
Dit artikel is gebaseerd op de aankondiging van OpenAI "Our approach to EU text provenance rules" van 5 oktober 2026, zoals gerapporteerd door TechCrunch, The Next Web, Techstrong.ai en Gadget Review. De detectiecijfers zijn van OpenAI zelf. De analyse vanaf sectie 3 is van mij en is geen juridisch advies.
Het watermerk heet textGrain. Het voegt geen verborgen tekens of metadata toe. In plaats daarvan "stuurt het subtiel de woordkeuze van het model", met pseudowillekeurige waarden die aan een geheime sleutel zijn gekoppeld. De tekst leest normaal, maar bevat een statistisch patroon dat een detector kan vinden. Omdat het patroon in de woorden zelf zit, overleeft het kopiëren en plakken.
Waar het geldt:
Volgens OpenAI verandert het watermerk niets wezenlijks aan de prestaties van het model. De methode staat beschreven in een technisch rapport dat samen met onderzoekers van de University of Pennsylvania en Yale is geschreven.
Artikel 50(2) van de AI Act verplicht dat AI-content zo wordt gemarkeerd dat die in een machineleesbaar formaat detecteerbaar is. De transparantieregels gelden sinds 2 augustus 2026, en aanbieders die al op de markt waren, hebben tot 2 december 2026 om eraan te voldoen. Volgens Techstrong.ai kunnen de boetes oplopen tot 3% van de wereldwijde jaaromzet.
Ook andere labs zijn in beweging. Anthropic begon in augustus wereldwijd met een watermerk op tekst van Claude, met enkele uitzonderingen, via een vergelijkbare statistische aanpak waarvan de detector ook beperkt beschikbaar is.
De cijfers van OpenAI, bij 1% vals-positief:
| Passage | Gedetecteerd |
|---|---|
| 200 tokens, onbewerkt | ongeveer 80% |
| 400 tokens, onbewerkt | ongeveer 95% |
| 400 tokens, 10% van de woorden vervangen door synoniemen | 66% (van ongeveer 92%) |
| 400 tokens, 25% van de woorden vervangen | ongeveer 17% |
Detectie is ook zwakker bij korte passages, wiskundeantwoorden en vertaalde tekst.
OpenAI is ongewoon direct over wat dit bewijst. textGrain "garandeert geen betrouwbare detectie", en geen detectie "bewijst niet dat een mens de tekst schreef". Het kan niet zeggen hoeveel iemand een passage heeft bewerkt, of die klopt, of wie hem genereerde.
Een watermerk vertelt een detector dat een model waarschijnlijk de meeste van deze woorden schreef. Het kan niemand vertellen dat een mens dat niet deed.
Dit is het deel dat plannen verandert. Leest een EU-gebruiker tekst in ChatGPT, dan is OpenAI de aanbieder en staat het watermerk aan. Leest een EU-gebruiker tekst in jouw product, gegenereerd via de API, dan staat het watermerk uit tenzij jij het aanzet.
Of de markeringsplicht uit de AI Act bij jou ligt, hangt af van je rol — bijvoorbeeld of je een eigen AI-systeem op de EU-markt brengt of het systeem van een ander inzet — en dat is een vraag voor een jurist, niet voor een blog. Maar deze stappen zijn hoe dan ook de moeite waard:
Zoek uit of je eronder valt. Maak een lijst van functies die tekst genereren voor EU-gebruikers, met welk model, en of die tekst wordt gepubliceerd of gedeeld. Leg die lijst vóór 2 december voor aan je jurist, niet erna.
Kies de API-instelling bewust. Aanzetten is een configuratiewijziging voor ondersteunde modellen. Laat je het uit, leg dan vast waarom. Werk je met meerdere aanbieders, check ze dan allemaal: hun watermerken en standaardinstellingen verschillen.
Vertel gebruikers wat je doet. Krijgt je output een watermerk, zeg dat dan waar het ertoe doet, vooral tegen gebruikers die de tekst publiceren. Krijgt die geen watermerk, suggereer dan niet dat dat wel zo is. Hoe dan ook hoort het in dezelfde vastlegging van wat je belooft en wat je doet waar toezichthouders nu om vragen.
Verkoop nooit "ondetecteerbaar". Een tool die belooft watermerken te verwijderen of te omzeilen, bouwt aan de verkeerde kant van een transparantiewet, en roept overal elders vragen over misleiding op.
Recruitmenttools, plagiaatcheckers, publicatieplatforms en onderwijsproducten zien watermerken al snel als het antwoord. Dat zijn ze nog niet:
Neem er geen beslissingen over mensen mee
Geeft je product iemand een score, een vlag of een afwijzing omdat de tekst "er AI-gegenereerd uitziet", dan maakt een watermerk die beslissing niet veilig. Gebruik het, als dat ooit kan, als één signaal dat een mens beoordeelt — nooit als de reden dat iemand een sollicitatie of een cijfer misloopt.
Dat elke API-klant een watermerk moet gebruiken. De verplichtingen hangen af van je rol onder de AI Act. Dat OpenAI het standaard uit laat, suggereert dat het de API niet automatisch gedekt ziet door de eigen compliance van ChatGPT, maar dat is geen juridische uitspraak.
Dat de detectiecijfers onafhankelijk zijn. Ze zijn van OpenAI, uit het eigen rapport.
Dat watermerken de herkomst van AI-tekst oplossen. Het markeert tekst van de modellen van één aanbieder, detecteerbaar met de beperkte tool van die aanbieder. Tekst van andere modellen, of sterk bewerkte tekst, valt erbuiten.
Dat 2 december het laatste woord is. Deadlines en richtsnoeren onder de AI Act zijn eerder verschoven. Check de actuele stand als je in actie komt.
OpenAI zet met textGrain een watermerk op tekst van ChatGPT en Codex in de EU, vóór de AI Act-deadline van 2 december voor machinaal detecteerbare AI-content. In de API is het watermerk opt-in voor bepaalde modellen en staat het standaard uit. Detectie werkt goed bij langere, onbewerkte passages en slecht bij korte of bewerkte, is niet beschikbaar voor het publiek en bewijst nooit dat een mens iets schreef.
Voor startups is de vraag niet of ChatGPT compliant is. De vraag is of je eigen product voor EU-gebruikers markering nodig heeft, en of je die keuze bewust hebt gemaakt.
Maak vóór 2 december een lijst van elke functie die AI-tekst naar EU-gebruikers stuurt, check de watermerkinstelling van elke aanbieder en leg beide voor aan je jurist. En beoordeelt je product mensen op de vraag of hun tekst door AI is geschreven: stop met vertrouwen op een detector die je niet kunt draaien.
Bronnen: OpenAI, "Our approach to EU text provenance rules", 5 oktober 2026, zoals gerapporteerd door TechCrunch — de naam en werking van textGrain, dat het kopiëren en plakken overleeft, de uitrol in ChatGPT en Codex in de EU, de opt-in in de API, de beperkte detector, het uitblijven van prestatieverlies, de cijfers van 92% en 66%, het rapport met de University of Pennsylvania en Yale, en de uitspraak dat het "geen menselijk auteurschap bewijst". The Next Web — dat de API standaard uit staat, de deadline van 2 december voor aanbieders die al op de markt zijn, en het wereldwijde watermerk van Anthropic sinds augustus. Techstrong.ai — artikel 50(2), de ingangsdatum van 2 augustus, boetes tot 3% van de wereldwijde omzet en het cijfer van 17% na 25% bewerking. Gadget Review — detectie van ongeveer 80% bij 200 tokens en 95% bij 400 tokens bij 1% vals-positief, en de uitspraak dat textGrain "geen betrouwbare detectie garandeert". De analyse in sectie 4 tot en met 6 is van mij en is geen juridisch advies.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.