Met de zakelijke voorwaarden van Meta mogen zijn crawlers vanaf 30 oktober je website op. Meta schrapte "train", niet het crawlen

By Surya Pratap
19 oktober 2026
8 min read
Startup Strategy

19 oktober 2026
8 min read
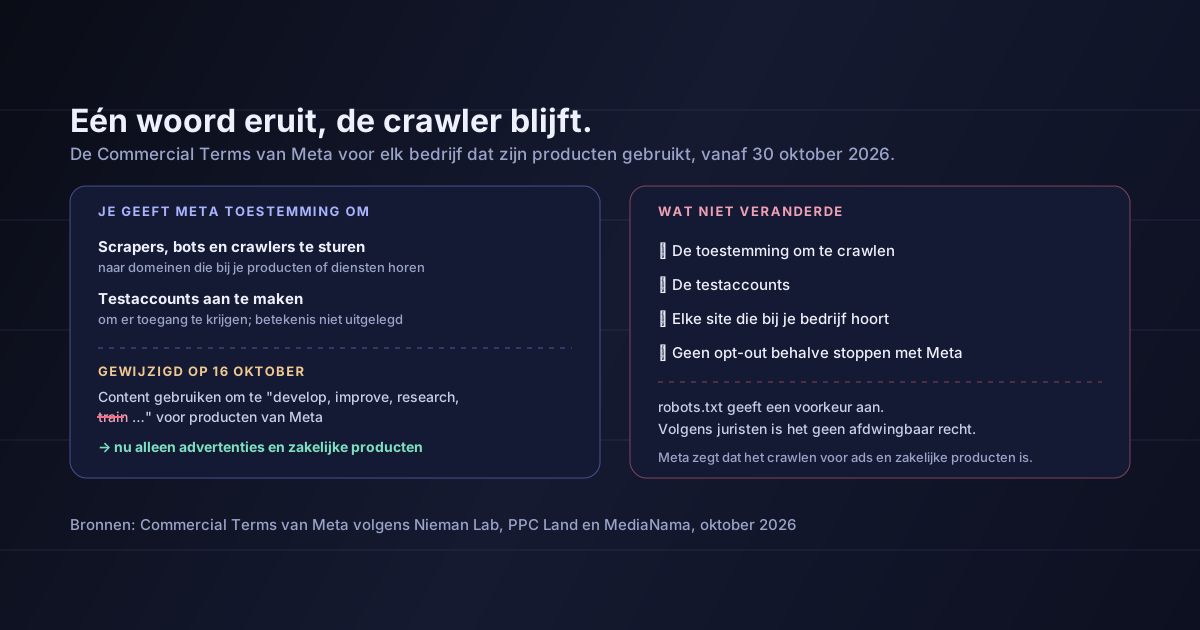 Eén woord eruit, de crawler blijftHover to explore
De meeste founders hebben de zakelijke voorwaarden van Meta geaccepteerd zonder ze te lezen. Je had een Facebookpagina, een zakelijk Instagram-profiel of een advertentieaccount nodig, en de voorwaarden kwamen erbij. De versie die op 30 oktober ingaat, is het lezen waard, want één alinea gaat over je website, niet over je Meta-accounts.
Dit artikel is gebaseerd op de tekst van de crawlalinea zoals geciteerd door PPC Land, op de berichtgeving van Nieman Lab (eerste artikel, vervolg) en op berichtgeving van MediaNama. Ik heb de volledige herziene tekst niet gezien; de beschrijving van de wijziging komt uit die berichtgeving. De analyse vanaf sectie 3 is van mij en is geen juridisch advies.
De Commercial Terms van Meta gelden voor bedrijven die de producten commercieel gebruiken: Facebookpagina's, zakelijke Instagram-accounts, Meta Business Suite, advertenties. De versie voor 30 oktober bevatte deze alinea, hier in de oorspronkelijke Engelse tekst:
"You authorise us (or any entity acting on our behalf) to use automated software (such as web scrapers, bots, robots, spiders, crawlers and user agents) and create test credentials to access, index, cache, analyse, collect, retrieve or crawl the domains, web pages or URLs (and any content available through them) that are associated with your products or services, or that are made available through your or users' use of Meta Company Products and services, and to periodically pull updates from such domains, web pages or URLs. Meta may use any content from such domains, web pages or URLs to provide, develop, improve, research, train and maintain the integrity of, the Meta Company Products, services and features provided under these Commercial Terms and any other applicable supplemental terms."
Drie onderdelen zijn belangrijk:
Op 15 oktober publiceerde Nieman Lab het oordeel van drie juristen dat de alinea, zoals die er stond, kon worden gebruikt om te betogen dat Meta nieuwssites mag scrapen en de content mag gebruiken om zijn AI te trainen. Bijna elke nieuwsorganisatie heeft een zakelijk Meta-account. Meta-woordvoerder Andy Stone noemde berichten dat de voorwaarden het scrapen van nieuwssites zouden toestaan "onjuist".
Op 16 oktober paste Meta de voorwaarden aan. Volgens de berichtgeving:
Een woordvoerder van Meta zei: "We hebben jullie gehoord en willen het verduidelijken: de crawlvoorwaarden die we hebben samengevoegd, golden alleen voor onze advertentie- en zakelijke producten," en voegde eraan toe dat "eigenaren van content robots.txt kunnen gebruiken om hun voorkeuren aan te geven."
De wijziging veranderde wat Meta zegt met de content te doen. Volgens de berichtgeving veranderde ze niets aan de toestemming om die te verzamelen:
Juristen waren niet gerustgesteld. James Grimmelmann van Cornell zei tegen Nieman Lab dat de herziene tekst nog steeds ruim genoeg was om AI-training te dekken. Benjamin Sobel van de University of Wisconsin wees erop dat robots.txt een voorkeur uitdrukt maar geen afdwingbaar recht geeft om scrapen te voorkomen. Uitgeversverenigingen uit Europa, het VK en de VS hebben toezichthouders gevraagd in te grijpen.
Meta haalde het woord weg dat beschreef wat het met je content mag doen. De alinea waarmee het die content mag verzamelen, bleef staan.
Dit is niet alleen een probleem van uitgevers. Heb je een Facebookpagina, een zakelijk Instagram-account of draai je Meta-advertenties, dan ben je partij bij deze voorwaarden, en je website "hoort bij je producten of diensten".
Breng in kaart wat bereikbaar is. Zet de domeinen op een rij die aan je Meta-accounts en advertenties gekoppeld zijn: marketingsite, docs, blog, helpcenter, app. Bepaal welke je oké vindt om door een derde te laten crawlen, cachen en analyseren onder voorwaarden waar je niet over hebt onderhandeld.
Scheid marketing van product. Houd je product op een eigen subdomein, achter eigen authenticatie. Een testaccount dat door de crawler van een ander is aangemaakt, mag geen klantdata zien, geen prijzen die je privé afspreekt en niets achter een login dat je niet aan een vreemde zou laten zien.
Geef je voorkeur toch aan. Robots.txt is niet afdwingbaar, maar het is wel het signaal waar Meta zelf naar verwijst. Stel regels in voor de crawlers die Meta publiceert, en voor AI-crawlers in het algemeen, op de domeinen die ertoe doen. Check daarna je serverlogs om te zien wat er echt binnenkomt.
Let op onbekende aanmeldingen. "Testaccounts" betekent accounts. Kijk naar registraties en logins die zich niet als klanten gedragen, en bepaal vooraf wat je doet als ze geautomatiseerd blijken te zijn.
Lees de voorwaarden die je hebt weggeklikt
Zet een herinnering om de zakelijke voorwaarden te lezen van elk platform waar je van afhankelijk bent — Meta, Google, LinkedIn, je betaalprovider, je cloud — zodra ze veranderen. De clausules die ertoe doen voor een startup in het AI-tijdperk gaan over crawlen, contentgebruik en training, en ze staan steeds vaker in voorwaarden die je accepteerde om te adverteren, niet in een contract waarover je hebt onderhandeld.
Is je content je product — een kennisbank, een dataset, eigen onderzoek, betaalde artikelen — dan weegt dit nog zwaarder. Ons GEO-playbook gaat over geciteerd worden door AI-systemen; dit is de andere kant van dezelfde vraag: verzameld worden zonder dat iemand het je vraagt.
Sommige founders lezen dit verhaal van de andere kant. Hangt je product af van het crawlen van andermans sites, kijk dan naar wat er gebeurde: een bedrijf met de macht van Meta zette toestemming om te crawlen en te trainen in voorwaarden waar klanten niet over konden onderhandelen, en de ophef dwong binnen een dag tot een wijziging.
De les gaat niet over de juridische positie van Meta; daar zijn advocaten het niet over eens. De les is dat toestemming die in platformvoorwaarden verstopt zit fragiel is, publiek en commercieel. Trainingsdata waarvoor je een licentie hebt, of waarvoor eigenaren duidelijk toestemming gaven, kost meer moeite om te krijgen en is veel moeilijker af te pakken. En als een toezichthouder vraagt, zoals de FTC net aan OpenAI en Anthropic vroeg, hoe je claims zich verhouden tot je praktijk, is "de voorwaarden stonden het toe" een zwak antwoord.
Dat Meta AI traint op jouw website. Meta zegt dat het crawlen alleen voor advertenties en zakelijke producten is, en noemde berichten over het scrapen van nieuwssites onjuist. De voorwaarden zeggen wat Meta mag, niet wat het doet.
Dat de herziene voorwaarden AI-training toestaan. Sommige juristen vinden de tekst nog steeds ruim genoeg; Meta is het daar niet mee eens. Geen rechter heeft zich erover uitgesproken.
Dat ik de definitieve tekst ken. De herziene tekst is hier beschreven op basis van berichtgeving; check de voorwaarden die Meta vóór 30 oktober publiceert.
Dat robots.txt je beschermt. Het geeft een voorkeur aan. Zoals Sobel opmerkte, levert het geen afdwingbaar recht op.
Vanaf 30 oktober geeft elk bedrijf dat producten van Meta gebruikt Meta toestemming om scrapers en crawlers te sturen, en testaccounts aan te maken, naar de websites die bij zijn producten horen. Meta behield zich eerst het recht voor om die content te gebruiken om zijn producten te trainen; na de berichtgeving van Nieman Lab haalde het "train" weg en beperkte het het gebruik tot advertenties en zakelijke producten. Het crawlen, de testaccounts, de ruime reikwijdte en het ontbreken van een opt-out blijven, en juristen zeggen dat de herziene tekst nog altijd ruim is.
Voor startups is de praktische conclusie simpel. Hoe blootgesteld je website is, hangt nu deels af van voorwaarden die je accepteerde om een Facebookpagina te hebben.
Zet vóór 30 oktober alle domeinen op een rij die aan je Meta-accounts gekoppeld zijn, zet alles wat gevoelig is achter eigen authenticatie, stel in robots.txt je voorkeuren in voor de crawlers van Meta en andere AI-crawlers, en houd je logs en aanmeldingen in de gaten op geautomatiseerde bezoekers.
Bronnen: PPC Land — de volledige tekst van de crawlalinea zoals oorspronkelijk gepubliceerd voor 30 oktober 2026, voor wie die geldt, en dat Meta weigerde testaccounts toe te lichten. Nieman Lab, 15 oktober 2026 — de lezing van de drie juristen. Nieman Lab — de herziening en het oordeel van experts dat die ruim blijft. MediaNama — het schrappen van "train", de beperking tot advertenties en zakelijke producten, de verklaring van de Meta-woordvoerder over robots.txt, de reacties van James Grimmelmann en Benjamin Sobel, het ontbreken van een opt-out en de oproepen van uitgeversverenigingen. De herzieningsdatum van 16 oktober, de uitspraak van Andy Stone over "onjuiste" berichten en het vrijwel universele gebruik van zakelijke Meta-accounts door nieuwsorganisaties komen uit berichtgeving over de artikelen van Nieman Lab. De analyse in sectie 3 tot en met 6 is van mij en is geen juridisch advies.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.