Op 1 december draaien je gemini-2.5-pro-calls ineens op Gemini 3.8 Flash. Pas de modelnaam zelf aan voordat Google het voor je doet

By Surya Pratap
19 november 2026
8 min read
AI & Technology

19 november 2026
8 min read
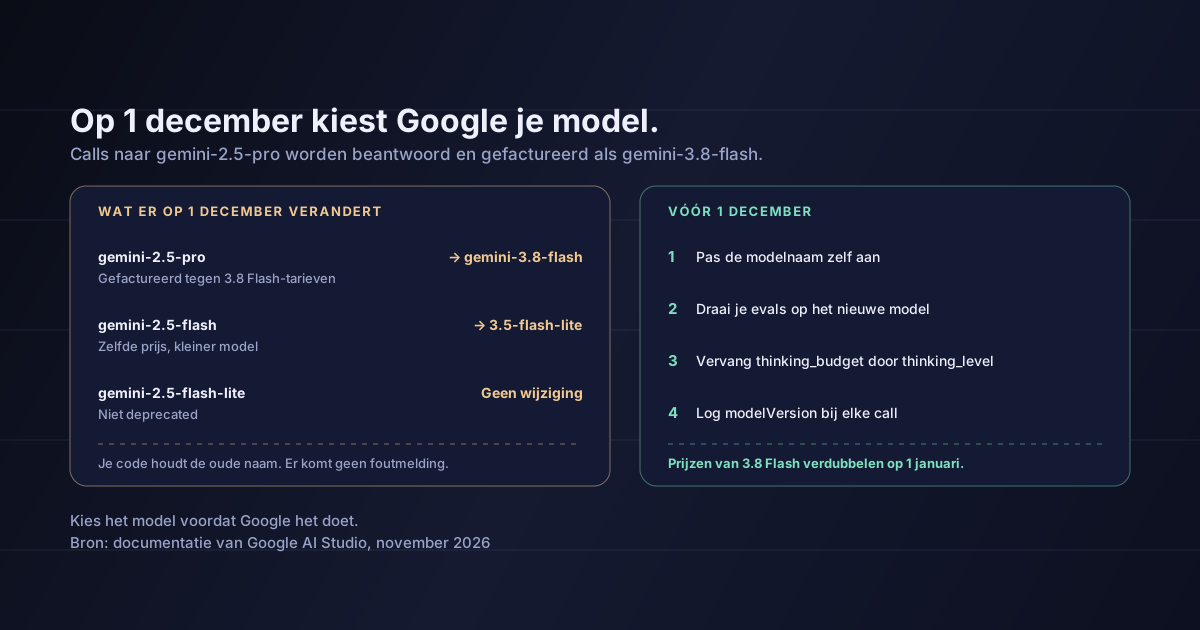 Bekijk wat wordt doorgestuurd, en wat je eerst doetHover to explore
De meeste uitfaseringen van modellen eindigen met een foutmelding. Je verzoeken falen, je alerts gaan af en je migreert. Google heeft voor twee van zijn meestgebruikte modellen een ander einde gekozen. Vanaf 1 december falen verzoeken aan gemini-2.5-pro en gemini-2.5-flash niet. Een ander model beantwoordt ze, tegen de prijs van dat model, terwijl je code nog steeds om het oude vraagt. Niemand waarschuwt je. Precies daarom verdient het deze week je aandacht.
Op 2 november markeerde Google beide modellen als deprecated en koos voor allebei dezelfde datum:
gemini-2.5-pro: "Vanaf 1 december 2026 worden alle API-verzoeken aan gemini-2.5-pro automatisch doorgestuurd naar gemini-3.8-flash en gefactureerd tegen de tarieven van Gemini 3.8 Flash." Het model staat al niet meer in de modelkiezer van Google AI Studio.gemini-2.5-flash: vanaf dezelfde datum worden verzoeken "automatisch doorgestuurd naar gemini-3.5-flash-lite en gefactureerd tegen de tarieven van Gemini 3.5 Flash-Lite".gemini-2.5-flash-lite: niet deprecated. Volgens Google "blijft het tot nader order beschikbaar via de API".thought_signature, thinking_level dat thinking_budget vervangt, en het verdwijnen van samplingparameters en vooraf ingevulde modelbeurten".Googles advies is helder: pas je modelnaam aan vóór 1 december en lees de migratiegids van het nieuwe model.
Een uitfasering die fouten geeft, maakt lawaai. Je weet het binnen een paar minuten. Een uitfasering die doorverwijst, is stil. Je logs tonen geslaagde responses, je dashboards blijven groen, en de enige signalen zijn de signalen waar je niet op lette: antwoorden die anders klinken, een supportticket over een functie die "slechter is geworden", een kostenregel die is verschoven.
Kijk wat elke route doet. gemini-2.5-pro is een Pro-model; de vervanger is een Flash-model. gemini-2.5-flash gaat naar een Flash-Lite-model. Misschien heeft Google gelijk dat de nieuwere, kleinere modellen voor het meeste verkeer goed genoeg zijn. Maar "het meeste verkeer" is Googles gemiddelde, niet jouw product. Als je voor 2.5 Pro koos omdat een goedkoper model door je tests zakte, draait 1 december die keuze terug zonder het je te vragen.
Een uitfasering die faalt, vertelt je dat het gebeurd is. Een uitfasering die doorverwijst, vertelt het je alleen als je kijkt.
Een ander model. De doorgestuurde verzoeken worden beantwoord door gemini-3.8-flash of gemini-3.5-flash-lite. Beide lezen tot 1.048.576 tokens en schrijven tot 65.536, dus contextlimieten worden het probleem niet. De kwaliteit op jouw taken is de open vraag.
Andere standaardwaarden. Googles thinking-tabel vermeldt dat gemini-3.5-flash-lite standaard op minimal staat, en gemini-3.8-flash op medium. Voor 3.8 Flash meldt Google dat "minimal niet wordt ondersteund en een fout geeft". Als je het denkniveau nooit expliciet hebt ingesteld, verandert de hoeveelheid redenering achter je antwoorden vanzelf.
Een ander API-contract. De brekende wijzigingen zijn niet cosmetisch. thinking_level vervangt thinking_budget. Function calling valideert nu thought_signature. Samplingparameters verdwijnen, en vooraf ingevulde modelbeurten ook. Google zegt niet wat een doorgestuurd verzoek krijgt dat nog de oude parameters meestuurt: een fout, of een instelling die stilletjes wordt genegeerd. In beide gevallen wil je dat eerder weten dan je gebruikers.
Een andere rekening. Verzoeken worden gefactureerd tegen de tarieven van het nieuwe model. De berekening staat in de volgende sectie, en daar zit een tweede datum in.
Per miljoen tokens, volgens Googles prijspagina:
| gemini-2.5-pro nu | gemini-3.8-flash tot 31 december | gemini-3.8-flash vanaf 1 januari 2027 | |
|---|---|---|---|
| Input, prompts tot 200K tokens | $1,25 | $0,75 | $1,50 |
| Input, prompts boven 200K tokens | $2,50 | $0,75 | $1,50 |
| Output, prompts tot 200K tokens | $10,00 | $3,75 | $7,50 |
| Output, prompts boven 200K tokens | $15,00 | $3,75 | $7,50 |
3.8 Flash heeft tot 31 december een introductieprijs. Neem een agentstap met 50.000 inputtokens en 5.000 outputtokens. Op 2.5 Pro kost die ongeveer $0,11. Doorgestuurd in december ongeveer $0,06. Vanaf januari weer ongeveer $0,11. Een stap met veel input, 150.000 inputtokens en 2.000 outputtokens, kost nu ongeveer $0,21, in december $0,12 en in januari $0,24: meer dan je nu betaalt.
Voor gemini-2.5-flash verandert de prijs niet. 2.5 Flash en 3.5 Flash-Lite staan allebei op $0,30 per miljoen inputtokens en $2,50 per miljoen outputtokens. Je betaalt hetzelfde voor een kleiner model.
# gemini_call.py — choose the model explicitly and log what served it
import logging
from google import genai
from google.genai import types

log = logging.getLogger("llm")
client = genai.Client()

MODEL = "gemini-3.8-flash"   # was "gemini-2.5-pro": change it before 1 December

def ask(prompt: str) -> str:
    resp = client.models.generate_content(
        model=MODEL,
        contents=prompt,
        config=types.GenerateContentConfig(
            # thinking_level replaces thinking_budget on Gemini 3 models
            thinking_config=types.ThinkingConfig(thinking_level="medium"),
        ),
    )
    # modelVersion: "the model version used to generate the response"
    log.info("requested=%s served=%s", MODEL, resp.model_version)
    return resp.text
Pas de naam zelf aan. Zoek naar gemini-2.5-pro en gemini-2.5-flash in je code, je configuratie, je promptrepository en eventuele no-codetools. Migreren op je eigen datum betekent dat je kunt testen, geleidelijk kunt uitrollen en kunt terugdraaien. Doorgestuurd worden op Googles datum geeft je niets daarvan.
Test de vervanger, en de alternatieven. Draai je evaluatieset op gemini-3.8-flash of gemini-3.5-flash-lite op elk denkniveau. Faalt een taak van Pro-niveau op Flash, test dan een groter model in plaats van de route te accepteren. Googles eigen opvolger is niet de enige optie.
Los eerst de brekende wijzigingen op. Vervang thinking_budget door thinking_level. Verwijder samplingparameters en vooraf ingevulde modelbeurten. Controleer je function-calling-code tegen de nieuwe thought_signature-validatie. Draai je tool-calling-tests van begin tot eind, niet alleen losse prompts.
Log modelVersion bij elke call. De API-referentie beschrijft het responseveld modelVersion als "de modelversie die is gebruikt om de response te genereren". Log het naast het model dat je hebt opgevraagd. Lopen die twee ooit uiteen, dan zie je het op de dag zelf, niet pas op de factuur van volgende maand.
Dezelfde dag verandert er nog een prijs
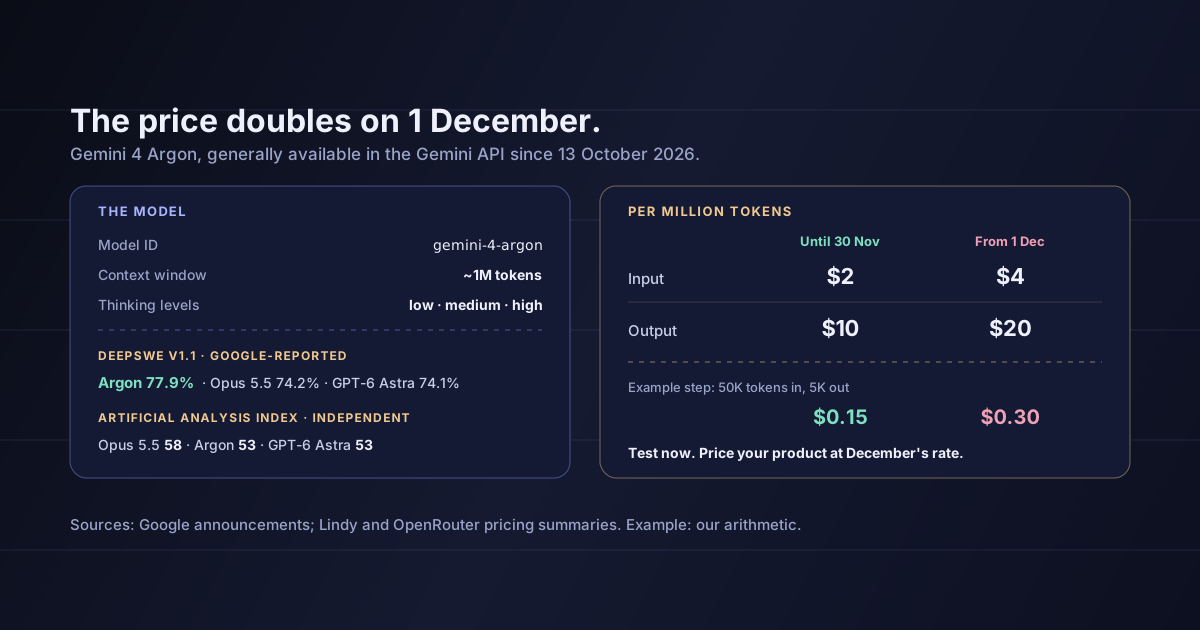
Op 1 december loopt ook de introductieprijs van Gemini 4 Carbon af. Googles prijspagina vermeldt $2 per miljoen inputtokens en $10 per miljoen outputtokens tot en met 30 november, daarna $4 en $20. Heb je tijdens de lanceringsperiode iets naar Carbon of Argon verplaatst, controleer dan ook die marges. We maakten dezelfde berekening voor Gemini 4 Argon.
Dat 3.8 Flash voor jou slechter is dan 2.5 Pro. Het is nieuwer en kan op veel taken beter zijn. Ik heb Google geen directe vergelijking van de twee op dezelfde taken zien publiceren. Je evaluatieset beslist.
Wat er op Vertex AI gebeurt. Het changelog, de uitfaseringspagina en de prijspagina die ik las, gaan over de Gemini API in Google AI Studio. Ze noemen Vertex AI niet. Roep je Gemini aan via Vertex, kijk dan naar het eigen uitfaseringsschema daarvan.
Hoe doorgestuurde verzoeken met oude parameters omgaan. Google noemt de brekende wijzigingen, maar zegt niet of een doorgestuurd verzoek met thinking_budget faalt of stilletjes wordt aangepast. Test het in plaats van het aan te nemen.
Dat de data definitief zijn. Googles uitfaseringspagina zegt dat de uitschakeldata "de vroegst mogelijke data zijn waarop een model kan worden uitgefaseerd". Ze kunnen later uitvallen. Plannen op 1 december blijft de veilige keuze.
Vanaf 1 december 2026 worden Gemini API-verzoeken aan gemini-2.5-pro beantwoord door gemini-3.8-flash en tegen dat tarief gefactureerd, en worden verzoeken aan gemini-2.5-flash beantwoord door gemini-3.5-flash-lite tegen een ongewijzigde prijs. gemini-2.5-flash-lite blijft buiten schot. Google noemt brekende API-wijzigingen voor de overstap, waaronder thinking_level dat thinking_budget vervangt, nieuwe validatie bij function calling en het verdwijnen van samplingparameters en vooraf ingevulde beurten. 3.8 Flash kost tot 31 december minder dan 2.5 Pro; vanaf 1 januari verdubbelt de prijs, en werk met veel input kost dan meer dan nu.
Het risico is niet het nieuwe model. Het risico is dat de wijziging plaatsvindt zonder foutmelding, zonder beslissing en zonder test.
Vervang vóór 1 december elke gemini-2.5-pro en gemini-2.5-flash door een model dat je hebt getest, los de brekende wijzigingen op en begin modelVersion te loggen, zodat je weet welk model elk verzoek heeft beantwoord.
Bronnen: Google AI Studio, Gemini API-changelog, bericht van 2 november 2026 — de uitfasering van gemini-2.5-pro en gemini-2.5-flash, de automatische doorverwijzing en facturering vanaf 1 december 2026, en de lijst met brekende API-wijzigingen. Uitfaseringen — release- en uitschakeldata, de status van gemini-2.5-flash-lite en de opmerking dat uitschakeldata de vroegst mogelijke zijn. Prijzen — de prijzen van gemini-2.5-pro, gemini-2.5-flash, gemini-3.8-flash, gemini-3.5-flash-lite en Gemini 4 Carbon. Gemini 3.8 Flash en Gemini 3.5 Flash-Lite — tokenlimieten en denkniveaus. API-referentie van generateContent — het responseveld modelVersion. Alles geraadpleegd op 19 november 2026. De kostenvoorbeelden en de interpretatie in de secties 2 tot en met 6 zijn van mij.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.