De evaluatieset voor je AI-MVP: test echte gebruikerstaken vóór de lancering

By Surya Pratap
16 juli 2026
7 min read
MVP Strategy

16 juli 2026
7 min read
Een AI-demo kan overtuigend ogen en toch falen in het werk dat een klant echt gedaan wil hebben. Hij kan een gepolijst antwoord geven waarin een verplicht feit ontbreekt, een document citeren dat de conclusie niet ondersteunt, of een actie uitvoeren die de gebruiker nooit bedoelde. Zulke fouten zie je moeilijk zolang elke testprompt ter plekke wordt verzonnen.
Het praktische antwoord voor een product in een vroege fase is geen gigantisch benchmarkprogramma. Het is een kleine evaluatieset: een geversioneerde verzameling echte taken, verwachte uitkomsten en duidelijke scoreregels die je draait zodra de prompt, het model, het retrieval-systeem of de workflow verandert. Zo wordt "dit voelt beter" bewijs dat je kunt vergelijken.
Founders beginnen vaak met de modelkeuze, omdat die zichtbaar is en makkelijk te bespreken. Maar gebruikers kopen geen model; ze kopen een betrouwbare uitkomst. Schrijf de taak die je product moet uitvoeren op in de woorden van een klant: "maak van deze supportthread een overdracht", "haal de verlengingsdatum uit dit contract" of "stel een antwoord voor op basis van alleen onze goedgekeurde kennisbank".
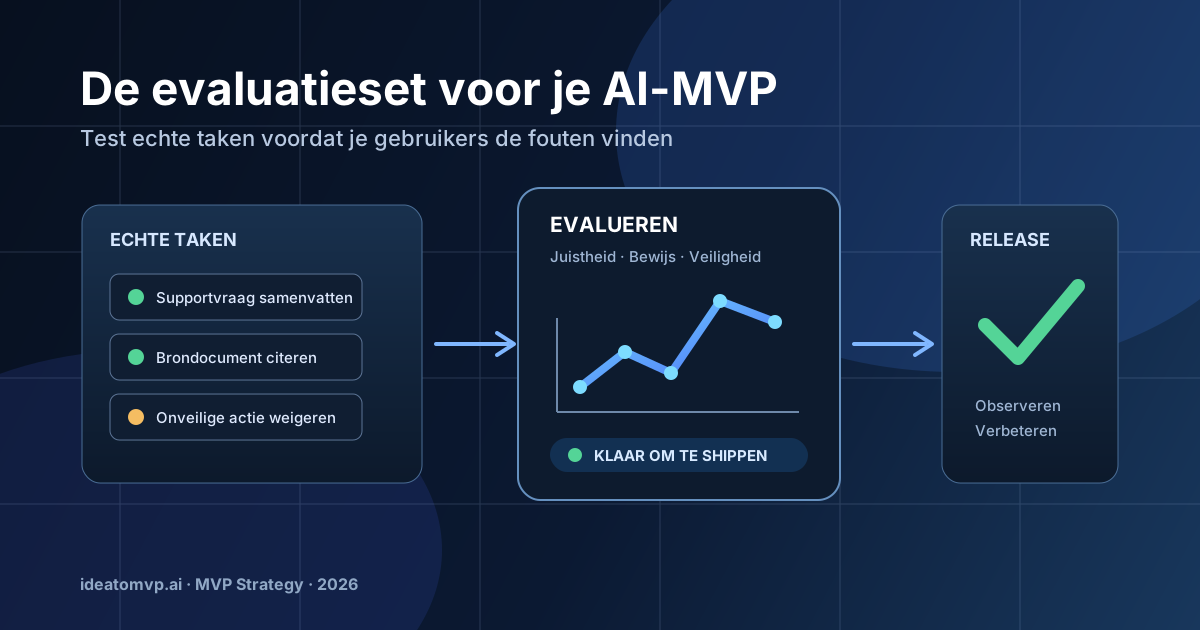
Elke taak wordt een testcase. Een bruikbare case bevat de input die een gebruiker zou geven, de context die je systeem mag gebruiken, de verwachte uitkomst en de fout die het resultaat onaanvaardbaar zou maken. Zo blijft de evaluatie gekoppeld aan productwaarde in plaats van aan een generieke benchmarkscore.
Je hebt geen honderden voorbeelden nodig om iets belangrijks te leren. Begin met 15 tot 20 cases uit discovery calls, handmatig uitgevoerd werk, klantinterviews, supporttickets of documenten die je mag gebruiken. Neem gewone gevallen mee, niet alleen spectaculaire randgevallen. Als de gewone taak fout gaat, is het product niet bruikbaar.
Bescherm klantdata bij het verzamelen van voorbeelden
Gebruik in je evaluatieset input waarvoor toestemming is gegeven, die is opgeschoond of die synthetisch is. Verwijder credentials, persoonsgegevens en overbodige klantcontext. Het gaat erom de taakstructuur en beslissingscriteria te bewaren, niet om nog een ongecontroleerde kopie van gevoelige data te maken.
Exacte string-matching is meestal te broos voor generatieve output. Beoordeel in plaats daarvan de eigenschappen die een bruikbaar resultaat bepalen. Bij een contractextractor kan dat betekenen dat de datum klopt, dat de bronpassage wordt genoemd en dat onzekerheid expliciet is als de datum ontbreekt. Bij een support-copilot kan het betekenen dat de samenvatting het probleem van de klant behoudt, geen verzonnen toezeggingen doet en de volgende goedgekeurde actie aanbeveelt.
In het begin werkt een eenvoudige rubric met drie niveaus goed: geslaagd voor een uitkomst waarop een gebruiker kan handelen, review nodig voor een deels bruikbaar resultaat en gezakt voor een wezenlijke fout, een ononderbouwde bewering of onveilig gedrag. Zet bij elk resultaat dat niet slaagt een korte reden. Die redenen zijn je product-backlog.
Eén score kan verbergen waarom een workflow nog niet klaar is om te shippen. Volg drie dimensies apart. Kwaliteit vraagt of het antwoord de taak oplost. Veiligheid vraagt of het systeem binnen het toegestane gedrag en de datagrens is gebleven. Operatie vraagt of de workflow snel genoeg reageert en tegen kosten die het bedrijf kan dragen.
Die scheiding maakt afwegingen zichtbaar. Een groter model kan een lastige redeneertaak verbeteren, maar de responstijd opdrijven tot voorbij wat een assistent in het product verdraagt. Een retrieval-update kan de relevantie verbeteren en tegelijk meer onderbouwingsloze citaten opleveren. Door elke dimensie los te behandelen kun je beslissen of je moet bijstellen, anders routeren, een menselijk controlepunt toevoegen of de scope van de feature verkleinen.
Draai dezelfde cases voor en na elke betekenisvolle wijziging: een herschreven prompt, een nieuw model, aangepaste systeeminstructies, nieuwe retrieval-chunks of een nieuwe tool voor de agent. Release niet omdat de nieuwste output in één gesprek indruk maakt. Release wanneer de wijziging de uitkomsten waar je gebruikers om geven verbetert of behoudt, en geen nieuwe veiligheidsfouten veroorzaakt.
Je eerste evaluatieset is geen certificering. Het is een gedisciplineerde productgewoonte. Bewaar de cases, de verwachte uitkomsten, de scoringsrubric en de resultaten naast het werk aan de feature. Geef elke case een eigenaar en een reden van bestaan. Ontdekt een klant een betekenisvolle fout, maak er dan een opgeschoonde regressietest van voordat je hem oplost.
Een AI-MVP wordt geloofwaardig wanneer hij betrouwbaar is in de afgebakende taak die hij belooft uit te voeren. Een compacte evaluatieset geeft founders een manier om die betrouwbaarheid bewust te verbeteren, voordat een gepolijste demo een dure verrassing in productie wordt.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.