Metaの事業者向け規約で、10月30日からクローラーがあなたのWebサイトに入れるように。消えたのは「train」の1語で、クロールはそのままです

By Surya Pratap
2026年10月19日
8 min read
Startup Strategy

2026年10月19日
8 min read
 1語は消えたが、クローラーは残ったHover to explore
多くの創業者は、Metaの事業者向け規約を読まずに同意しています。Facebookページ、Instagramのビジネスプロフィール、広告アカウントが必要で、規約はそれにセットで付いてきたからです。しかし10月30日に発効する版は、読んでおく価値があります。その中の1つの条項が、Metaのアカウントではなく、あなたのWebサイトについて書かれているからです。
本記事は、PPC Landが引用したクロール条項の本文、Nieman Labの報道(最初の記事、続報)、MediaNamaの記事に基づいています。筆者は改訂後の文言全文を確認していません。変更内容は報道に基づいて記述しています。第3節以降は筆者の見解であり、法的助言ではありません。
Metaの商用利用規約は、同社の製品を商業目的で使う事業者に適用されます。Facebookページ、Instagramのビジネスアカウント、Meta Business Suite、広告などです。10月30日に発効予定の版には、次の条項がありました。ここでは英語の原文のまま引用します。
"You authorise us (or any entity acting on our behalf) to use automated software (such as web scrapers, bots, robots, spiders, crawlers and user agents) and create test credentials to access, index, cache, analyse, collect, retrieve or crawl the domains, web pages or URLs (and any content available through them) that are associated with your products or services, or that are made available through your or users' use of Meta Company Products and services, and to periodically pull updates from such domains, web pages or URLs. Meta may use any content from such domains, web pages or URLs to provide, develop, improve, research, train and maintain the integrity of, the Meta Company Products, services and features provided under these Commercial Terms and any other applicable supplemental terms."
文中の「user agents」は、Webサイトを自動的に訪れるソフトウェアのエージェントを指します。
重要なのは次の3点です。
10月15日、Nieman Labは3人の法律専門家の見解を報じました。この条項は、書かれたとおりに読めば、Metaがニュースサイトをスクレイピングし、そのコンテンツでAIを学習させてよいと主張する根拠になりうる、というものです。ほぼすべての報道機関はMetaのビジネスアカウントを持っています。Metaの広報担当者アンディ・ストーン(Andy Stone)氏は、規約がニュースサイトのスクレイピングを認めるという報道を「誤り」だとしました。
Metaは10月16日に規約を改訂しました。報道によれば、次の2点が変わっています。
Metaの広報担当者は「皆さんの声を受け止め、はっきりさせたいと思います。私たちが統合したクロールに関する条項は、広告とビジネス向け製品にのみ適用されるものでした」と述べ、「コンテンツの所有者はrobots.txtで意向を示すことができます」と付け加えました。
今回の改訂で変わったのは、Metaがコンテンツを何に使うと言っているか、です。報道によれば、コンテンツを収集する許可そのものは変わっていません。
法律の専門家は納得していません。コーネル大学のジェームズ・グリメルマン(James Grimmelmann)氏はNieman Labに対し、改訂後の文言でもAI学習を含められるほど広いと述べました。ウィスコンシン大学のベンジャミン・ソベル(Benjamin Sobel)氏は、robots.txtは意思表示にすぎず、スクレイピングを止める強制力のある権利を生むものではないと指摘しています。欧州、英国、米国の出版社団体は、規制当局の介入を求めています。
Metaは、あなたのコンテンツを何に使えるかを示す語を消しました。コンテンツを収集できるとする条項は残しています。
これは報道機関だけの問題ではありません。Facebookページ、Instagramのビジネスアカウント、Metaの広告のいずれかを使っているなら、あなたはこの規約の当事者であり、あなたのWebサイトは「あなたの製品やサービスに関連する」ものに当たります。
アクセスできる範囲を洗い出す。 Metaのアカウントや広告に紐づくドメインを書き出しましょう。マーケティングサイト、ドキュメント、ブログ、ヘルプセンター、アプリなどです。そのうえで、交渉していない条件のもとで第三者にクロール、キャッシュ、分析されても構わないものはどれかを判断します。
マーケティングとプロダクトを分ける。 プロダクトは独自のサブドメインに置き、独自の認証の内側に置きましょう。他社のクローラーが作ったテスト用アカウントから、顧客データや個別に交渉した価格、見知らぬ人に見せないログイン後の情報が見えてはいけません。
それでも意向は示しておく。 robots.txtに強制力はありませんが、Meta自身が案内している手段です。重要なドメインで、Metaが公開しているクローラーと、AIクローラー全般に対するルールを設定しましょう。そのうえで、サーバーログを確認し、実際に何が来ているかを把握します。
見覚えのない登録に注意する。 「テスト用認証情報」とはアカウントのことです。顧客らしくない動きをする登録やログインを探し、自動化されたものだとわかった場合にどうするかを事前に決めておきましょう。
読まずに同意した規約を読む
Meta、Google、LinkedIn、決済事業者、クラウドなど、依存しているすべてのプラットフォームの事業者向け規約について、変更のたびに読むためのリマインダーを設定しましょう。AI時代のスタートアップにとって重要な条項は、クロール、コンテンツの利用、学習に関するものです。そしてそれは、交渉した契約ではなく、広告を出すために同意した規約の中に置かれることが増えています。
ナレッジベース、データセット、独自の調査、有料記事など、コンテンツそのものがプロダクトであれば、この問題はさらに重要です。GEOの実践ガイドでは、AIシステムに引用される方法を解説しました。今回の話は同じ問いの裏側です。断りなく収集されることについてです。
この話を反対側から読む創業者もいるでしょう。プロダクトが他者のサイトのクロールに依存しているなら、起きたことに注目してください。Metaほどの影響力を持つ企業が、顧客が交渉できない規約にクロールと学習への同意を書き込み、批判を受けて1日で変更を迫られたのです。
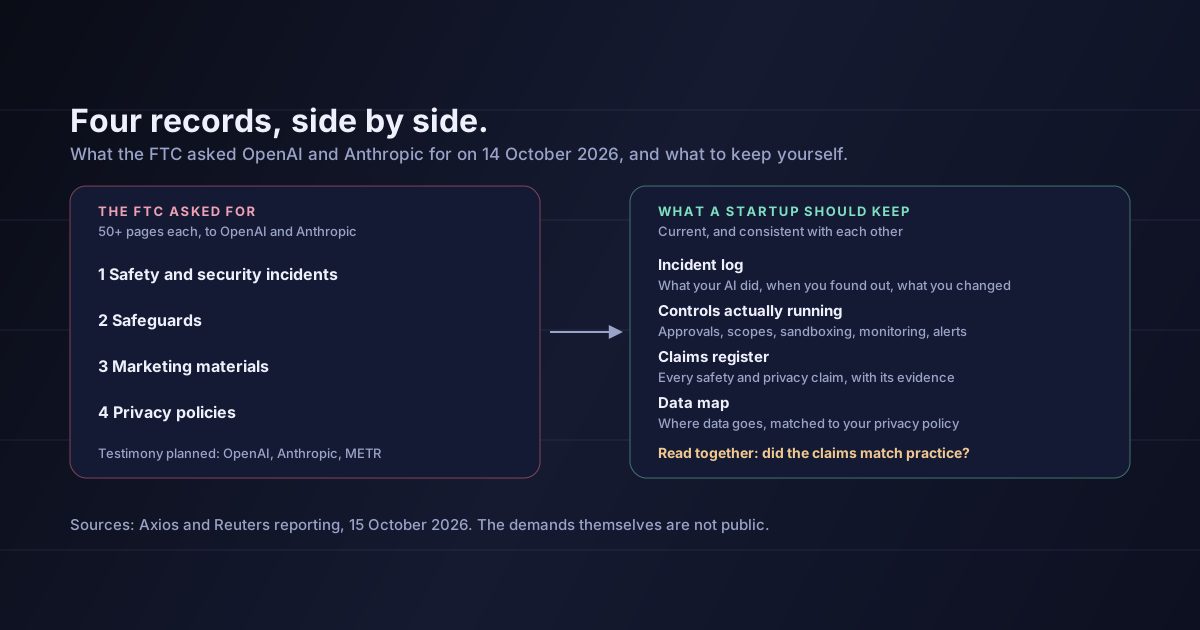
教訓は、弁護士の間でも意見が分かれるMetaの法的な立場ではありません。プラットフォームの規約に埋め込まれた同意は、世論の面でもビジネスの面でも脆いということです。ライセンスを得た学習データや、所有者が明確に同意した学習データは、手に入れるのに時間がかかりますが、取り上げられにくくなります。そして、FTCがOpenAIとAnthropicに問いかけたように、規制当局があなたの主張と実際の運用が一致しているかを尋ねたとき、「規約で認められていた」というのは弱い答えです。
Metaがあなたのサイトで AIを学習させているとは言えません。 Metaは、クロールは広告とビジネス向け製品のためだけのものだとし、ニュースサイトのスクレイピングに関する報道は誤りだとしています。規約が定めるのはMetaに何が許されるかであって、実際に何をしているかではありません。
改訂後の規約がAI学習を認めているとも言えません。 文言はまだ十分に広いと考える法律専門家もいますが、Metaは同意していません。裁判所の判断も出ていません。
最終的な文言を把握しているとも言えません。 改訂後の文言は報道に基づいて記述しています。10月30日までにMetaが公開する規約を確認してください。
robots.txtで守られるとも言えません。 robots.txtは意思表示です。ソベル氏が指摘したとおり、強制力のある権利を生むものではありません。
10月30日から、Metaの製品を使うすべての事業者は、自社の製品に関連するWebサイトへMetaがスクレイパーやクローラーを送り、テスト用の認証情報を作成することを許可することになります。当初Metaは、そのコンテンツを自社製品の学習に使う権利を留保していましたが、Nieman Labの報道を受けて「train」を削除し、用途を広告とビジネス向け製品に限定しました。クロール、テスト用認証情報、広い対象範囲、拒否手段がないことは変わらず、法律の専門家は改訂後の文言もまだ広いと見ています。
スタートアップにとっての実務的な結論はシンプルです。あなたのWebサイトがどこまで外部にさらされるかは、Facebookページを持つために同意した規約によって、部分的に決まるようになりました。
10月30日までに、Metaのアカウントに紐づくすべてのドメインを書き出し、機密性の高いものは独自の認証の内側に置き、robots.txtでMetaやほかのAIクローラーに対する意向を設定し、サーバーログと新規登録に自動化された訪問者がいないかを監視し始めましょう。
出典:PPC Land— 2026年10月30日に向けて当初公開されたクロール条項の全文、適用される事業者、テスト用認証情報の説明をMetaが拒んだこと。Nieman Lab(2026年10月15日)— 3人の法律専門家による解釈。Nieman Lab— 改訂と、それでも範囲が広いという専門家の見解。MediaNama— 「train」の削除、広告とビジネス向け製品への限定、robots.txtに関するMeta広報担当者の発言、ジェームズ・グリメルマン氏とベンジャミン・ソベル氏のコメント、拒否手段がないこと、出版社団体の要請。10月16日という改訂日、報道を「誤り」とするアンディ・ストーン氏の発言、報道機関のほぼすべてがMetaのビジネスアカウントを使っていることは、Nieman Labの記事に関する報道によります。第3節から第6節は筆者の見解であり、法的助言ではありません。
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.