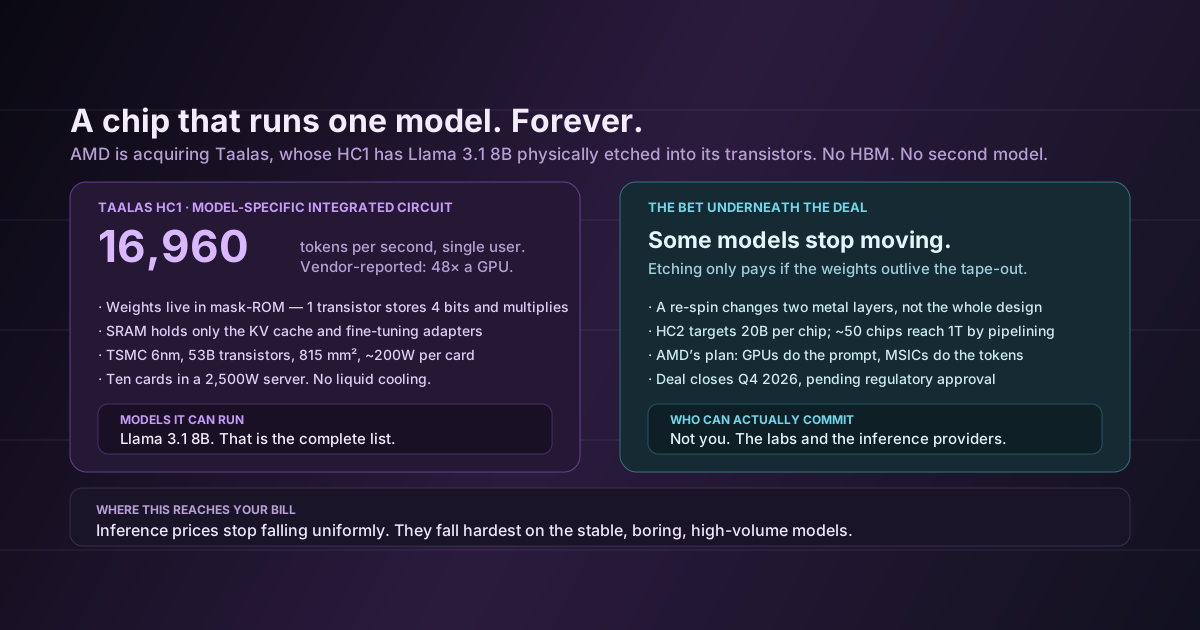
GoogleがTPUをPyTorchのネイティブデバイスに。多くの創業者にとっては移行ではなく、価格交渉の材料です

By Surya Pratap
2026年10月22日
8 min read
AI & Technology

2026年10月22日
8 min read
 移行は1行、速くするにはもっと手間がかかるHover to explore
ほとんどのAIスタートアップは、自社のモデルがどのチップで動いているかを考えたことがありません。APIを呼び出せば、あとはプロバイダーが決めてくれます。しかし、コスト、プライバシー、管理のしやすさから、オープンウェイトのモデルを自社でホストするスタートアップが増えています。そうした企業にとって、チップといえばNvidiaでした。PyTorchのコードがすんなり動くのがそこだったからです。今週のGoogleの発表は、その「当たり前」を変えようとするものです。
本記事は、Google Cloudの発表「TorchTPU is now open source: Run native PyTorch on TPUs」と、Forkast、MarkTechPostの記事に基づいています。性能と互換性の数字はGoogleとそのパートナーによるもので、第三者による検証は行われていません。第3節以降は筆者の見解です。
Googleは2026年10月20日、PyTorch Conferenceで、Tensor Processing Unit向けのネイティブなPyTorchスタックTorchTPUをオープンソース化しました。MetaのPyTorchチームと共同で開発したもので、ForkastによればApache 2.0ライセンスで公開されています。
中心となる考え方は、TPUがGPUやCPUと並ぶ、ごく普通のPyTorchのデバイスになるということです。"cuda"を指定していたコードは、代わりに"tpu"を指定できます。Googleはワークフローを「eagerモードでモデルをデバッグし、その後torch.compileで本番レベルの性能に移行する」と説明しています。独自のカーネルは、CUDAではなく、Googleのカーネル言語であるPallasで書きます。
スタートアップが実際に使うエコシステムの多くは、すでに対応しています。
device_map="tpu"を渡すだけ」です。Diffusersにも対応しています。Googleとパートナーが公表した数字は次のとおりです。
Metaのヤナ・ファン・フルーネン(Jana van Greunen)氏はこれを「大きな前進」と呼び、Hugging Faceのジェフ・ブーディエ(Jeff Boudier)氏は「オープンソースのAIを誰もが使えるようにするには、ハードウェアの多様性が欠かせない」と述べています。
いずれもベンダーやパートナーによる数字で、独立した検証は行われていません。
デバイスの変更は1行です。しかし、速度はそうはいきません。Forkastの分析ははっきりしています。「デバイスを入れ替えるだけでは、TPUの最高性能は得られない」。具体的には次のとおりです。
デバイスの変更はコード1行です。別のチップで最高性能を出すのは、今もエンジニアリングの仕事です。価値は、移れるという選択肢そのものにあります。
モデルのAPIを呼び出すだけなら、直接変わることはありません。チップはプロバイダーが選びます。せいぜい、計算資源の競争が進むことで、時間とともにAPIの価格が下がる程度です。
オープンウェイトのモデルを自社でホストしているなら、これは重要です。大量に処理するときのコスト、データの管理、独自にファインチューニングしたモデルなど、理由はさまざまでしょう。これまでは、クラウドやGPU事業者のNvidia製GPUを、相手の言い値で使うのが現実的な選択でした。同じPyTorchとvLLMのコードが動く、信頼できる2つ目のアクセラレーターがあれば、実際に移らなくても、その交渉の構図が変わります。
学習やファインチューニングをしているなら、TorchTitanとHugging Faceの対応によって、TPUを試すコストが下がります。ただし、TPU固有のチューニングが最も効くのは大規模な学習です。
コードをデバイスに依存させない。 コード内でハードコードされた"cuda"を探し、設定で変えられるデバイス指定に置き換えましょう。本当に必要だと測定で確かめた場合を除き、手書きのCUDAより、標準的なPyTorchの演算とサポートの厚いライブラリを優先します。
移植しやすいレイヤーでモデルを提供する。 自社でホストしているなら、推論はvLLMかSGLangで動かし、モデルはHugging Face経由で読み込みましょう。どちらもTorchTPUが対応しているレイヤーなので、同じデプロイ構成をどちらのアクセラレーターにも向けられます。
自社のワークロードでベンチマークする。 自社のモデル、プロンプトの長さ、バッチサイズで両方を試し、必要なレイテンシーでの100万トークンあたりのコストを比べましょう。ベンダーのベンチマークは自分たちに有利なケースを使っています。意味があるのは、あなた自身の数字だけです。
交渉に使う。 TPUでの小規模でも実際のベンチマークがあれば、利用量コミットによる割引や、GPU容量の予約について話すときに、信頼できる代替案を示せます。この選択肢は、実際に使う前から価値があります。
移植性は、どこでも同じ習慣
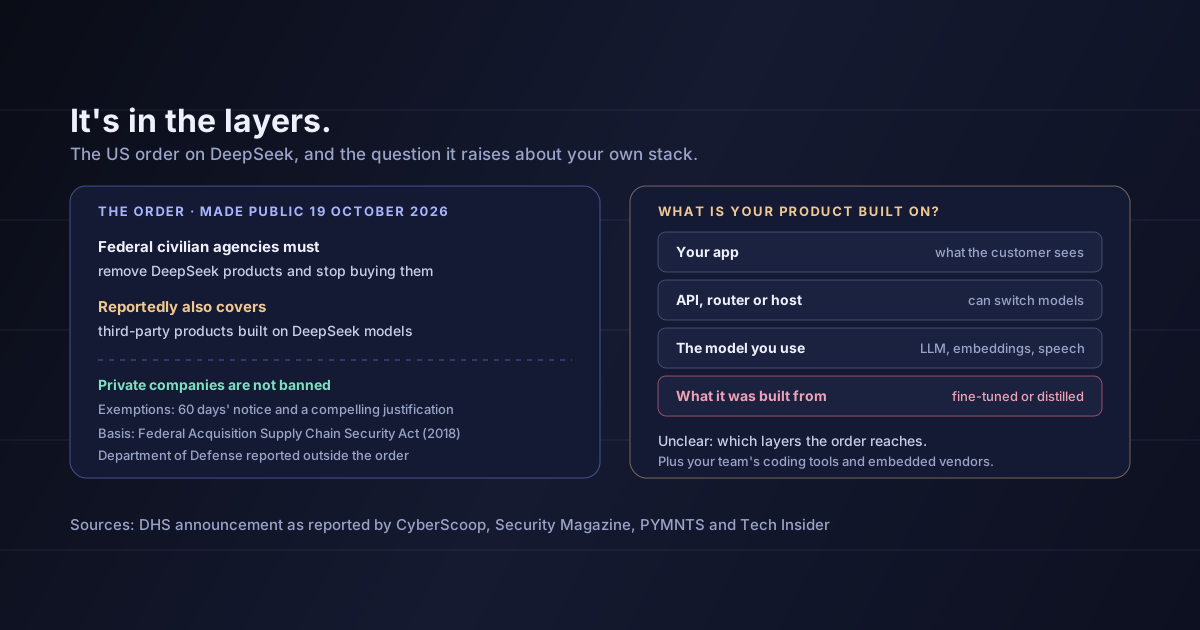
モデルのコードを1つのチップベンダーに縛らないことは、DeepSeekに関する米国の命令の記事で伝えた助言のハードウェア版です。スタックが何に依存しているかを把握し、部品の交換を作り直しではなく設定変更で済むようにしておくことです。
TPUのほうがあなたにとってGPUより速い、あるいは安いとは言えません。 それはモデル、トラフィック、価格によって変わります。公表された数字は、GoogleとパートナーがGoogle側で選んだワークロードでのものです。
PyTorchのコードが変更なしで最高速度で動くとも言えません。 Googleによれば、わずかな変更で動きます。しかし、高い利用率を得るには、今もTPU固有の作業が必要です。
TPUが簡単に手に入るとも言えません。 TPUはGoogle Cloudを通じて提供されています。小規模な企業向けの提供状況、割り当て、価格は、今回の発表には含まれていません。
Nvidiaの立場が変わったとも言えません。 オープンソースのバックエンド1つで、市場が動くわけではありません。自社でホストするチームにとっての乗り換えコストが1つ下がる、ということです。
GoogleとMetaはTorchTPUをオープンソース化し、GoogleのTPUをApache 2.0ライセンスのもとでPyTorchのネイティブデバイスにしました。その上ではvLLM、SGLang、Hugging Face、TorchTitan、Rayが動きます。Googleは高い利用率と互換性を報告していますが、数字はGoogle自身のもので、最高性能を出すには今もTPU固有のエンジニアリングが必要です。独自のCUDAカーネルはそのまま移せません。
APIを呼び出すだけのスタートアップにとって、変わることはわずかです。モデルを自社でホストするスタートアップにとっては、同じコードで使える現実的な2つ目のアクセラレーターが生まれます。実際に乗り換えなくても、それは役に立ちます。
自社でホストしているなら、今回のスプリントでコードからハードコードされた「cuda」を取り除き、vLLMかSGLangでモデルを提供し、自社のワークロードでTPUのベンチマークを1回取ってください。そして、その結果を次のGPUの価格交渉に持っていきましょう。
出典:Google Cloud「TorchTPU is now open source: Run native PyTorch on TPUs」(2026年10月)— Metaとの共同開発、eagerモードとtorch.compile、Pallasカーネル、vLLM、SGLang、llm-d、Hugging Face、TorchTitan、Ray、TorchRec、VeRLとの連携、device_map="tpu"に関する説明、最大8,192基のTPU v7xでのMFU 52%という数字、Zenteiqのスループットの数字、ヤナ・ファン・フルーネン氏とジェフ・ブーディエ氏の発言。Forkast— 10月20日という日付、Apache 2.0ライセンス、「cuda」から「tpu」への変更、Hugging Faceの5,000モデルでのクラッシュなし98%と数値の一致率97%、そして制約(最高性能にはTPU固有の作業が必要、CUDAカーネルは移植できない、ユーザー空間プロセスは1つ、命令セットは独自仕様)。MarkTechPost— 公開に関する報道。第3節から第6節は筆者の見解です。
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.