Gemini 4 Argon está a mitad de precio hasta el 30 de noviembre. Pruébalo ya, pero fija tus precios con la tarifa de diciembre

By Surya Pratap
23 de octubre de 2026
8 min read
AI & Technology

23 de octubre de 2026
8 min read
 El precio se duplica el 1 de diciembreHover to explore
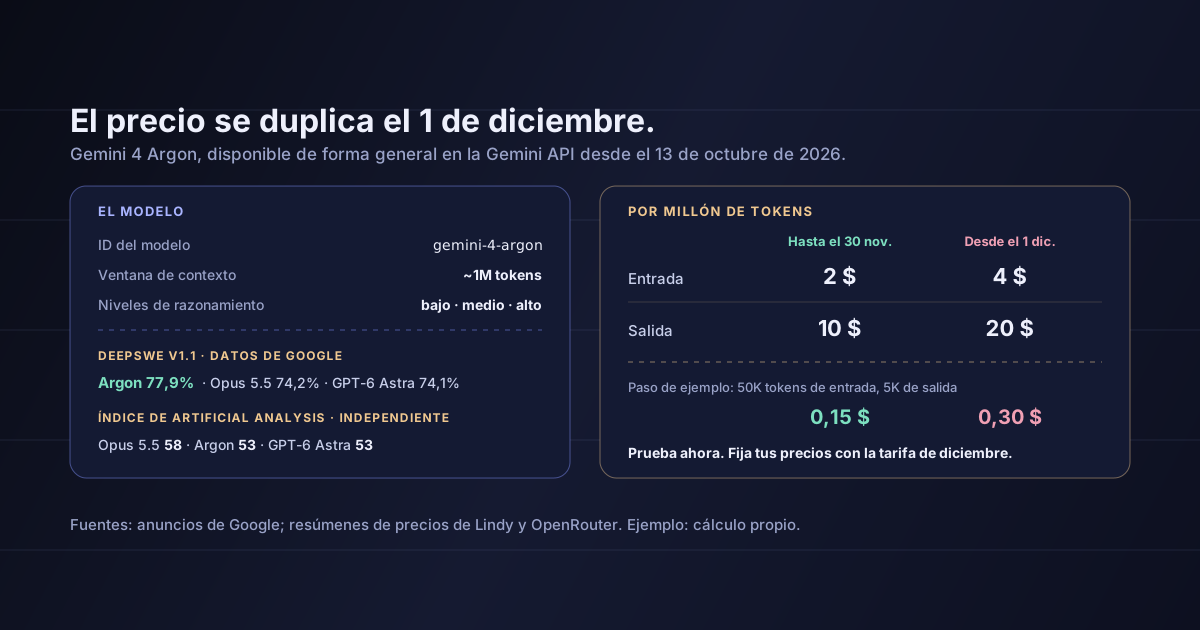
Los nuevos modelos de frontera llegan con dos cifras en las que se fijan los fundadores: una puntuación en benchmarks y un precio. Gemini 4 Argon trae una tercera que importa más: una fecha. Su precio de lanzamiento dura hasta el 30 de noviembre, y el 1 de diciembre todas las tarifas por token se duplican. Eso cambia cómo conviene abordarlo.
Este artículo se basa en los anuncios de Google «Gemini 4 Argon: our next era of frontier intelligence» y «Gemini 4 Argon is now available for developers», en las notas de versión de la Gemini API según Releasebot y en los resúmenes de precios y especificaciones de Lindy y OpenRouter. La mayoría de las cifras de benchmarks son de la propia Google. La lectura a partir de la sección 4 es mía.
Google anunció Gemini 4 Argon el 30 de septiembre de 2026 y lo describió como «nuestro modelo de frontera para programación real, trabajo del conocimiento en empresas y ciberdefensa». Pasó a estar disponible de forma general el 13 de octubre en la Gemini API, Google AI Studio, Android Studio y, para los suscriptores Ultra, en el entorno de programación Antigravity de Google, con el ID de modelo gemini-4-argon.
Las especificaciones, resumidas a partir de la documentación de Google:
En la app de Gemini está disponible para los suscriptores de pago de Google AI Pro y Ultra; las cuentas gratuitas quedan fuera. También llegó primero a los profesionales de ciberdefensa a través del programa Fairwind de Google.
Las cifras de la propia Google:
| Benchmark | Qué mide | Gemini 4 Argon |
|---|---|---|
| DeepSWE v1.1 | Ingeniería de software | 77,9% |
| Vals Index | Trabajo del conocimiento | 68,9% |
| AutomationBench | Tareas de automatización | 51,3% |
| LVBench | Comprensión de vídeos largos | 91,7% |
| GraphWalks 256K–1M | Razonamiento con contexto largo | 84,2% |
En DeepSWE, la cobertura de la comparación de Google sitúa a Claude Opus 5.5 en un 74,2% y a GPT-6 Astra en un 74,1%.
Las pruebas independientes dan una imagen menos favorable. En el índice de Artificial Analysis, según Lindy, Argon obtiene 53, empatado con GPT-6 Astra, mientras que Claude Opus 5.5 encabeza la tabla con 58.
Google describe también resultados internos: agentes de Argon que ayudaron a migrar de C y C++ a Rust más de 800.000 líneas del kernel Fuchsia Zircon, y que detectaron optimizaciones de memoria que liberaron más de 300 TiB en los centros de datos de Google. Son relatos de Google sobre su propio trabajo.
| Hasta el 30 de noviembre de 2026 | Desde el 1 de diciembre de 2026 | |
|---|---|---|
| Entrada | 2 $ por millón de tokens | 4 $ por millón de tokens |
| Salida | 10 $ por millón de tokens | 20 $ por millón de tokens |
| Entrada en caché | 0,10 $ por millón de tokens | — |
Toma un paso típico de un agente con 50.000 tokens de entrada y 5.000 de salida. Con el precio de lanzamiento cuesta unos 0,15 dólares. Desde diciembre, unos 0,30. Una función que ejecuta ese paso 20 veces por usuario y día pasa de unos 3 dólares a unos 6 por usuario y día.
El precio de lanzamiento es un buen momento para probar un modelo y una mala base para un plan de negocio.
Evalúa ahora, con tus tareas. Ejecuta tu propio conjunto de evaluación con Argon y con tu modelo actual mientras los tokens son baratos. Compara calidad, latencia y coste por tarea resuelta, no tablas de benchmarks. Prueba los tres niveles de razonamiento: puede que el «alto» no compense sus tokens en tu caso.
Calcula con la tarifa de diciembre. Si adoptas Argon, modela tus márgenes a 4 y 20 dólares. Un plan que solo funciona a 2 y 10 deja de funcionar en seis semanas, y cualquier precio que fijes a tus clientes en noviembre durará más que el descuento.
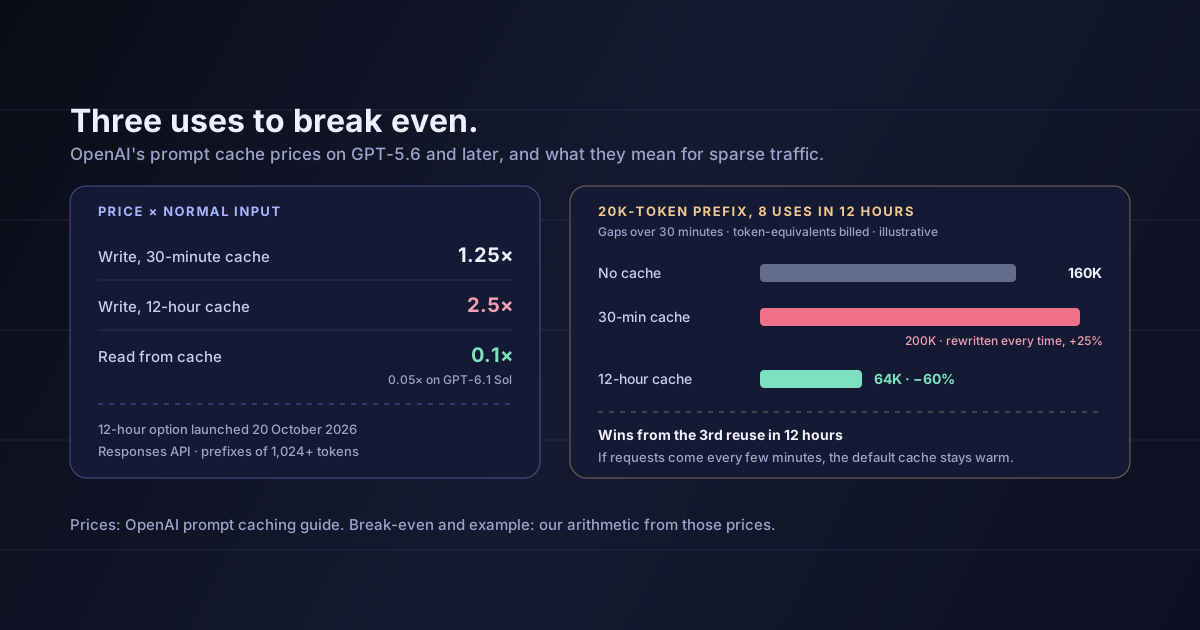
Usa la caché para el contexto largo. La entrada en caché figura a 0,10 dólares por millón de tokens. Si envías una y otra vez los mismos documentos largos o el mismo código, estructura los prompts para que la parte estable vaya primero. Ya hicimos las cuentas de equilibrio de la caché de OpenAI; los mismos hábitos sirven aquí.
Vigila la longitud de la salida. Un límite de salida más alto es útil para migraciones, informes largos y grandes refactorizaciones, pero la salida cuesta cinco veces más que la entrada. Fija límites de salida explícitos por función para que una respuesta larga no te dé un susto en la factura.
Que cambiar de modelo siga siendo barato
Decidas lo que decidas, mantén la elección del modelo en la configuración, no en el código. Los precios, las clasificaciones y los descuentos de lanzamiento cambian cada pocas semanas. Las startups que salen ganando son las que pueden probar un modelo nuevo en un día y pasar una función a él —o sacarla de él— con una evaluación y un cambio de configuración.
Para tareas cortas y de mucho volumen, un modelo más pequeño y barato suele ganar en coste. La propia familia de Argon incluye modelos Flash para eso.
Que Argon sea el mejor modelo para ti. Los benchmarks de Google lo favorecen; un índice independiente lo sitúa en mitad del grupo de frontera. Tus tareas deciden.
Que los precios y los límites sean definitivos. Las cifras de este artículo proceden de los anuncios de Google y de resúmenes de terceros de sus páginas de precios. Comprueba los precios vigentes de la Gemini API antes de comprometerte.
Que los resultados internos de Google sean trasladables. Migrar Fuchsia a Rust con los ingenieros y la infraestructura de Google demuestra que el modelo puede hacer trabajo largo y estructurado. No dice cómo lo hará con tu código.
Que la salida por defecto sea de un millón de tokens. No lo es: el valor por defecto es 65.536. Las salidas más largas hay que configurarlas de forma explícita, y cada token adicional se factura a la tarifa de salida.
Gemini 4 Argon es el nuevo modelo de frontera de Google para programación, agentes y trabajo del conocimiento, disponible de forma general en la Gemini API desde el 13 de octubre de 2026, con una ventana de contexto de cerca de un millón de tokens, respuestas mucho más largas y tres niveles de razonamiento. Los benchmarks de Google lo sitúan en lo más alto o cerca en programación y contexto largo; el índice independiente de Artificial Analysis lo coloca al nivel de GPT-6 Astra y por detrás de Claude Opus 5.5. Cuesta 2 y 10 dólares por millón de tokens de entrada y de salida hasta el 30 de noviembre, y 4 y 20 desde el 1 de diciembre.
Lo útil no es cambiarse ni ignorarlo. Es aprovechar seis semanas de tokens a mitad de precio para averiguar, con tus propias tareas, si se gana su precio de diciembre.
Antes del 30 de noviembre, ejecuta tu conjunto de evaluación con Gemini 4 Argon en cada nivel de razonamiento, compara el coste por tarea resuelta con tu modelo actual a precios de diciembre y solo entonces decide qué funciones —si alguna— deberían cambiar.
Fuentes: Google, «Gemini 4 Argon: our next era of frontier intelligence»: la descripción de Argon, la subida del límite de salida desde 64K, las cifras de DeepSWE, AutomationBench y LVBench, lo relativo a Fuchsia, la memoria y Fairwind, y los precios introductorio y estándar. Google, «Gemini 4 Argon is now available for developers»: la disponibilidad desde el 13 de octubre en la Gemini API, Google AI Studio, Android Studio y Antigravity. Releasebot: la disponibilidad general del 13 de octubre y el ID del modelo. Lindy: la fecha de anuncio del 30 de septiembre, la disponibilidad para suscriptores, la ventana de contexto, el límite de salida por defecto, los niveles de razonamiento, la fecha de corte de conocimiento, las cifras de Vals Index, GraphWalks y otros benchmarks, el precio de la entrada en caché y las puntuaciones del índice de Artificial Analysis. OpenRouter: el calendario de precios, las modalidades y la longitud de contexto. La comparación en DeepSWE con Claude Opus 5.5 y GPT-6 Astra es la que recoge la cobertura del anuncio de Google. El ejemplo de coste y la lectura de las secciones 4 a 6 son míos.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.