Google ha convertido sus TPU en un dispositivo nativo de PyTorch. Para la mayoría de los fundadores es una baza para negociar precios, no una migración

By Surya Pratap
22 de octubre de 2026
8 min read
AI & Technology

22 de octubre de 2026
8 min read
 Una línea para moverse, más para ir rápidoHover to explore
La mayoría de las startups de IA nunca se preguntan en qué chip se ejecuta su modelo. Llaman a una API y el proveedor decide. Pero cada vez más alojan modelos de pesos abiertos por coste, privacidad o control, y para ellas el chip ha sido Nvidia, porque es donde el código de PyTorch funciona sin fricción. El lanzamiento de Google de esta semana intenta cambiar esa opción por defecto.
Este artículo se basa en el anuncio de Google Cloud «TorchTPU is now open source: Run native PyTorch on TPUs» y en la cobertura de Forkast y MarkTechPost. Las cifras de rendimiento y compatibilidad son de Google y sus socios, sin verificación independiente. La lectura a partir de la sección 3 es mía.
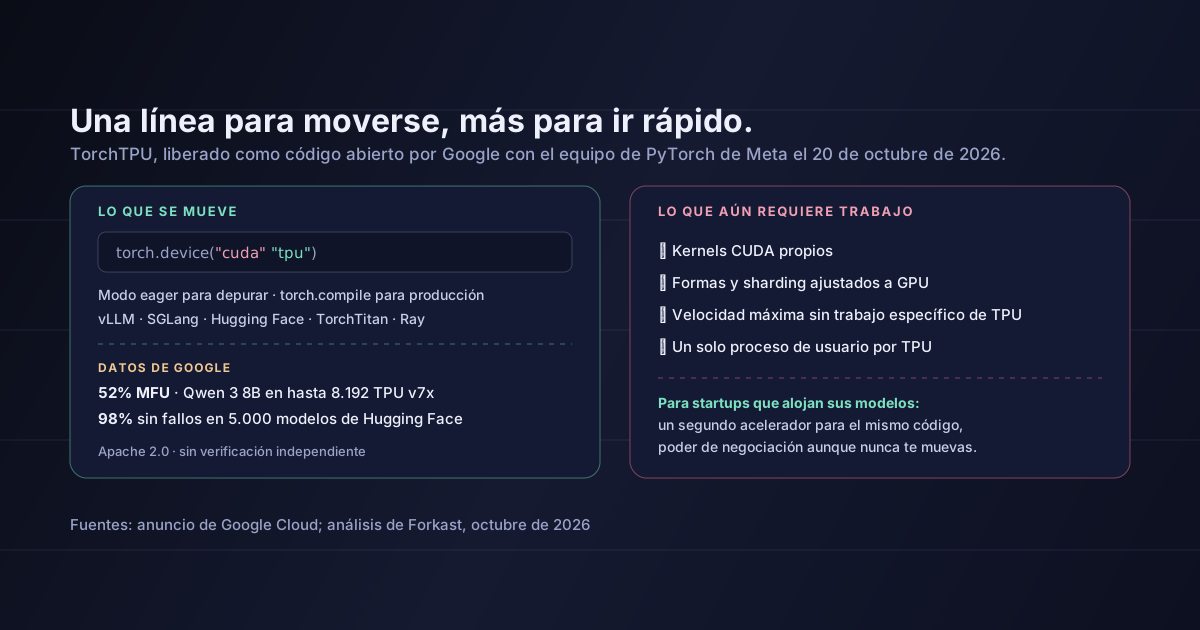
El 20 de octubre de 2026, en la PyTorch Conference, Google liberó como código abierto TorchTPU, su stack nativo de PyTorch para las Tensor Processing Units. Se desarrolló junto al equipo de PyTorch de Meta y, según Forkast, se publica bajo licencia Apache 2.0.
La idea central es que una TPU pasa a ser un dispositivo de PyTorch más, junto a las GPU y las CPU. El código que apunta a "cuda" puede apuntar a "tpu". Google describe así el flujo de trabajo: «depura tus modelos en modo eager y después pasa a un rendimiento de producción con torch.compile». Los kernels propios se escriben en Pallas, el lenguaje de kernels de Google, en lugar de CUDA.
Buena parte del ecosistema que usaría una startup ya está integrada:
device_map="tpu"», además de Diffusers.Google y sus socios informaron de:
Jana van Greunen, de Meta, lo calificó de «un enorme paso adelante». Jeff Boudier, de Hugging Face, dijo que «la diversidad de hardware es esencial para que la IA de código abierto sea accesible para todos».
Todas estas cifras son del fabricante o de sus socios. Ninguna se ha comprobado de forma independiente.
Cambiar el dispositivo es una línea. La velocidad no. El análisis de Forkast es directo: «no se puede alcanzar el máximo rendimiento de una TPU con un simple cambio de dispositivo». En concreto:
Cambiar el dispositivo es una línea de código. Sacar el máximo rendimiento a otro chip sigue siendo ingeniería. El valor está en poder moverse.
Si solo llamas a API de modelos, no cambia nada para ti de forma directa. Tu proveedor elige sus chips. Como mucho, más competencia en cómputo empuja los precios de las API a la baja con el tiempo.
Si alojas modelos de pesos abiertos —por coste a gran volumen, control de los datos o un modelo ajustado propio—, esto sí importa. Hasta ahora, la opción realista eran las GPU de Nvidia, de una nube o de un proveedor de GPU, a su precio. Un segundo acelerador creíble que ejecuta el mismo código de PyTorch y vLLM cambia esa conversación, aunque nunca te muevas.
Si entrenas o ajustas modelos, el soporte de TorchTitan y Hugging Face hace más barato probar en TPU, aunque es en los entrenamientos grandes donde más rinde el ajuste específico para TPU.
Mantén tu código independiente del dispositivo. Busca en tu código los "cuda" escritos a mano y sustitúyelos por un dispositivo configurable. Usa operaciones estándar de PyTorch y librerías bien soportadas en lugar de CUDA escrito a mano, salvo que hayas medido que lo necesitas.
Sirve los modelos con capas portables. Si alojas modelos, ejecuta la inferencia con vLLM o SGLang y carga los modelos con Hugging Face. Son las capas que soporta TorchTPU, así que el mismo despliegue puede apuntar a cualquiera de los dos aceleradores.
Mide tu propia carga de trabajo. Ejecuta tu modelo, con tus longitudes de prompt y tus tamaños de lote, en ambos, y compara el coste por millón de tokens con la latencia que necesitas. Los benchmarks de los fabricantes usan sus mejores casos; el tuyo es el único número que importa.
Úsalo para negociar. Incluso un benchmark pequeño y real en TPU te da una alternativa creíble cuando hablas de descuentos por uso comprometido o de capacidad de GPU reservada. La opción vale algo antes de ejercerla.
La portabilidad es el mismo hábito en todas partes
Mantener el código de tus modelos libre de un único fabricante de chips es la versión hardware del consejo que dimos tras la orden de EE. UU. sobre DeepSeek: saber de qué depende tu stack y conseguir que cambiar una pieza sea un cambio de configuración, no una reconstrucción.
Que las TPU sean ahora más rápidas o más baratas que las GPU para ti. Depende de tu modelo, tu tráfico y tus precios. Las cifras publicadas son de Google y sus socios, con cargas de trabajo elegidas por ellos.
Que el código de PyTorch funcione sin cambios a máxima velocidad. Funciona, según Google, con cambios mínimos. Lograr una buena utilización sigue exigiendo trabajo específico para TPU.
Que las TPU sean fáciles de conseguir. Las TPU están disponibles a través de Google Cloud. La disponibilidad, las cuotas y los precios para empresas pequeñas no formaban parte de este anuncio.
Que la posición de Nvidia haya cambiado. Un backend de código abierto no mueve el mercado por sí solo. Reduce un coste de cambio para los equipos que alojan sus modelos.
Google y Meta han liberado TorchTPU, que convierte las TPU de Google en un dispositivo nativo de PyTorch con licencia Apache 2.0, con vLLM, SGLang, Hugging Face, TorchTitan y Ray funcionando encima. Google informa de buena utilización y compatibilidad, pero las cifras son suyas, y el máximo rendimiento sigue exigiendo ingeniería específica para TPU; los kernels CUDA propios no se trasladan.
Para las startups que solo llaman a API, cambia poco. Para las que alojan modelos, crea un segundo acelerador realista para el mismo código, lo que es útil aunque nunca cambies.
Si alojas modelos, elimina este sprint los «cuda» escritos a mano en tu código, sirve los modelos con vLLM o SGLang y haz un benchmark de tu propia carga de trabajo en TPU. Después, lleva el resultado a tu próxima conversación sobre el precio de las GPU.
Fuentes: Google Cloud, «TorchTPU is now open source: Run native PyTorch on TPUs», octubre de 2026: el desarrollo conjunto con Meta, el modo eager y torch.compile, los kernels en Pallas, las integraciones con vLLM, SGLang, llm-d, Hugging Face, TorchTitan, Ray, TorchRec y VeRL, la cita sobre device_map="tpu", la cifra de 52% de MFU en hasta 8.192 chips TPU v7x, las cifras de rendimiento de Zenteiq y las citas de Jana van Greunen y Jeff Boudier. Forkast: la fecha del 20 de octubre, la licencia Apache 2.0, el cambio de dispositivo de «cuda» a «tpu», el 98% de ejecuciones sin fallos en 5.000 modelos de Hugging Face y el 97% de paridad numérica, y las limitaciones: el máximo rendimiento exige trabajo específico de TPU, los kernels CUDA no son portables, el único proceso de espacio de usuario y el conjunto de instrucciones propietario. MarkTechPost: cobertura del lanzamiento. La lectura de las secciones 3 a 6 es mía.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.