
Escribir en la caché de 12 horas de OpenAI cuesta 2,5×. Sobre el papel, se amortiza a partir de la tercera petición

By Surya Pratap
21 de octubre de 2026
8 min read
AI & Technology

21 de octubre de 2026
8 min read
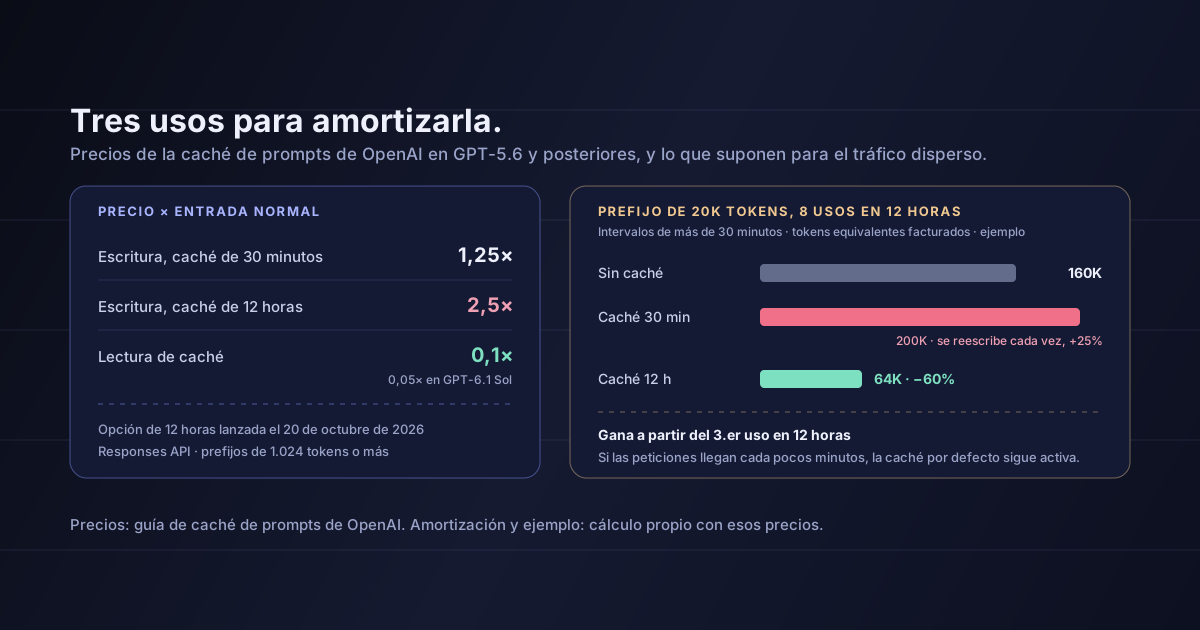 Tres usos para amortizarlaHover to explore
El prompt caching es una de las pocas palancas que reducen la factura de un producto de IA sin tocar la calidad. La nueva opción de OpenAI hace que la caché dure mucho más, a cambio de un precio más alto por escribir en ella. Que te ahorre dinero depende de algo que la mayoría de los equipos nunca ha medido: cuánto tiempo pasa entre las peticiones que comparten el mismo prompt.
Este artículo se basa en la guía de prompt caching y el registro de cambios de OpenAI, y en la cobertura de Runtime Wire. Los precios son los multiplicadores publicados por OpenAI para GPT-5.6 y posteriores. Las cifras de equilibrio de las secciones 3 y 4 son cálculos míos a partir de esos multiplicadores, con las suposiciones simplificadas que allí se indican, y no son de OpenAI.
El 20 de octubre de 2026, OpenAI permitió a los desarrolladores activar una caché de prompts de 12 horas en la Responses API, junto a la de 30 minutos que ya venía por defecto. OpenAI la presentó pensando en agentes persistentes: «Los agentes persistentes, como dots, reutilizan el contexto a lo largo del día», dijo su cuenta para desarrolladores.
En GPT-5.6 y posteriores se configura con prompt_cache_options.ttl en "12h" en lugar del valor por defecto "30m". Ambos son tiempos de vida mínimos.
Para GPT-5.6 y posteriores, como múltiplos del precio normal (sin caché) de los tokens de entrada:
| Precio | |
|---|---|
| Escritura, caché de 30 minutos | 1,25× |
| Escritura, caché de 12 horas | 2,5× |
| Lectura de caché | 0,1× (0,05× en GPT-6.1 Sol) |
Hay otras tres reglas importantes:
prompt_cache_key opcional mantiene cachés separadas por cliente o usuario.En los modelos anteriores no hay cargo adicional por escribir en la caché, y las opciones de retención son distintas.
Toma un prefijo —prompt de sistema, definiciones de herramientas, material de referencia— de tamaño P, reutilizado N veces en 12 horas. Deja fuera los tokens de salida y la parte de cada prompt que cambia; cuestan lo mismo en todos los casos.
Despejando cuándo la caché de 12 horas sale más barata que no usar caché, se obtiene N > 2,7. Frente a una caché de 30 minutos que caduca una y otra vez, N > 2,1. Dicho de otro modo: con estas suposiciones simplificadas, a partir del tercer uso del mismo prefijo en 12 horas, gana la caché de 12 horas, siempre que los intervalos sean lo bastante largos como para que la caché por defecto haya caducado.
Cuando las peticiones llegan cada pocos minutos, la caché por defecto nunca se enfría, y la opción de 12 horas simplemente cuesta 1,25 × P más por ventana sin aportar nada.
Una caché más larga solo ahorra dinero cuando los intervalos entre tus peticiones son más largos de lo que dura la caché por defecto.
Un agente de soporte de ejemplo tiene un prefijo de 20.000 tokens: instrucciones, esquemas de herramientas y un manual del producto. Un cliente lo usa 8 veces a lo largo de una jornada, más o menos una vez cada hora o dos. Entrada facturada por el prefijo, en tokens equivalentes:
Es un recorte del 60% frente a no usar caché en el prefijo, y muestra algo menos evidente: con un tráfico disperso como este, la caché por defecto puede costar un 25% más que no usar caché, porque pagas el sobreprecio de escritura sin llegar nunca a leer.
Si cada cliente tiene su propio material de referencia en el prefijo, cada uno necesita su propia escritura. El ahorro sigue aplicándose por cliente, pero solo para los clientes que vuelven tres o más veces dentro de la ventana.
Probablemente le compensa. Asistentes y agentes que cada cliente usa unas pocas veces al día, con instrucciones o documentos largos y estables: copilotos internos, asistentes de cuenta, agentes programados que se activan cada hora o dos, herramientas B2B que se usan a ratos durante la jornada.
Probablemente no le compensa. Funciones con mucho tráfico en las que el mismo prefijo se usa cada pocos minutos: la caché por defecto ya se mantiene activa. Tampoco las peticiones puntuales, los prompts de menos de 1.024 tokens ni los prompts cuyo inicio cambia en cada llamada.
Arregla primero el prefijo. Pon al principio todo lo estable —instrucciones, definiciones de herramientas, material de referencia— y al final todo lo que cambia. Una marca de tiempo en la primera línea del prompt de sistema anula en silencio cualquier duración de caché.
Mide antes de cambiar. Registra, por prefijo, cuántas veces se reutiliza y el tiempo entre usos, y revisa los recuentos de tokens en caché que devuelve la API. Activa las 12 horas para los prefijos que encajan de verdad con ese patrón, no para todo.
Comprueba cuánto te cuesta la caché por defecto
Si te has pasado a GPT-5.6 o posterior y tu tráfico por prefijo es disperso, revisa ahora tu factura. La escritura a 1,25× de la caché por defecto es fácil de pasar por alto, y con peticiones separadas por más de 30 minutos es puro sobrecoste. Es un gasto que quizá ya estés pagando, antes de decidir nada sobre las 12 horas.
El contexto largo y repetido es el mayor coste oculto de los productos con agentes, como vimos cuando una sola refactorización costó 14,29 dólares en tokens. La caché es la solución más barata, pero solo cuando encaja con cómo se comportan de verdad tus usuarios.
Que la caché de 12 horas dure siempre 12 horas o que las lecturas en caché estén garantizadas. OpenAI describe ambos tiempos de vida como mínimos, y una caché puede fallar igualmente. El ahorro real será algo menor que el de las cuentas.
Que las cifras de equilibrio sean de OpenAI. Son cálculos míos a partir de los multiplicadores publicados, suponiendo prefijos idénticos y sin contar coincidencias parciales.
Que estos precios se apliquen a todos los modelos. Son para GPT-5.6 y posteriores; los modelos anteriores no tienen recargo por escritura y tienen otras opciones de retención, y GPT-6.1 Sol lee a 0,05×.
Que la caché sea adecuada para datos sensibles sin comprobarlo. OpenAI indica que los datos en caché pueden guardarse en almacenamiento local de la GPU. Si tienes compromisos de retención de datos, comprueba cómo encaja la caché con ellos antes de alargarla.
OpenAI ofrece ahora una caché de prompts de 12 horas en la Responses API. En GPT-5.6 y posteriores, escribir en ella cuesta 2,5× el precio de entrada, frente a 1,25× la de 30 minutos por defecto, y leer de ella cuesta 0,1×. Con cuentas simplificadas, la caché de 12 horas supera tanto a no usar caché como a una caché de 30 minutos que caduca a partir de la tercera reutilización del mismo prefijo en 12 horas, pero solo si las peticiones están separadas por más de 30 minutos. Con tráfico frecuente añade coste, y con tráfico disperso la caché por defecto puede estar costando ya más que no usar caché.
La decisión no depende de la función. Depende de tu patrón de tráfico.
Esta semana, registra con qué frecuencia se reutiliza cada prefijo largo y el tiempo entre usos. Mueve el contenido estable al principio de tus prompts. Y después activa las 12 horas solo para los prefijos que vuelven tres o más veces al día con intervalos largos.
Fuentes: OpenAI, guía de prompt caching: la caché de 30 minutos por defecto y la opción de 12 horas, el parámetro prompt_cache_options.ttl en GPT-5.6 y posteriores, los precios de escritura de 1,25× y 2,5× y de lectura de 0,1× (0,05× en GPT-6.1 Sol), el mínimo de 1.024 tokens, la coincidencia por prefijos, prompt_cache_key, la ausencia de recargo por escritura en los modelos anteriores y la nota sobre el almacenamiento local de la GPU. OpenAI, registro de cambios de la API: el lanzamiento del 20 de octubre de 2026. Runtime Wire: el ámbito de la Responses API, los agentes persistentes como uso previsto y la frase de OpenAI Developers sobre dots. Los cálculos de equilibrio y el ejemplo del agente de soporte son míos, con las suposiciones indicadas en las secciones 3 y 4.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.