El 1 de diciembre, sus llamadas a gemini-2.5-pro pasarán a ejecutarse en Gemini 3.8 Flash. Cambie usted el nombre del modelo antes de que lo haga Google

By Surya Pratap
19 de noviembre de 2026
8 min read
AI & Technology

19 de noviembre de 2026
8 min read
 Ver qué se enruta y qué hacer primeroHover to explore
La mayoría de las retiradas de modelos terminan con un error. Sus peticiones fallan, saltan las alertas y usted migra. Google ha elegido otro final para dos de sus modelos más usados. A partir del 1 de diciembre, las peticiones a gemini-2.5-pro y gemini-2.5-flash no fallarán. Las responderá otro modelo, y se facturarán al precio de ese modelo, mientras su código sigue pidiendo el antiguo. Nadie le avisará. Precisamente por eso merece su atención esta semana.
El 2 de noviembre Google marcó ambos modelos como obsoletos y fijó la misma fecha para los dos:
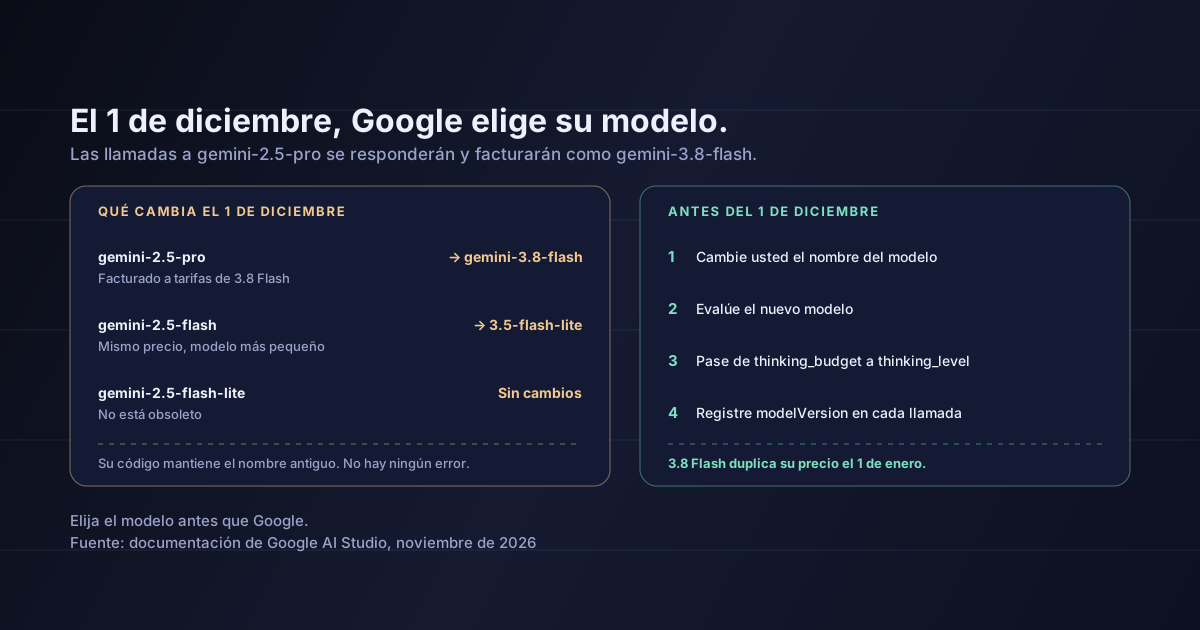
gemini-2.5-pro: «A partir del 1 de diciembre de 2026, todas las peticiones a la API dirigidas a gemini-2.5-pro se enrutarán automáticamente a gemini-3.8-flash y se facturarán a las tarifas de Gemini 3.8 Flash». Ya ha desaparecido del selector de modelos de Google AI Studio.gemini-2.5-flash: desde la misma fecha, las peticiones «se enrutarán automáticamente a gemini-3.5-flash-lite y se facturarán a las tarifas de Gemini 3.5 Flash-Lite».gemini-2.5-flash-lite: no está obsoleto. Google dice que «sigue disponible a través de la API hasta nuevo aviso».thought_signature, thinking_level en sustitución de thinking_budget, y la eliminación de los parámetros de muestreo y de los turnos de modelo prerrellenados».El consejo de Google es directo: actualice el nombre del modelo antes del 1 de diciembre y lea la guía de migración del nuevo modelo.
Una retirada que devuelve errores hace ruido. Se entera en minutos. Una retirada que enruta es silenciosa. Sus registros muestran respuestas correctas, sus paneles siguen en verde y las únicas señales son las que no estaba vigilando: respuestas que suenan distinto, una incidencia de soporte sobre una función que «ha empeorado», una línea de coste que se ha movido.
Fíjese en lo que hace cada ruta. gemini-2.5-pro es un modelo Pro; su sustituto es un modelo Flash. gemini-2.5-flash pasa a un modelo Flash-Lite. Puede que Google tenga razón y que los modelos más nuevos y pequeños basten para la mayor parte del tráfico. Pero «la mayor parte del tráfico» es la media de Google, no su producto. Si eligió 2.5 Pro porque un modelo más barato no superó sus pruebas, el 1 de diciembre deshace esa decisión sin preguntarle.
Una retirada que da error le dice que ha ocurrido. Una retirada que enruta solo se lo dice si está mirando.
Otro modelo. Las peticiones enrutadas las responde gemini-3.8-flash o gemini-3.5-flash-lite. Ambos leen hasta 1.048.576 tokens y escriben hasta 65.536, así que los límites de contexto no serán el problema. La calidad en sus tareas es la pregunta abierta.
Otros valores por defecto. La tabla de razonamiento de Google indica que gemini-3.5-flash-lite usa por defecto el nivel minimal, y gemini-3.8-flash el nivel medium. En 3.8 Flash, Google advierte que «minimal no está admitido y devuelve un error». Si nunca fijó el razonamiento de forma explícita, la cantidad de razonamiento detrás de sus respuestas cambiará por sí sola.
Otro contrato de API. Los cambios incompatibles no son cosméticos. thinking_level sustituye a thinking_budget. Las llamadas a funciones ahora validan thought_signature. Se eliminan los parámetros de muestreo, y también los turnos de modelo prerrellenados. Google no dice qué recibirá una petición enrutada que siga enviando los parámetros antiguos: un error o un ajuste ignorado sin avisar. Cualquiera de las dos cosas conviene descubrirla antes que sus usuarios.
Otra factura. Las peticiones se facturan a las tarifas del nuevo modelo. Las cuentas están en la sección siguiente, y llevan una segunda fecha.
Por millón de tokens, según la página de precios de Google:
| gemini-2.5-pro hoy | gemini-3.8-flash hasta el 31 de diciembre | gemini-3.8-flash desde el 1 de enero de 2027 | |
|---|---|---|---|
| Entrada, prompts de hasta 200K tokens | 1,25 $ | 0,75 $ | 1,50 $ |
| Entrada, prompts de más de 200K tokens | 2,50 $ | 0,75 $ | 1,50 $ |
| Salida, prompts de hasta 200K tokens | 10,00 $ | 3,75 $ | 7,50 $ |
| Salida, prompts de más de 200K tokens | 15,00 $ | 3,75 $ | 7,50 $ |
3.8 Flash tiene un precio de lanzamiento hasta el 31 de diciembre. Tome un paso de agente con 50.000 tokens de entrada y 5.000 de salida. En 2.5 Pro cuesta unos 0,11 $. Enrutado en diciembre, unos 0,06 $. Desde enero, de nuevo unos 0,11 $. Un paso cargado de entrada, con 150.000 tokens de entrada y 2.000 de salida, cuesta unos 0,21 $ hoy, 0,12 $ en diciembre y 0,24 $ en enero: más de lo que paga ahora.
Para gemini-2.5-flash el precio no se mueve. 2.5 Flash y 3.5 Flash-Lite figuran ambos a 0,30 $ por millón de tokens de entrada y 2,50 $ por millón de tokens de salida. Paga lo mismo por un modelo más pequeño.
# gemini_call.py — choose the model explicitly and log what served it
import logging
from google import genai
from google.genai import types

log = logging.getLogger("llm")
client = genai.Client()

MODEL = "gemini-3.8-flash"   # was "gemini-2.5-pro": change it before 1 December

def ask(prompt: str) -> str:
    resp = client.models.generate_content(
        model=MODEL,
        contents=prompt,
        config=types.GenerateContentConfig(
            # thinking_level replaces thinking_budget on Gemini 3 models
            thinking_config=types.ThinkingConfig(thinking_level="medium"),
        ),
    )
    # modelVersion: "the model version used to generate the response"
    log.info("requested=%s served=%s", MODEL, resp.model_version)
    return resp.text
Cambie usted el nombre. Busque gemini-2.5-pro y gemini-2.5-flash en su código, su configuración, su repositorio de prompts y cualquier herramienta no-code. Migrar en su propia fecha le permite probar, desplegar de forma gradual y volver atrás. Que le enruten en la fecha de Google no le da nada de eso.
Pruebe el sustituto, y sus alternativas. Ejecute su conjunto de evaluación con gemini-3.8-flash o gemini-3.5-flash-lite en cada nivel de razonamiento. Si una tarea de nivel Pro falla en Flash, pruebe un modelo más grande en lugar de aceptar la ruta. El sucesor que propone Google no es la única opción.
Corrija primero los cambios incompatibles. Sustituya thinking_budget por thinking_level. Elimine los parámetros de muestreo y los turnos de modelo prerrellenados. Revise su código de llamadas a funciones frente a la nueva validación de thought_signature. Ejecute sus pruebas de llamadas a herramientas de principio a fin, no solo prompts sueltos.
Registre modelVersion en cada llamada. La referencia de la API describe el campo de respuesta modelVersion como «la versión del modelo usada para generar la respuesta». Regístrelo junto al modelo que pidió. Si alguna vez no coinciden, lo verá el mismo día, no en la factura del mes siguiente.
Ese mismo día cambia otro precio
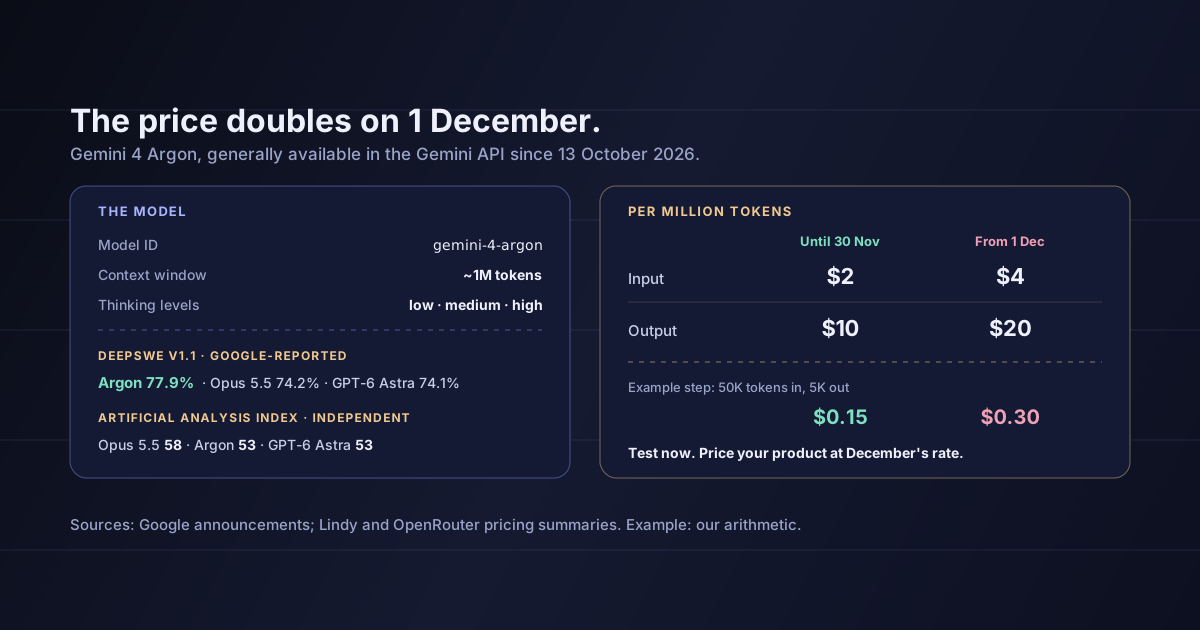
El 1 de diciembre también termina el precio de lanzamiento de Gemini 4 Carbon. La página de precios de Google lo indica a 2 $ por millón de tokens de entrada y 10 $ por millón de tokens de salida hasta el 30 de noviembre, y después a 4 $ y 20 $. Si trasladó algo a Carbon o a Argon durante el periodo de lanzamiento, revise también esos márgenes. Hicimos las mismas cuentas para Gemini 4 Argon.
Que 3.8 Flash sea peor que 2.5 Pro para usted. Es más reciente y, en muchas tareas, puede ser mejor. No he visto que Google publique una comparación directa de ambos en las mismas tareas. Lo decide su conjunto de evaluación.
Qué ocurre en Vertex AI. El changelog, la página de retiradas y la de precios que consulté cubren la Gemini API en Google AI Studio. No mencionan Vertex AI. Si llama a Gemini a través de Vertex, consulte su propio calendario de retiradas.
Cómo tratan las peticiones enrutadas los parámetros antiguos. Google enumera los cambios incompatibles, pero no dice si una petición enrutada que envía thinking_budget falla o se ajusta sin avisar. Pruébelo en lugar de suponerlo.
Que las fechas sean definitivas. La página de retiradas de Google dice que las fechas de cierre son «las fechas más tempranas posibles en las que un modelo podría retirarse». Pueden retrasarse. Planificar para el 1 de diciembre sigue siendo la opción segura.
Desde el 1 de diciembre de 2026, las peticiones a la Gemini API dirigidas a gemini-2.5-pro las responderá gemini-3.8-flash y se facturarán a sus tarifas, y las dirigidas a gemini-2.5-flash las responderá gemini-3.5-flash-lite sin cambio de precio. gemini-2.5-flash-lite no se ve afectado. Google enumera cambios incompatibles en la API para la transición, entre ellos thinking_level en sustitución de thinking_budget, una nueva validación en las llamadas a funciones y la eliminación de los parámetros de muestreo y de los turnos prerrellenados. 3.8 Flash cuesta menos que 2.5 Pro hasta el 31 de diciembre; desde el 1 de enero su precio se duplica, y el trabajo cargado de entrada acaba costando más que hoy.
El riesgo no es el nuevo modelo. Es que el cambio ocurra sin un error, sin una decisión y sin una prueba.
Antes del 1 de diciembre, sustituya cada gemini-2.5-pro y gemini-2.5-flash por un modelo que haya probado, corrija los cambios incompatibles y empiece a registrar modelVersion para saber qué modelo respondió a cada petición.
Fuentes: Google AI Studio, changelog de la Gemini API, entrada del 2 de noviembre de 2026: la retirada de gemini-2.5-pro y gemini-2.5-flash, el enrutamiento y la facturación automáticos desde el 1 de diciembre de 2026 y la lista de cambios incompatibles en la API. Retiradas: fechas de lanzamiento y de cierre, el estado de gemini-2.5-flash-lite y la nota de que las fechas de cierre son las más tempranas posibles. Precios: los precios de gemini-2.5-pro, gemini-2.5-flash, gemini-3.8-flash, gemini-3.5-flash-lite y Gemini 4 Carbon. Gemini 3.8 Flash y Gemini 3.5 Flash-Lite: límites de tokens y niveles de razonamiento. Referencia de la API generateContent: el campo de respuesta modelVersion. Todo consultado el 19 de noviembre de 2026. Los ejemplos de coste y la lectura de las secciones 2 a 6 son míos.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.