
El set de evaluación de tu MVP con IA: prueba tareas reales de usuarios antes del lanzamiento

By Surya Pratap
16 de julio de 2026
7 min read
MVP Strategy

16 de julio de 2026
7 min read
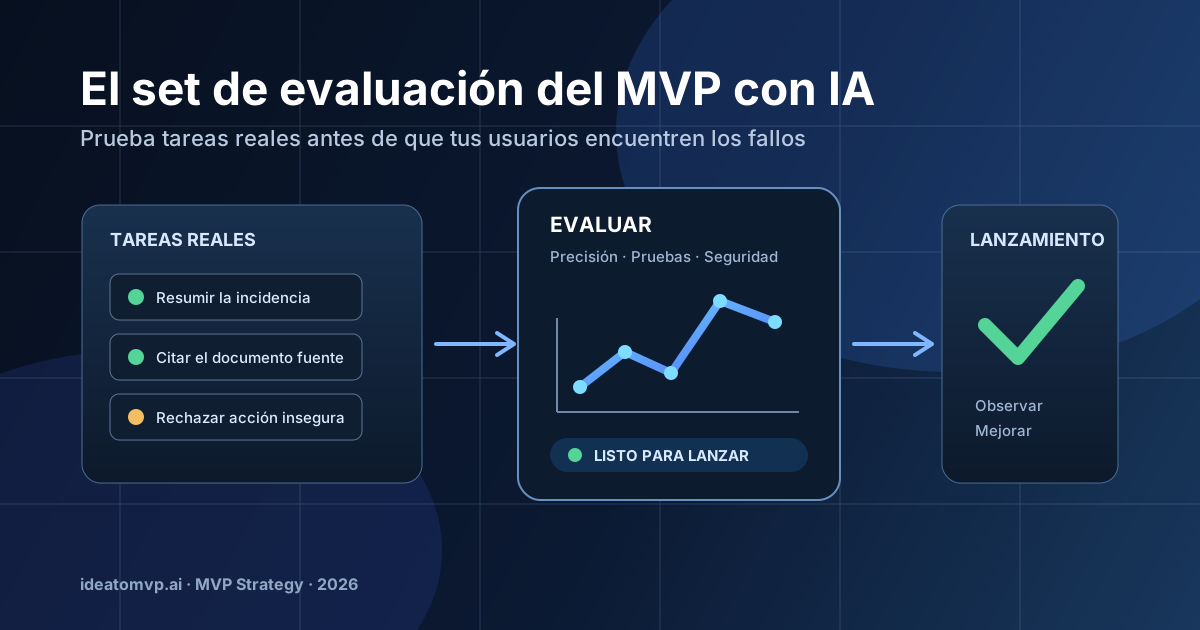
Una demo de IA puede resultar convincente y, aun así, fallar en el trabajo que el cliente realmente necesita. Puede dar una respuesta pulida a la que le falta un dato obligatorio, citar un documento que no respalda su conclusión o ejecutar una acción que el usuario nunca pretendía. Estos fallos son difíciles de ver cuando cada prompt de prueba se inventa sobre la marcha.
La respuesta práctica para un producto en fase temprana no es un enorme programa de benchmarks. Es un pequeño set de evaluación: una colección versionada de tareas reales, resultados esperados y reglas de puntuación claras que ejecutas cada vez que cambian el prompt, el modelo, el sistema de recuperación o el flujo de trabajo. Convierte el «esto parece mejor» en evidencia que puedes comparar.
Los fundadores suelen empezar eligiendo el modelo porque es lo visible y lo fácil de discutir. Pero los usuarios no compran un modelo; compran un resultado fiable. Escribe el trabajo que tu producto debe completar con las palabras que usaría un cliente: «convierte este hilo de soporte en un traspaso», «extrae la fecha de renovación de este contrato» o «sugiere una respuesta usando solo nuestra base de conocimiento aprobada».
Cada trabajo se convierte en un caso de prueba. Un caso útil incluye la entrada que aportaría el usuario, el contexto que tu sistema puede usar, el resultado esperado y el fallo que haría inaceptable el resultado. Así la evaluación sigue conectada al valor del producto, y no a una puntuación genérica de benchmark.
No necesitas cientos de ejemplos para aprender algo importante. Empieza con 15 a 20 casos sacados de llamadas de descubrimiento, trabajo hecho a mano, entrevistas con clientes, tickets de soporte o documentos que tengas permiso para usar. Incluye casos corrientes, no solo casos límite espectaculares. Si la tarea habitual sale mal, el producto no es útil.
Protege los datos de los clientes al reunir ejemplos
Usa en tu set de evaluación entradas consentidas, anonimizadas o sintéticas. Elimina credenciales, datos personales y el contexto de cliente que no sea necesario. Lo que importa es conservar la estructura de la tarea y los criterios de decisión, no crear otra copia sin control de datos sensibles.
La coincidencia exacta de cadenas suele ser demasiado frágil para un resultado generativo. Puntúa en su lugar las propiedades que definen un resultado útil. En un extractor de contratos, eso puede significar que la fecha es correcta, que se indica el pasaje de origen y que la incertidumbre se hace explícita cuando la fecha no aparece. En un copiloto de soporte, puede significar que el resumen conserva el problema del cliente, evita compromisos inventados y recomienda la siguiente acción aprobada.
Al principio funciona bien una rúbrica sencilla de tres niveles: aprobado para un resultado sobre el que el usuario podría actuar, requiere revisión para un resultado útil solo en parte y suspenso para un error material, una afirmación sin respaldo o un comportamiento inseguro. Añade un motivo breve junto a cada resultado que no apruebe. Esos motivos son tu backlog de producto.
Una única puntuación puede ocultar la razón por la que un flujo no está listo para salir. Mide tres dimensiones por separado. La calidad pregunta si la respuesta resuelve la tarea. La seguridad pregunta si el sistema se mantuvo dentro del comportamiento permitido y del perímetro de datos. Las operaciones preguntan si el flujo responde lo bastante rápido y con un coste que el negocio pueda sostener.
Esta separación hace visibles las concesiones. Un modelo más grande puede mejorar una tarea de razonamiento difícil pero llevar el tiempo de respuesta más allá de lo que tolera un asistente dentro del producto. Un cambio en la recuperación puede mejorar la relevancia y, a la vez, aumentar las citas sin respaldo. Tratar cada dimensión de forma independiente te ayuda a decidir si ajustar, enrutar de otra manera, añadir un punto de control humano o acotar el alcance de la funcionalidad.
Ejecuta los mismos casos antes y después de cada cambio relevante: una reescritura del prompt, un modelo nuevo, instrucciones de sistema modificadas, nuevos fragmentos de recuperación o una nueva herramienta del agente. No lances porque la última salida parezca impresionante en una sola conversación. Lanza cuando el cambio mejore o mantenga los resultados que importan a tus usuarios y no cree nuevos fallos de seguridad.
Tu primer set de evaluación no es una certificación. Es un hábito de producto disciplinado. Guarda los casos, sus resultados esperados, la rúbrica de puntuación y los resultados junto al trabajo de la funcionalidad. Asigna a cada caso un responsable y un motivo de existir. Cuando un cliente descubra un fallo relevante, conviértelo en una prueba de regresión anonimizada antes de corregirlo.
Un MVP con IA se vuelve creíble cuando es fiable en el trabajo concreto que promete hacer. Un set de evaluación compacto da a los fundadores una forma de mejorar esa fiabilidad de manera deliberada, antes de que una demo pulida se convierta en una sorpresa costosa en producción.


IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.