
LiteLLM como pasarela de datos de IA: cómo proteger la información sensible de tus clientes

By Surya Pratap
15 de julio de 2026
8 min read
AI & Technology

15 de julio de 2026
8 min read
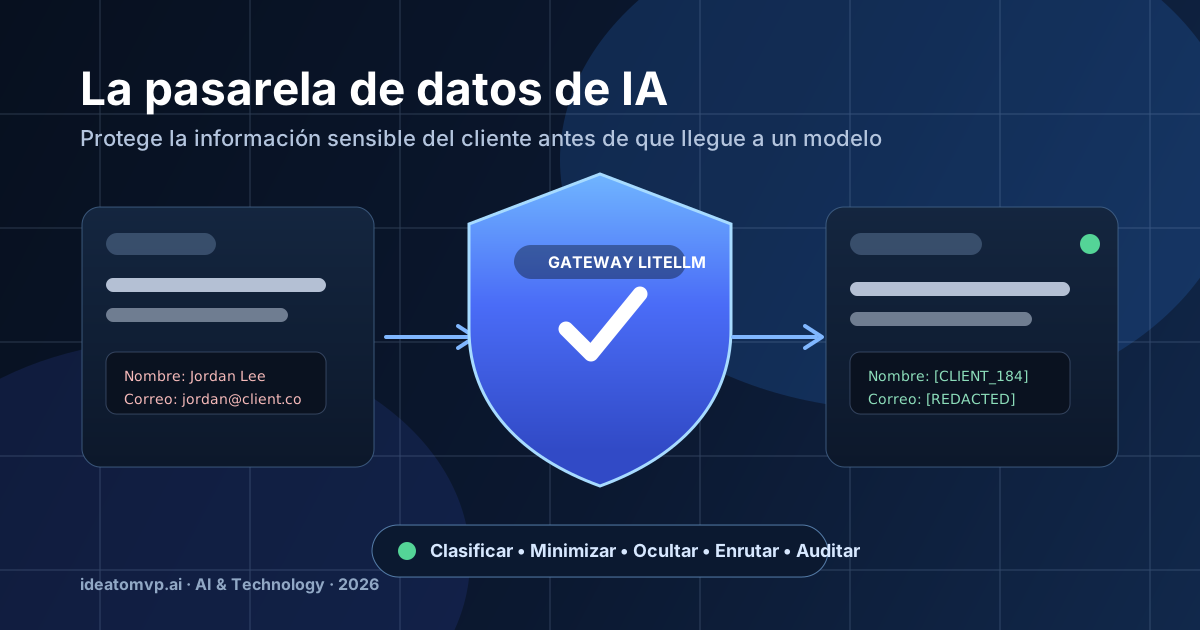
La decisión de arquitectura de IA con más consecuencias a menudo no es qué modelo eliges. Es decidir en qué punto los datos de los clientes cruzan la frontera entre tu aplicación y el sistema de un proveedor de modelos. Una transcripción de soporte puede contener un número de cuenta. Un formulario de admisión sanitaria puede contener un diagnóstico. Un prompt de ventas puede contener un contrato, una excepción de precio o una hoja de ruta privada. Enviar ese contexto directamente desde cada funcionalidad a cada proveedor crea un perímetro de datos que no puedes ver ni gobernar de forma fiable.
LiteLLM resulta útil aquí no solo porque da a los equipos una única API para muchos modelos. Usado con intención, se convierte en una pasarela de IA: un único lugar controlado donde aplicar políticas antes de que cualquier petición salga de tu entorno, para después enrutar la petición ya minimizada hacia un proveedor de modelos aprobado.
Sin una pasarela, un equipo de producto va acumulando llamadas directas a SDK en el chat, el soporte, la búsqueda de documentos, la analítica y los flujos de agentes. Cada llamada puede elegir un proveedor distinto, usar una configuración de registros diferente y llevar una cantidad distinta de contexto del cliente. Las revisiones de seguridad se convierten en una búsqueda por el código de la aplicación en lugar de la revisión de un único perímetro de políticas.
Esto no es un argumento para prohibir que cualquier dato llegue a un modelo. La pregunta útil es más concreta: ¿qué información es necesaria para esta tarea, qué campos son sensibles y qué proveedor está aprobado para procesar el prompt resultante? Una pasarela da a esas preguntas un lugar donde hacerlas cumplir.
Ocultar datos no es todo el control
La detección por patrones solo encuentra lo que sabe buscar. Trata la ocultación como un control más dentro de un diseño por capas: contratos de entrada estructurados, campos en lista de permitidos, política de proveedores, controles de acceso, reglas de retención y revisiones de lo que conservan tus registros. Una pasarela hace que esos controles sean coherentes; no elimina la necesidad de diseñarlos.
Elige la transformación según lo que el modelo necesite hacer. Si el nombre de un cliente no aporta nada a una tarea de resumen, sustitúyelo por una etiqueta genérica. Si el modelo debe distinguir a dos personas a lo largo de una conversación, usa un marcador estable como CLIENT_184 y guarda la correspondencia dentro de tu propio sistema. Si un prompt incluye una credencial, un número de tarjeta de pago o datos que tu política prohíbe que salgan del entorno, bloquea la petición y devuelve un mensaje seguro a la funcionalidad que la hizo.
El patrón más sólido suele ser minimizar los datos antes de detectarlos: construir los prompts a partir de un conjunto pequeño y tipado de campos permitidos, en lugar de enviar un registro completo de la base de datos e intentar limpiarlo después.
No empieces poniendo todas las funcionalidades de IA detrás de un motor de políticas complejo. Empieza por el flujo con la exposición de datos de clientes más evidente: el resumen de tickets de soporte, la extracción de documentos o un asistente interno con acceso a los registros de clientes. Mapea los campos que envía hoy, decide cuáles son necesarios y coloca una única ruta de pasarela delante. La política y la telemetría resultantes te mostrarán dónde el siguiente flujo necesita una regla distinta.
El objetivo no es hacer que la IA sea inutilizable. Es que cada llamada a un modelo sea intencionada, explicable y reversible. Una capa de abstracción basada en LiteLLM convierte la elección de proveedor y la protección de los datos de los clientes, que hoy son un detalle de implementación disperso, en una arquitectura que tu equipo puede inspeccionar y mejorar.


IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.