
El stack multimodelo: cómo las startups están recortando un 85% sus costes de programación con IA en 2026

By Surya Pratap
8 de julio de 2026
9 min read
AI & Technology

8 de julio de 2026
9 min read
El 7 de julio de 2026, Paul Graham publicó un experimento mental de una sola línea que se adueñó del Twitter tecnológico: «Imagina cómo será si dentro de 5 años los modelos han mejorado respecto a Fable tanto como Fable ha mejorado respecto a GPT-3». Las citas se dividieron como siempre: la mitad asombro, la mitad escepticismo. Pero la conversación más útil no iba de 2031 en absoluto. Estaba en las respuestas, donde desarrolladores en activo publicaron sus facturas.
$200 al día. $350 al día. $500 al día en bucles intensivos de agentes. No eran casos aislados: era un goteo constante de fundadores e ingenieros diciendo lo mismo. Los últimos modelos frontera son asombrosos, y pasar todo tu flujo de desarrollo por ellos se está convirtiendo, sin hacer ruido, en una de las mayores partidas del presupuesto de una startup pequeña. Esa misma semana, un patrón alternativo se hizo viral en Reddit y en X: el stack multimodelo, y sus números merecen la atención de cualquier fundador.
Estas son las cuentas incómodas. Los modelos frontera actuales cuestan, a precio de lista, unos $10 por millón de tokens de entrada y $50 por millón de tokens de salida. Los modelos de gama media de los mismos laboratorios cuestan una quinta parte o menos. Y para buena parte de lo que realmente hace un flujo de desarrollo (renombrar variables, escribir código repetitivo, generar pruebas a partir de una especificación clara, corregir errores de lint, iterar sobre CSS), el modelo de gama media produce esencialmente el mismo resultado.
Cuando lo pasas todo por el modelo frontera, pagas la prima el 100% del tiempo por un trabajo que la necesita quizá el 20% del tiempo. Así es como un fundador en solitario acaba con una factura de IA de $6,000/mes antes de tener un solo cliente de pago.
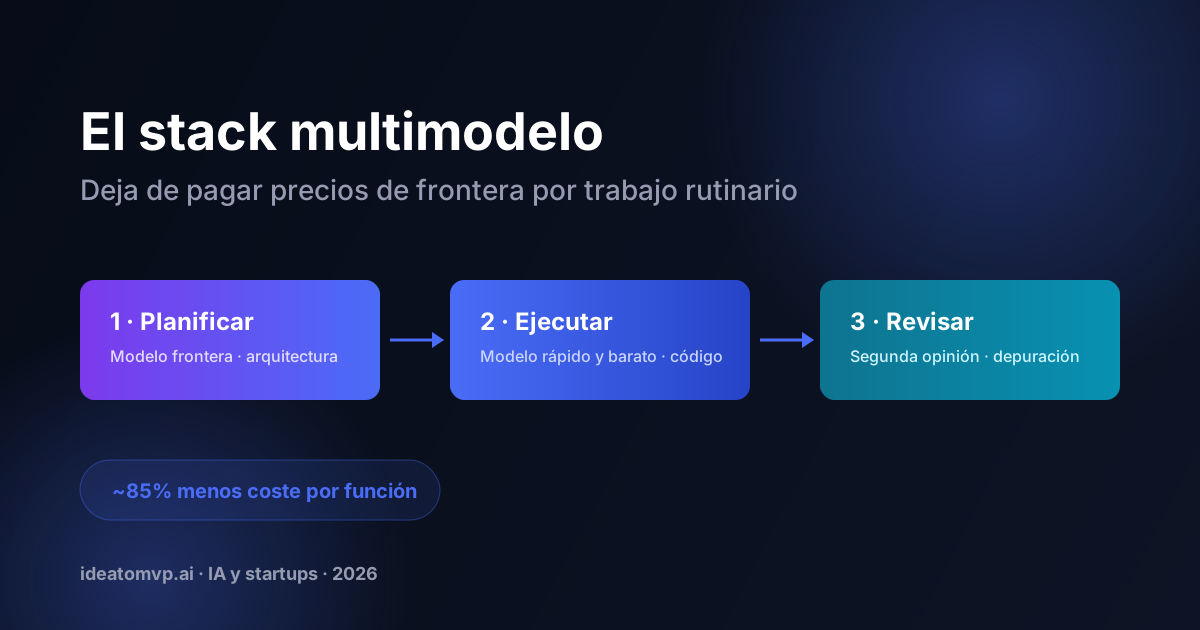
El stack multimodelo que se hizo viral esta semana tiene tres fases, y cada una se dirige al modelo mejor preparado, y mejor de precio, para esa tarea:
Las cuentas por funcionalidad
Los equipos que aplican este patrón hablan de una reducción de costes de alrededor del 85% por funcionalidad con una calidad comparable o mejor, porque el modelo caro solo interviene en los pasos cortos y de mayor impacto, y la generación cargada de tokens ocurre en modelos con precio de volumen. En un equipo que entrega docenas de funcionalidades por sprint, esa es la diferencia entre que el gasto en IA sea un error de redondeo o tu segundo mayor coste después de los salarios.
Una gran empresa puede absorber una factura de IA inflada. Una startup en fase pre-seed no puede y, más importante aún, el hábito se acumula. Los equipos que tratan pronto el enrutamiento de modelos como una disciplina de ingeniería terminan con tres ventajas estructurales:
Es difícil exagerar la distancia entre GPT-3 y los modelos frontera actuales, y si los próximos cinco años la repiten, la mayoría de los debates actuales sobre flujos de trabajo parecerán pintorescos. Pero ese futuro corta en las dos direcciones: todos los modelos frontera del pasado acabaron convertidos en modelos de consumo masivo. El buque insignia de hoy a $50 por millón de tokens será el ejecutor barato del año que viene. Un stack multimodelo no es una apuesta contra el progreso de la IA: es la arquitectura que se beneficia de él automáticamente, porque cada nuevo lanzamiento entra en tu tabla de enrutamiento en el nivel que justifique su precio.
Las startups que ganen este ciclo no serán las que más gasten en tokens. Serán las que construyan la disciplina de gastar exactamente lo que vale cada tarea, y que lancen más rápido gracias a ello.
Si estás construyendo un producto de IA y quieres ayuda para diseñar una arquitectura de enrutamiento de modelos que mantenga tu gasto predecible, reserva una llamada de descubrimiento gratuita: es exactamente el tipo de sistema que entregamos a fundadores cada mes.



IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.