Integración vertical de IA para empresas: ser dueño de las capas de GPU, modelo y aplicación en 2026

Surya Pratap
By Surya Pratap

7 de julio de 2026

11 min read

AI & Technology
Integración vertical de IA: las capas de GPU, modelo ajustado y aplicación

Durante los últimos tres años, la arquitectura de IA empresarial por defecto ha sido horizontal: alquilar un modelo frontera a través de una API, conectarlo a una docena de flujos de trabajo y pagar por token. Era rápido para empezar y caro para quedarse. En 2026, las empresas más grandes y más serias operativamente están haciendo lo contrario sin hacer ruido: integrar verticalmente su stack de IA, capa a capa, en torno a los casos de uso que de verdad mueven su cuenta de resultados.

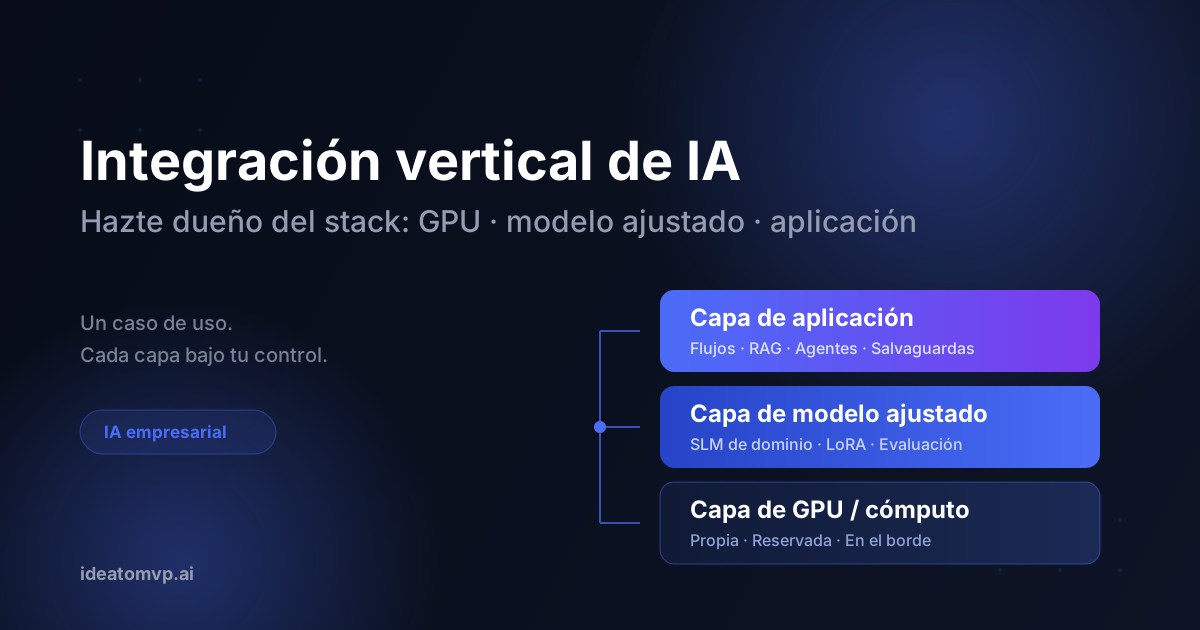
La integración vertical en IA significa lo mismo que significó para Ford y el acero o para Apple y el silicio: ser dueño de las capas de tu cadena de valor que crean diferenciación, en lugar de alquilárselas a un proveedor que también sirve a tus competidores. En IA, esas capas son tres: la capa de cómputo (GPU), la capa de modelo y la capa de aplicación. Este artículo recorre cada una, explica por qué por fin salen las cuentas de la integración y describe la secuencia que permite a una empresa hacer la transición sin jugarse la compañía.

Por qué la integración vertical, y por qué ahora

Tres fuerzas se juntaron para que poseer el stack resulte racional para empresas que en 2024 se habrían reído de la idea.

  • Los costes de API dejaron de crecer con el valor. Las empresas que usan IA en flujos de producción hablan de facturas mensuales de API de cinco y seis cifras en las que la mayoría de los tokens se gastan en tareas repetitivas y acotadas (clasificación, extracción, resumen) que no necesitan en absoluto un modelo frontera. Pagar precios de frontera por inferencia rutinaria es el equivalente en IA a ejecutar trabajos por lotes en instancias cloud bajo demanda de gama alta.
  • Los modelos de pesos abiertos cerraron la brecha de calidad en tareas acotadas. Un modelo pequeño ajustado, entrenado con tus propios datos etiquetados, ya supera de forma habitual a un modelo frontera con prompts en la tarea concreta para la que se entrenó, con una fracción de la latencia y el coste. La brecha solo importa en el razonamiento abierto, que es una minoría de las cargas de trabajo empresariales.
  • La soberanía de los datos se convirtió en un tema del consejo de administración. Los sectores regulados (sanidad, finanzas, defensa, legal) cada vez pueden menos enviar sus datos más valiosos a una API de terceros, sin más. La elección no es «alquilar o poseer»; es «poseer o no desplegar».

La lógica estratégica es la misma que Alex Karp, de Palantir, lleva tiempo repitiendo en público: controla tu cómputo, los pesos de tus modelos y tus datos, o verás cómo el valor de tu conocimiento propio se filtra al entrenamiento de otro. La integración vertical es la forma en que ese principio se convierte en arquitectura.

Capa 1: la capa de GPU / cómputo

Ser dueño de la capa de cómputo no significa construir un centro de datos. Significa pasar del precio por token a una capacidad que controlas, en la forma que encaje con tu escala:

  • Nube de GPU reservada: capacidad comprometida de A100/H100 de proveedores como CoreWeave, Lambda o los niveles reservados de los hiperescaladores. Es el punto de entrada para la mayoría de las empresas: coste predecible, sin inversión de capital y sin un equipo de operaciones de hardware.
  • Hardware de inferencia propio: un pequeño rack de tarjetas L40S o de clase RTX para inferencia estable y sensible a la latencia. Una sola GPU moderna sirve un modelo ajustado de 7B a cientos de usuarios simultáneos; el hardware se amortiza frente a las facturas de API en meses, no en años.
  • Inferencia en el borde: modelos cuantizados que se ejecutan en tus instalaciones o en el dispositivo cuando los datos no pueden salir del edificio: redes hospitalarias, plantas de fabricación, mesas de operaciones.

La regla de decisión es la utilización. Si tu volumen de inferencia es estable y predecible, gana la capacidad propia o reservada. Si es irregular y experimental, mantén esa carga de trabajo en cómputo alquilado e integra primero las estables.

Capa 2: la capa del modelo ajustado

Esta es la capa en la que la integración vertical crea un foso defensivo. Una API frontera da a todos los competidores la misma inteligencia al mismo precio. Un modelo ajustado con tu historial de transacciones, tus conversaciones de soporte, tus contratos o tus informes de defectos es una inteligencia que solo tienes tú.

El pipeline moderno de fine-tuning es mucho más ligero de lo que suponen la mayoría de los directivos:

  • Elección del modelo base: parte de un modelo de pesos abiertos (Llama, Phi, Gemma, Mistral) dimensionado para la tarea. La mayoría de las tareas empresariales caen en el rango de 3B–8B.
  • Entrenamiento eficiente en parámetros: LoRA y QLoRA adaptan un modelo base con miles de ejemplos en una sola GPU en horas. El trabajo real no es el cómputo sino la curación de datos: la calidad de tus ejemplos etiquetados decide la calidad del modelo.
  • Ciclos de evaluación: un conjunto de prueba reservado, puntuado con tu métrica de negocio real y ejecutado en cada reentrenamiento. Esta es la disciplina que separa los programas de modelos en producción de los proyectos de ciencias.
  • Cadencia de reentrenamiento: reentrenamientos mensuales o trimestrales con datos de producción recientes. Cada ciclo amplía la distancia entre tu modelo y cualquier cosa que un competidor pueda conseguir con ingeniería de prompts.

La prueba de integración para la capa de modelo

Hazte una sola pregunta: ¿esta tarea se beneficia de un conocimiento que solo tenemos nosotros? Si la respuesta es sí, haz fine-tuning y sé su dueño. Si es no, si un modelo genérico con buenos prompts hace el trabajo, sigue alquilando esa tarea y dedica tu presupuesto de entrenamiento a donde tus datos sean la ventaja.

Capa 3: la capa de aplicación

La capa de aplicación es donde el modelo se encuentra con el negocio, y es la capa en la que las empresas se equivocan más a menudo: o la dejan en manos de un proveedor SaaS (y pierden el flujo de trabajo junto con los datos) o invierten en ella menos que en el modelo. Una capa de aplicación integrada verticalmente incluye:

  • Infraestructura de servicio: vLLM o TGI para inferencia de alto rendimiento, con imposición de salida estructurada para que los sistemas posteriores reciban JSON válido y no prosa.
  • Recuperación (RAG) sobre tu propio conocimiento: tus documentos, vectorizados e indexados en tu infraestructura, para que el modelo responda a partir de tu fuente de verdad y no de sus datos de entrenamiento.
  • Enrutamiento inteligente: el corazón pragmático del stack. Envía entre el 70% y el 80% de las peticiones a tu modelo ajustado y escala el 20–30% de verdad difícil y abierto a una API frontera. La integración vertical no es pureza: es poner cada petición en la capa más barata que la resuelva bien.
  • Salvaguardas y auditoría: filtrado de entradas y salidas, tratamiento de datos personales y registro completo de las peticiones. Cuando el stack es tuyo, el cumplimiento normativo deja de ser un cuestionario de proveedores y se convierte en una propiedad de tu arquitectura.

La secuencia: cómo hacen el cambio las empresas en la práctica

Ninguna empresa integra verticalmente todo a la vez. El patrón que funciona va de arriba abajo, al revés de como se lee el diagrama del stack:

  • Sé dueño primero de la capa de aplicación. Construye tus flujos de trabajo, la recuperación y el enrutamiento sobre API frontera alquiladas. Aquí es donde aprendes cómo es tu distribución real de peticiones, que son los datos que necesitas para todas las decisiones posteriores.
  • Integra la capa de modelo para tu tarea de mayor volumen. Elige la carga de trabajo que más gasto de API consume, ajusta un modelo pequeño para ella y colócalo detrás del enrutador. Mide la calidad y el coste frente a la referencia de la API.
  • Integra el cómputo cuando la utilización lo justifique. Cuando tu inferencia autoalojada sea estable, pásala de la nube de GPU bajo demanda a capacidad reservada o propia, y fija el suelo de costes.

Cada paso se justifica de forma independiente por su propio retorno, y cada paso es reversible. Eso es lo que convierte esto en una estrategia y no en una apuesta.

Cuándo no integrar

La integración vertical no es para ti si tus cargas de trabajo de IA siguen siendo exploratorias, si te faltan los datos etiquetados que hacen que el fine-tuning merezca la pena o si tus tareas principales requieren de verdad un razonamiento a escala de frontera y un conocimiento amplio del mundo. En esos casos, el stack alquilado no es una trampa: es la herramienta correcta. El error es quedarse en él por defecto cuando tus cargas de trabajo ya se han vuelto acotadas, estables y ricas en datos.

Conclusión

Las empresas que ganan con la IA en 2026 no son las que tienen los mayores presupuestos de API. Son las que identificaron su caso de uso de mayor valor y mayor volumen e integraron el stack por debajo de él: una lógica de aplicación que controlan, un modelo entrenado con datos que solo ellas tienen, funcionando sobre un cómputo con precio de infraestructura en lugar de un servicio medido por consumo. Empieza por la parte de arriba del stack, baja una capa cada vez y deja que el retorno de cada capa financie la siguiente.

Si estás valorando por dónde empezar (qué carga de trabajo ajustar primero o si tu volumen justifica un cómputo propio), reserva una llamada de descubrimiento gratuita y trazaremos tu stack contigo.


IdeaToMVP Academy

Want to build with AI — not just read about it?

4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.

Explore the Academy →
Share this post :