Um tutor de IA igualou tutores humanos experientes por 1/918 do custo. Era o modelo mais barato testado

By Surya Pratap
2 de outubro de 2026
9 min read
AI & Technology

2 de outubro de 2026
9 min read
 Preço por ponto, não por tokenHover to explore
A maioria das comparações entre modelos de IA é sobre o que os modelos conseguem fazer. Esta é sobre o que aprenderam as pessoas que os usaram, medido antes e depois, contra um grupo de controlo e contra professores humanos experientes. O resultado mais útil para os fundadores não tem nada a ver com educação.
Tudo o que se segue vem de «StudentBench: AI and human tutoring yield equivalent GRE learning gains», de Curtis Northcutt, Inaara Hasmani, Kevin Feng, Trevor Khangi, Andreas Plesner e Jonas Mueller, da Handshake AI Research, um preprint publicado a 23 de setembro de 2026 e revisto a 30 de setembro. Os dados anonimizados são de acesso aberto. A Handshake também gere a plataforma de tutoria StudentBench usada no estudo. A leitura a partir da secção 3 é minha.
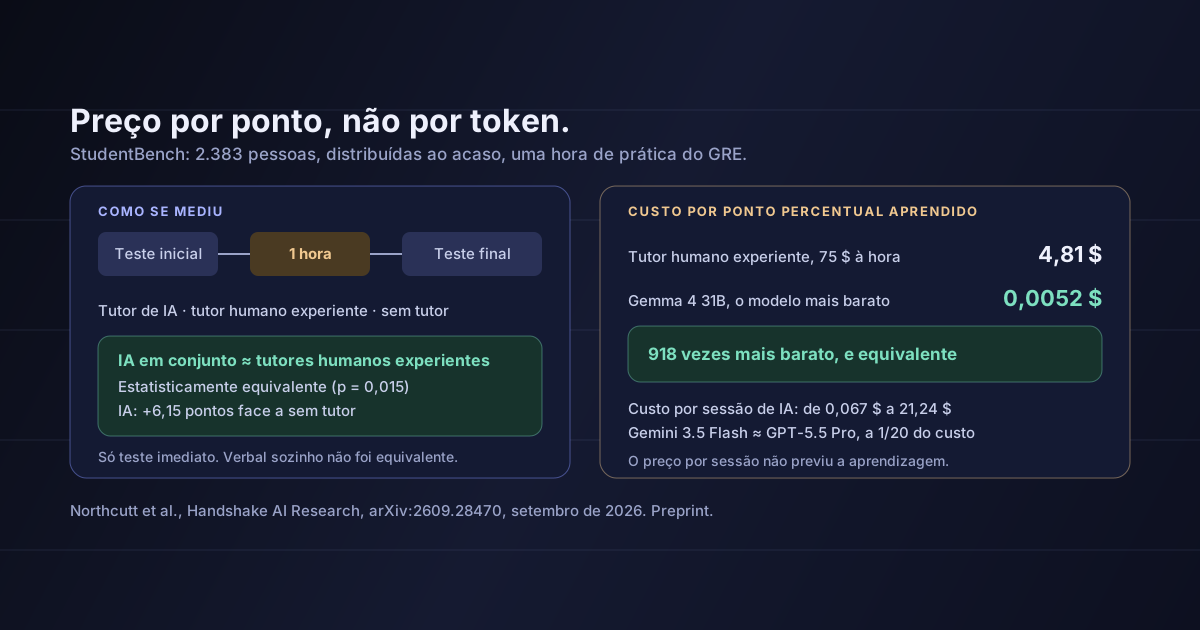
O estudo recrutou 2.383 adultos, a maioria entre os 18 e os 24 anos, para se prepararem para o GRE, um exame de acesso a pós-graduações. Cada sessão tinha a mesma estrutura:
O ganho de aprendizagem era a pontuação do teste final menos a do inicial, em pontos percentuais. Os tutores humanos eram antigos autores de perguntas do GRE ou tutores com pelo menos cinco anos de experiência, e não podiam ver as perguntas do teste final.
A tutoria com IA, no conjunto, foi estatisticamente equivalente à tutoria com especialistas humanos nos ganhos no GRE (p = 0,015, dentro de uma margem de um quarto de desvio-padrão). A diferença média entre IA e humanos foi de −0,58 pontos percentuais. Ambas foram melhores do que não ter tutor: a tutoria com IA acrescentou 6,15 pontos face ao grupo de controlo.
Seis dos tutores de IA passaram individualmente o teste de equivalência contra os tutores humanos. Em cinco das sete áreas do GRE, o melhor tutor de IA saiu-se, em média, melhor do que os tutores humanos.
Depois, o custo.
O preço de um modelo não dizia quase nada sobre quanto um estudante aprenderia com ele. Só medir a aprendizagem o dizia.
Esta é a lição que vai além da tutoria. Os autores não compararam os modelos num benchmark nem pelo preço por token. Compararam-nos pelo custo por unidade do resultado que o produto existe para produzir: aqui, dólares por ponto percentual de aprendizagem.
Visto assim, a ordem dos modelos muda. Um modelo que custa 300 vezes mais por sessão só compensa se produzir 300 vezes mais daquilo que vendes, e neste estudo o extremo caro não o fez.
A maioria dos produtos de IA é definida e construída ao contrário. A equipa escolhe um modelo capaz e caro porque dá segurança, mede o custo por chamada e nunca mede o que cada chamada consegue para o utilizador. Sem o resultado, não há forma de saber se um modelo vinte vezes mais barato faria o trabalho igualmente bem.
Há um resultado secundário fácil de deixar passar. Nas sessões da parte quantitativa, respostas mais rápidas da IA estiveram associadas a mais mensagens dos estudantes; mais mensagens, a mais exercícios resolvidos corretamente; e mais prática correta, a maiores ganhos de aprendizagem (tudo com p < 0,002).
É uma correlação, não uma experiência controlada, e os autores apresentam-na como tal. Mas aponta para algo que os fundadores costumam subestimar: num produto interativo, a latência não é um pormenor técnico. Se um modelo mais lento e mais inteligente significa menos rondas de prática, o utilizador pode acabar por aprender — ou obter — menos, e não mais.
O mais valioso do StudentBench para um fundador é a forma como mediu, e quase todo o desenho é barato de reproduzir.
Mede antes e depois. Define o resultado que o teu produto altera e mede-o no início e no fim de uma sessão. Pontuações de satisfação e tempo na aplicação não são resultados.
Mantém um grupo de controlo sem IA. Sem ele, não consegues saber que parte da melhoria vem do teu produto e que parte teria acontecido de qualquer forma. Aqui, não ter tutor também produziu algum ganho.
Compara modelos com os mesmos utilizadores. Distribui os utilizadores ao acaso por dois ou três modelos e compara resultados, não só custos. Um modelo mais barato que se revela equivalente é uma decisão de margem bruta à espera de ser tomada.
Divide o custo pelo resultado. Reporta o custo por unidade de resultado — por pedido resolvido, por resposta certa, por ponto aprendido — e toma as decisões de modelo com base nesse número.
Para as equipas que compram ou dão formação em IA, o resultado é animador, mas num sentido restrito. Na prática de exercícios com respostas claramente certas, um tutor de IA consegue igualar um especialista humano numa sessão, por uma fração mínima do custo. Faz sentido usar tutores de IA para praticar entre sessões ao vivo.
Não mostra que a IA substitui um professor humano. O estudo mediu uma hora e um teste imediato. Se os ganhos se mantêm, e se a tutoria com IA funciona igualmente bem para competências abertas, são perguntas que não colocou.
É um preprint da empresa que gere a plataforma. A Handshake AI Research fez o estudo no próprio serviço StudentBench da Handshake. Os dados foram publicados em aberto, o que ajuda, mas o estudo não passou por revisão por pares.
O grupo com tutores humanos era pequeno. Cerca de 140 sessões com tutor humano contra mais de 2100 com IA. A equivalência foi estabelecida para a IA no conjunto; as comparações individuais têm menos suporte.
A parte verbal não estabeleceu equivalência sozinha. O resultado conjunto combina as secções quantitativa e verbal. Na parte verbal isolada não se demonstrou equivalência, e os tutores humanos tiveram o maior ganho médio nas três áreas verbais.
Os ganhos são imediatos. Não se fez qualquer teste diferido. Uma aprendizagem visível uma hora depois pode não ser visível um mês depois, em nenhum dos grupos.
O custo humano é uma tarifa de referência. O valor de 4,81 dólares usa uma tarifa publicada de 75 dólares à hora de uma fonte de 2018. Os preços reais de tutoria variam muito, o que muda o múltiplo, mas não a direção.
Não verifiquei o resultado individual de cada modelo. O artigo dá alguns números só em gráficos. Usei apenas os resultados que estão no texto.
O StudentBench é uma das comparações mais cuidadosas até agora entre o ensino com IA e o ensino humano: aleatorizado, controlado, com tutores humanos experientes e dados abertos. Numa hora de prática para o GRE, a tutoria com IA foi tão eficaz como um especialista humano, e o modelo mais barato testado esteve entre os que os igualaram.
Para os fundadores, a lição mais duradoura está no método. Os autores escolheram os modelos pelo custo por unidade do resultado que lhes interessava, e mediram esse resultado contra um grupo de controlo. Isso pôs um modelo de 0,067 dólares ao nível de especialistas humanos, e mostrou que a opção mais cara não era a que se devia escolher.
Antes de escolheres um modelo pelo preço ou pela reputação, mede o que cada um produz realmente para os teus utilizadores, e divide o custo por isso.
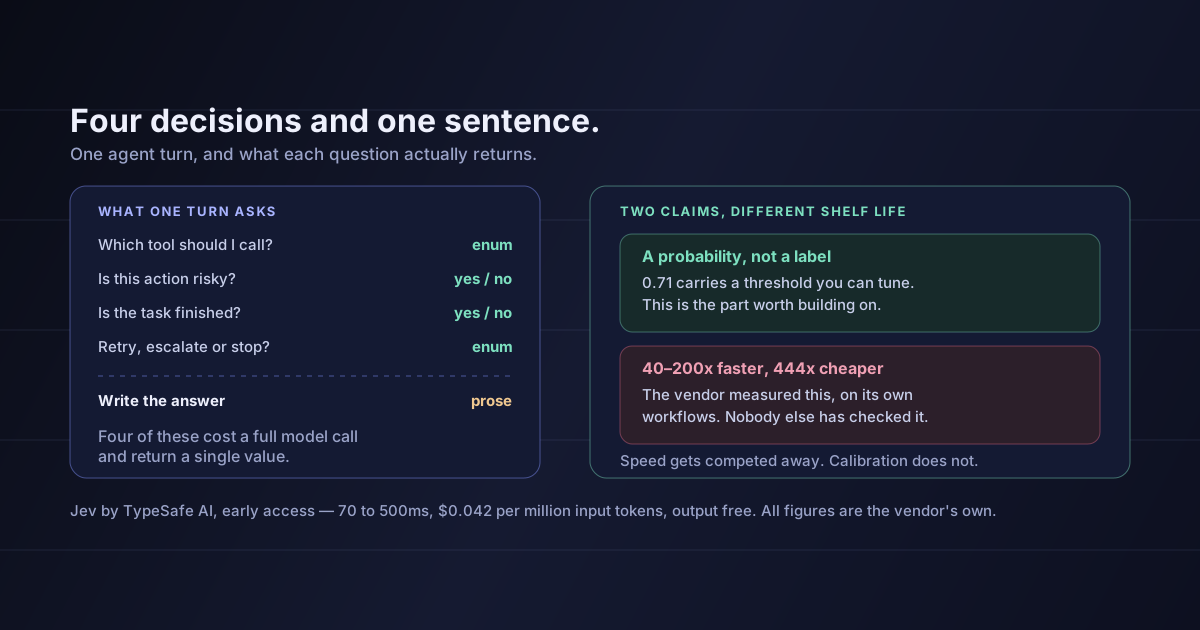
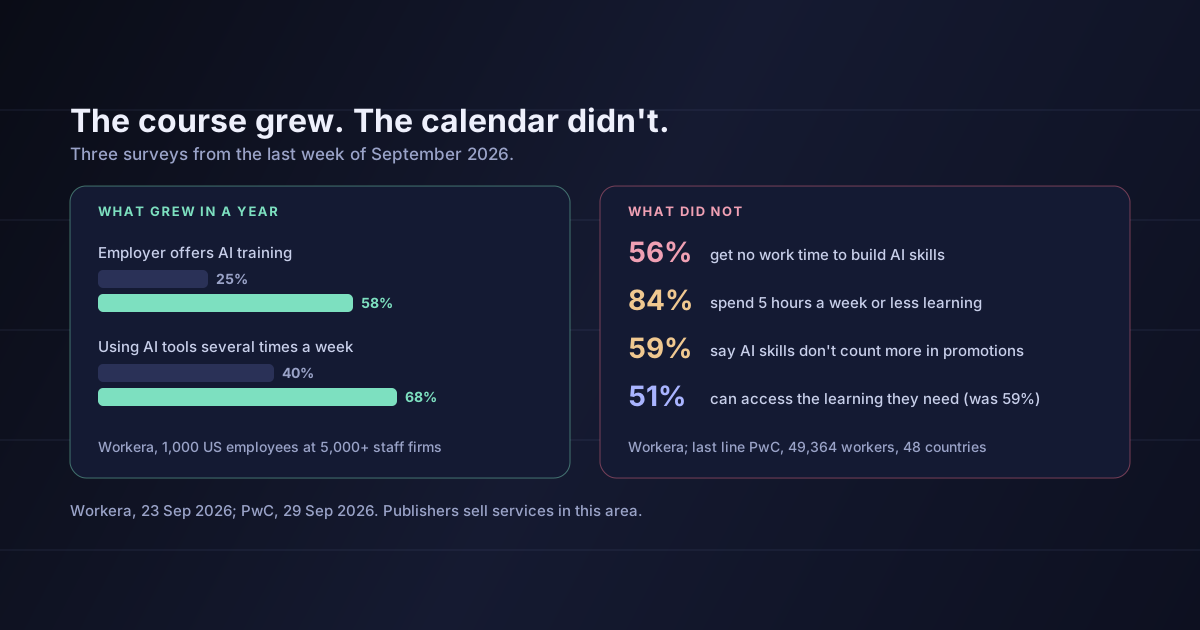
Fonte: Curtis Northcutt, Inaara Hasmani, Kevin Feng, Trevor Khangi, Andreas Plesner e Jonas Mueller, «StudentBench: AI and human tutoring yield equivalent GRE learning gains», arXiv:2609.28470, v1 de 23 de setembro de 2026, v2 de 30 de setembro de 2026 — os 2.383 participantes, o desenho com teste inicial, uma hora de condição e teste final paralelo, as 13 configurações de tutor de IA por secção e os tutores humanos experientes, o resultado de equivalência conjunto (p = 0,015), a diferença de −0,58 pontos, o ganho de 6,15 pontos face ao controlo, as seis equivalências individuais, o resultado em cinco de sete áreas, os custos por sessão de 0,067 e 21,24 dólares, a equivalência do Gemma 4 31B (p = 0,044) e os seus 0,0052 dólares contra 4,81 por ponto percentual a 75 dólares à hora, a comparação entre o Gemini 3.5 Flash e o GPT-5.5 Pro, as correlações entre latência e participação, a dimensão dos grupos, o resultado só da parte verbal e as limitações declaradas, tal como aí publicados. Dados anonimizados e código: StudentBench no GitHub. A leitura das secções 3 a 6 é minha. Sobre porque é que os modelos pequenos ganham muitas vezes em tarefas estreitas, ver a maior parte do que o teu agente pede a um LLM é um sim ou um não. Sobre o problema do tempo na formação em IA nas empresas, ver a formação em IA mais do que duplicou; 56% não têm tempo para a fazer.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.