Quase tudo o que o teu agente pede a um LLM é um sim ou um não

By Surya Pratap
21 de setembro de 2026
11 min read
AI & Technology

21 de setembro de 2026
11 min read
 Quatro decisões e uma fraseHover to explore
De vez em quando vale a pena ler um lançamento pela premissa e não pelos números. Este tem uma premissa que me parece certa e números que ninguém fora da empresa verificou, uma combinação pouco comum que convém separar com cuidado.
Este artigo parte de «Building a harness with Jev» da LangChain, de Sydney Runkle e Hunter Lovell, publicado a 17 de setembro de 2026; do anúncio da própria TypeSafe AI; de um guia prático da API; e da leitura cética da MindStudio. Todos os números de desempenho abaixo são da TypeSafe. A secção 7 diz o que isso significa. O argumento a partir da secção 2 é meu.
A TypeSafe AI lançou o Jev, a que chama um modelo System One: uma classe que define como modelos feitos para tomar decisões rápidas e estruturadas que o software consome diretamente, em vez de para gerar texto. A LangChain publicou um harness construído sobre ele na mesma semana.
A forma da coisa: entregas-lhe um estado e um conjunto de perguntas tipadas, e ele responde a todas de uma vez com probabilidades associadas. Três tipos de pergunta:
Choice — escolher uma entre até 255 opções, com uma probabilidade por opçãoScore — colocar a entrada numa escala ordenada de 2 a 10 níveisNoul — um sim ou um não, devolvido como um único número entre 0 e 1from typesafe_sdk import Choice, Noul, TypeSafeClient
client = TypeSafeClient()
response = client.system_one(
state={"ticket": "I was charged twice"},
questions={
"department": Choice(
instructions="Which team handles this",
criteria={"billing": "Payment issues", "technical": "Bugs"},
),
"urgent": Noul(instructions="Message conveys urgency"),
},
)
Duas diferenças de arquitetura fazem o trabalho. O modelo amostra todas as saídas numa única consulta e em paralelo em vez de autorregressivamente, e é daí que vem a afirmação sobre latência. E é treinado com aquilo a que a TypeSafe chama RLCD, aprendizagem por reforço para decisões calibradas, que não otimiza para uma resposta que um avaliador humano aprove, mas para uma resposta acompanhada de uma probabilidade que reflita com que frequência essa resposta está certa.
Os números publicados: 70–500 ms de ponta a ponta, 0,042 dólares por milhão de tokens de entrada com a saída grátis e, nas avaliações de fluxo da própria empresa, 193,6× mais rápido e 444,6× mais barato do que os modelos de fronteira com que comparou. O contexto está limitado a 64k tokens no total, 32k para o estado.
Tira o fabricante e olha para aquilo em que um turno de agente realmente consiste.
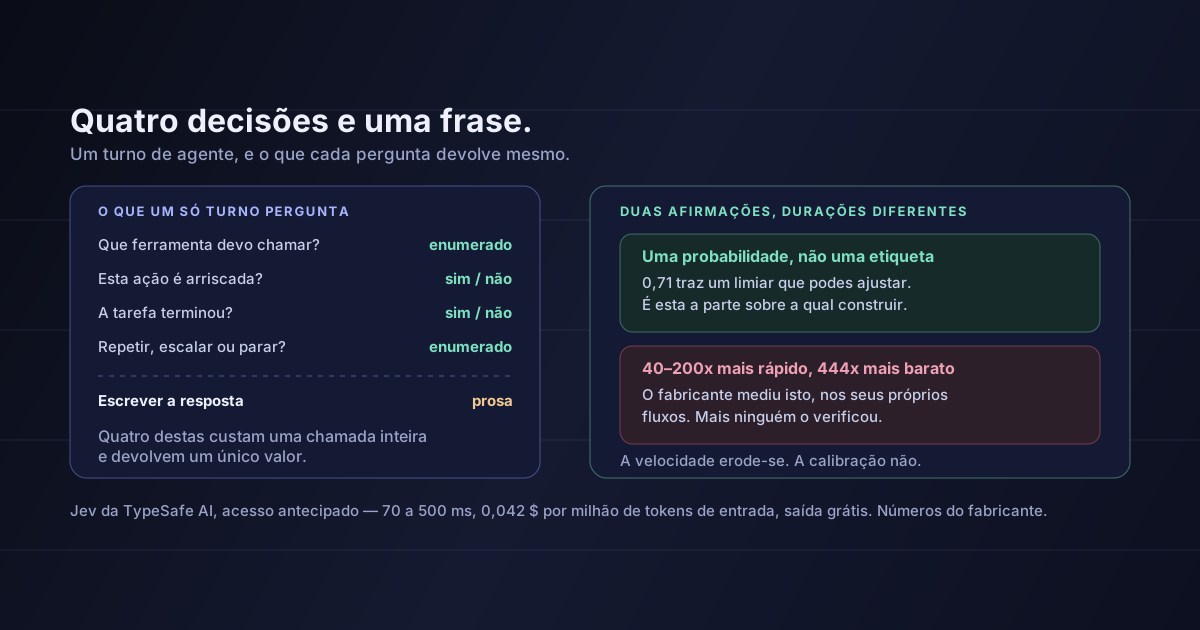
Que ferramenta devo chamar? Um enumerado. Uma de onze opções.
Esta ação é arriscada ao ponto de parar? Um sim ou um não.
A tarefa terminou? Um sim ou um não, feito a cada volta do ciclo.
Repetir, escalar ou desistir? Outro enumerado.
E depois, uma vez, no fim: escrever a resposta. Essa precisa mesmo de um modelo de linguagem, e nada disto o substitui.
A parte cara de um turno de agente raramente é a escrita. São as quarenta pequenas decisões que custam, cada uma, uma chamada completa ao modelo.
Cada uma dessas decisões passa hoje por um modelo feito para produzir frases, cobrado ao token, a gerar de forma autorregressiva, e depois é reduzida outra vez a uma só palavra quando se faz o parsing. Estás a pagar preço e latência de geração por trabalho cuja saída inteira cabe num byte.
Essa afirmação não custa nada a avaliar e não depende de nenhum dos números da TypeSafe estar certo. É o mesmo movimento que separar OLTP de analítica, ou uma cache de uma base de dados: dois padrões de acesso vestidos num só componente porque ninguém tinha ainda reparado que eram duas coisas.
As vantagens de velocidade e custo são erodidas pela concorrência. Daqui a dois trimestres haverá quatro destes e o preço será o do segundo mais barato. A calibração é a parte sobre a qual eu construiria de facto.
A diferença na prática é esta. Um LLM a quem se pergunta «isto é urgente?» devolve urgente. Um classificador calibrado devolve 0,71.
Uma etiqueta dá-te um ramo. Uma probabilidade dá-te um limiar, e um limiar é um botão:
Bloquear acima de 0,9, assinalar para revisão a partir de 0,6, registar abaixo disso. Uma pergunta, três comportamentos, sem chamadas extra ao modelo. Com uma etiqueta seca tens um comportamento e nenhuma forma de trocar precisão por abrangência.
É o controlo que defendi no artigo sobre os números de supervisão da Anthropic: decide quantos itens uma pessoa revê por semana e desloca o limiar até ser isso que chega. Essa aritmética não se faz com etiquetas.
Confiança baixa é precisamente o caso que devia escalar para um modelo mais lento e mais capaz. Quase todo o encaminhamento de hoje adivinha a complexidade a partir da entrada; uma pontuação calibrada mede a incerteza sobre a saída, que era o que querias saber.
A palavra importante é calibrada. Qualquer modelo emite um número se lho pedires, e a probabilidade softmax de um token não é uma afirmação sobre correção. Se a calibração do Jev se aguenta é exatamente o tipo de coisa que precisa de medição de terceiros — e não teve nenhuma.
A TypeSafe afirma que o Jev tem uma taxa garantida de 0% de erros de saída estruturada, apresentada como propriedade matemática da arquitetura e não como resultado de um teste. Lido à letra, e não tenho razão para duvidar, isso significa que o modelo não consegue devolver algo fora do esquema que declaraste.
A forma não é a correção
Uma garantia sobre o tipo é a garantia de que a resposta está bem formada, não de que está certa. Se perguntas qual das onze ferramentas chamar, vais sempre receber uma das onze — e pode ser a errada das onze, sempre, sem nenhum erro de parsing a avisar-te. Vale a pena ter isto claro, porque «nunca alucina» já circula como descrição deste modelo e significa algo bem mais estreito do que parece: nunca alucina uma forma. Nada na arquitetura impede uma classificação errada com toda a confiança.
Dito isto, eliminar saída malformada é um ganho operacional real, e quem já lançou um agente sabe porquê: o caminho de repetir depois de uma falha de parsing é onde vive uma quantidade surpreendente de latência, de custo e de comportamento estranho. Remover uma classe inteira de falha vale alguma coisa, mesmo não sendo a classe que mais te preocupa.
Antes de avaliar qualquer produto destes, descobre se a premissa descreve o teu sistema. É uma hora de trabalho e a resposta dura independentemente do fabricante que acabes por usar.
Instrumenta cada chamada ao modelo que o teu agente faz e classifica-a:
| Categoria | Teste | O que te diz |
|---|---|---|
| Decisão | A saída reduz-se a um enumerado, um booleano ou um número | Candidata a classificador |
| Extração | A saída é um esquema fixo e pequeno retirado de uma entrada maior | Candidata, se o esquema for estável |
| Geração | A saída é prosa que uma pessoa ou outro sistema vai ler | Fica num modelo de linguagem |
| Raciocínio | A saída é um plano de vários passos cujos passos intermédios importam | Fica, e provavelmente no teu melhor modelo |
Depois calcula dois números: a proporção de chamadas nas duas primeiras categorias e a proporção de gasto. Na maioria das stacks de agentes que vi, o primeiro número é alto e o segundo é mais baixo mas longe de proporcional — as decisões costumam ser prompts curtos, portanto são baratas à unidade e numerosas o suficiente para pesar no agregado, e dominam a latência porque estão no caminho crítico de cada volta.
O limiar que eu usaria:
Se decisões e extração ficarem abaixo de um terço das tuas chamadas, isto é uma otimização e deves ignorá-la até estar outra coisa resolvida. Se passarem de dois terços — o caso habitual em tudo o que tenha um ciclo de ferramentas — então a tua arquitetura já contém duas cargas de trabalho e estás a uma decisão de fornecedor de as poder separar.
O Jev está em acesso antecipado, por isso a pergunta prática é o que podes fazer agora. Três opções, por ordem crescente de esforço.
Junta as perguntas que já fazes. O ganho mais barato aqui nada tem a ver com modelos novos. Se o teu ciclo faz quatro chamadas separadas para decidir quatro coisas sobre o mesmo estado, faz as quatro numa só chamada com um esquema estruturado. Pagas o estado uma vez em vez de quatro.
Passa já as decisões fáceis para um modelo pequeno. «A tarefa terminou» não precisa do teu melhor modelo. Um modelo pequeno com descodificação restrita resolve a maioria das perguntas de porta, e podes medir a taxa de discordância com o teu modelo atual antes de trocar seja o que for.
Constrói o limiar antes de teres a probabilidade. Escreve a porta de dois níveis — bloquear acima, rever no meio, registar abaixo — mesmo com o nível do meio por preencher. Quando chegar uma pontuação calibrada, estarás a ligar um número em vez de redesenhar um fluxo de controlo.
Mantém o conjunto de avaliação independente do modelo. Se um dia quiseres mover uma decisão para um classificador, o que torna isso um trabalho de duas horas em vez de duas semanas é teres um conjunto etiquetado com as entradas dessa decisão e as respostas certas. A maioria das equipas tem isso para a tarefa de ponta a ponta e nada para as decisões individuais lá dentro.
Essa última é o verdadeiro pré-requisito. Não consegues mover uma decisão para um modelo mais barato com segurança sem uma forma de saber se piorou, e construir esse conjunto é trabalho que deves a ti próprio, entre ou não em cena um modelo System One.
Todos os números de desempenho aqui são autorreportados. Nenhuma parte independente testou o Jev. O modelo está atrás de uma lista de espera, as avaliações não são sobre testes públicos e os números de comparação vêm da empresa que vende o produto. Isso não os torna falsos; torna-os não verificados, e devem levar exatamente o desconto que aplicarias aos números caseiros de qualquer fabricante.
A TypeSafe publica os seus próprios limites metodológicos, e são reais. As avaliações de fluxo foram construídas pela sua equipa de capacidades de modelo, o que a empresa reconhece poder enviesá-las. A base de comparação é a média de dois modelos de fronteira. As demonstrações usaram consultas simplificadas com chaves legíveis. Crédito por publicar tudo isso; não deixa de importar.
«193,6× mais rápido, 444,6× mais barato» é um teto, não uma expectativa. A TypeSafe di-lo: espera que estes estejam no topo dos ganhos reais. Citar o número de manchete como aquilo que vais obter seria ler mal a ressalva da própria empresa.
Não o usei. Tudo o que está acima foi lido em material publicado. Recomendo a pergunta de arquitetura, não o produto.
As afirmações sobre calibração são as que eu mais gostaria de ver verificadas. É a parte com verdadeiro valor de engenharia e a mais difícil de verificar de fora, e uma curva de calibração que se aguenta nos fluxos do fabricante pode não se aguentar nos teus. Se fizeres um piloto, mede a calibração nos teus próprios dados antes de ligar um limiar a algo que importe.
O lançamento vai ser discutido pelos números, e essa discussão ainda não pode ser resolvida por ninguém fora da empresa.
A parte que não depende dos números é a decomposição. Um ciclo de agente é sobretudo um motor de decisão com um redator aparafusado no fim, e o setor passou dois anos a servir as duas metades do mesmo componente porque esse componente era o único disponível. Alguém havia de reparar. Que exista agora um fabricante, um método de treino e uma integração LangChain pendurados nessa observação é menos interessante do que a observação.
Instrumenta o teu agente e descobre que fração das suas chamadas ao modelo devolve algo que reduzes de imediato a um único valor. Se esse número for dois terços, já tens duas cargas de trabalho — e sempre ias ter de as separar, venda quem vender a segunda.
Fontes: LangChain, «Building a harness with Jev», de Sydney Runkle e Hunter Lovell, 17 de setembro de 2026 — o enquadramento do harness, os tipos de pergunta e os casos de encaminhamento e de barreira de segurança. TypeSafe AI, «Introducing System One Models & Jev» — a definição de System One, o amostrador paralelo, o RLCD, o intervalo de latência de 70–500 ms, os 0,042 dólares por milhão de tokens de entrada com saída grátis, os números de fluxo de 193,6× e 444,6×, a afirmação de zero erros de tipo e as ressalvas metodológicas citadas na secção 7, todas da TypeSafe. Um guia prático do Jev — a superfície do SDK, o teto de 255 opções em Choice e os limites de contexto de 64k no total e 32k de estado. MindStudio, «RLCD vs RLHF» — a ausência de qualquer verificação independente. O argumento da decomposição, a defesa da calibração em vez da velocidade, a distinção entre forma e correção e todas as recomendações são meus. Para a mecânica de custos sobre a qual isto assenta, vê cada ficheiro que o teu agente lê fica na fatura, e para o argumento do limiar vê os números de supervisão de agentes da Anthropic.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.