Só 13% sabem trabalhar com agentes de IA. E só 11% sabem em que nível estão

By Surya Pratap
17 de setembro de 2026
10 min read
AI & Technology

17 de setembro de 2026
10 min read
 A competência que ninguém vê em si próprioHover to explore
Quase tudo o que se escreve sobre a lacuna de competências em IA discute se ela existe. Um benchmark publicado este ano faz algo mais útil: mede-a, ordena-a e depois, quase de passagem, revela a conclusão que explica porque tanto dinheiro de formação produz tão pouco.
Os números deste artigo vêm do 2026 AI Skills Enterprise Benchmark Report da Workera e do estudo de julho de 2026 da The Conference Board sobre formação em IA. Ambos são resumidos tal como publicados; a leitura que faço deles, e tudo na secção 6, é minha.
A Workera analisou 88 753 avaliações a 32 422 pessoas, em serviços profissionais, farmacêutica e saúde, serviços financeiros, bens de grande consumo e a administração federal dos Estados Unidos. Cada pessoa foi pontuada numa escala de 300 pontos em 14 competências de IA e dados, onde 201–300 conta como nível alto.
Essa dimensão de amostra importa porque muda o tipo de afirmação em causa. Um inquérito pergunta às pessoas o que acham. Uma avaliação descobre.
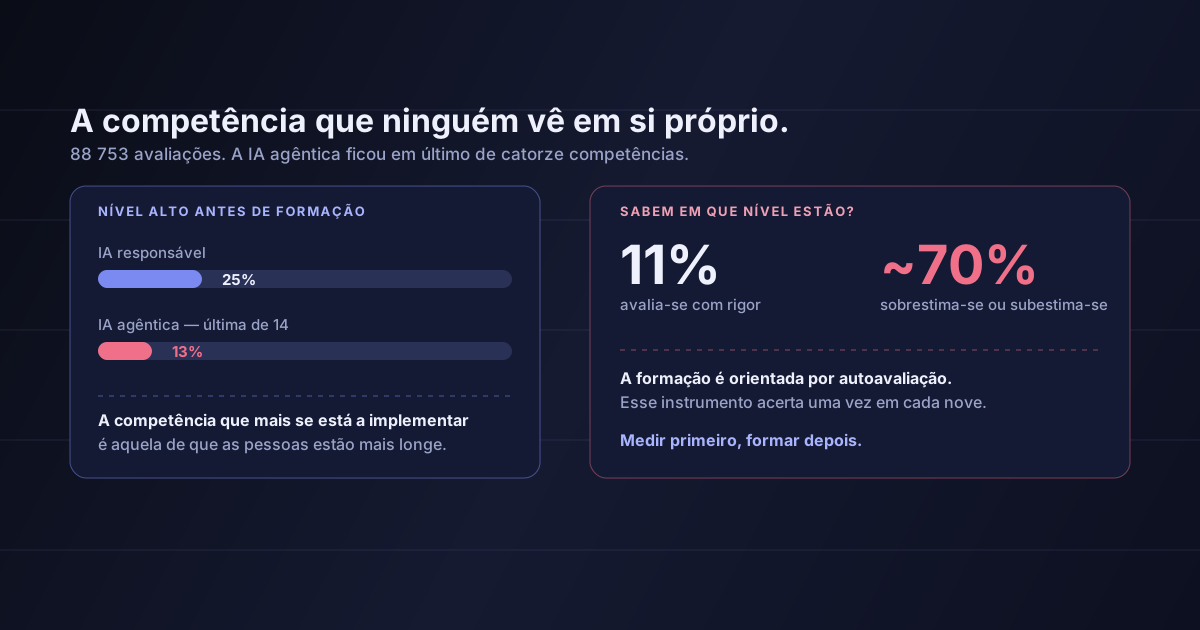
O título: 13% dos colaboradores tinham nível alto em competências de IA agêntica antes de qualquer formação — o mais baixo das catorze competências medidas.
A capacidade que as empresas estão a implementar com mais força é justamente aquela de que as suas pessoas estão mais longe.
A IA agêntica não pontuou baixo por ser nova e irrelevante. Pontuou baixo sendo aquilo para onde apontam, em 2026, todos os roteiros de fornecedores, todas as apresentações ao conselho e todos os ciclos de compra. A competência mais escassa é exatamente a que está a ser comprada.
O número que devia mesmo mudar em que gasta está mais abaixo.
Só 11% dos colaboradores avaliaram com rigor o seu próprio nível. Perto de 70% sobrestimaram-se ou subestimaram-se.
Pare um momento nisto, porque quase todos os programas de formação existentes são orientados exatamente pelo instrumento que acabou de falhar. Inquéritos de competências, inscrição voluntária em cursos, formulários de "classifique a sua confiança de 1 a 5", chefias a perguntar quem precisa de ajuda: todos leem um sinal errado cerca de sete vezes em cada dez.
Falha nos dois sentidos, e cada falha custa de forma diferente:
Quem se julga competente não se inscreve, não pergunta e entrega trabalho que ninguém revê de perto. Esta é a direção cara. Um engenheiro convencido de que percebe recuperação de informação vai construir um pipeline que brilha na demonstração e se degrada em silêncio.
Pessoas capazes afastam-se de trabalho que conseguiriam fazer, e a organização contrata ou externaliza capacidade que já tem. Sai mais barato, mas distorce o plano.
Porque isto se agrava precisamente com os agentes
Os sistemas agênticos falham em silêncio. Um modelo que erra numa janela de conversa erra à vista. Um agente que erra executa uma ação, e o custo aparece depois, num pedido de suporte ou numa reconciliação. A distância entre "sei usar isto" e "sei quando isto está a falhar" é exatamente a que a autoavaliação não vê — e com agentes essa distância torna-se operacional.
A The Conference Board inquiriu perto de 1 300 trabalhadores e entrevistou 35 dirigentes em julho de 2026. Os números relevantes:
Coloque os dois estudos lado a lado e a posição é inequívoca. A maioria usa estes sistemas todas as semanas. Um terço teve formação recente. Cerca de um em cada oito está avaliado em nível alto na parte agêntica. E ninguém — eles próprios incluídos — consegue dizer com fiabilidade quem é quem.
A consequência prática:
O uso diário não é capacidade, nem é prova de capacidade. É exposição. Exposição sem avaliação é como uma organização acaba confiante e errada ao mesmo tempo.
Seria fácil ler tudo isto como um argumento de que a formação não compensa. O benchmark diz o contrário, e em concreto.
Após requalificação dirigida, 81% dos colaboradores atingiram nível alto em IA responsável, face a 25% no início. Outras competências também se moveram bastante: 72% de melhoria média em visualização e narrativa de dados, 53% em fundamentos de IA generativa, 47% em fundamentos de IA.
São movimentos grandes. A variável não é se há formação — a Conference Board diz que um terço teve alguma este ano — mas se ela apontou a uma falha medida em vez de a uma falha sentida.
Um programa que começa por uma avaliação resolve um problema diferente de um programa que começa por uma folha de inscrições. O primeiro sabe o que está a fechar. O segundo adivinha, com um instrumento que o mesmo relatório mostra ser pouco fiável.
Se vai especificar formação empresarial em IA no próximo trimestre, as conclusões traduzem-se numa lista curta de exigências.
Não defina o âmbito só com um inquérito de competências. O autorrelato foi precisamente o que falhou. Use amostras de trabalho, uma avaliação curta, ou a revisão de algo que a equipa entregou mesmo.
Especifique o trabalho, não os temas. "A nossa equipa não deteta quando uma resposta recuperada está errada" é um enunciado. "Introdução aos LLM" é uma linha de catálogo.
Pergunte como o programa trata quem se julga competente. Quem se sobrestima é quem mais provavelmente desliga e quem sai mais caro deixar por rever.
Exija um artefacto. Algo que o participante fez e que possa ser visto depois. É o único sinal de capacidade que não depende da autoavaliação de ninguém.
E uma pergunta que vale a pena fazer a qualquer fornecedor, nós incluídos: como seria este programa se estivesse errado sobre o nível de partida da nossa equipa? Um programa com resposta pensou na avaliação. Um programa sem resposta vende um programa de temas.
Onde a IdeaToMVP Academy se posiciona em cada um destes pontos:
Os nossos programas empresariais estão separados por público em vez de vendidos como um curso único, porque uma equipa financeira e uma equipa de engenharia não têm a mesma falha e não devem ser medidas pela mesma bitola. Cada percurso publica os seus pré-requisitos, os seus objetivos de aprendizagem e o resultado com que o participante sai.
Dois limites honestos. Não aplicamos uma avaliação psicométrica normalizada como a da Workera — se quiser uma pontuação comparada em catorze competências, isso é outro produto e dizemo-lo. E uma turma não resolve um problema de estratégia: se ninguém decidiu para que serve a IA na sua organização, um curso não o decide por si.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.
O benchmark não é nosso, e a sua população não é a sua. A amostra da Workera pende para grandes empresas e para a administração federal norte-americana. Uma startup de doze pessoas não é essa população, e as percentagens devem ler-se como direção e não como a pontuação provável da sua equipa.
Os números de melhoria vêm de pessoas que foram avaliadas e depois formadas. É um grupo selecionado, e os 81% em IA responsável são uma medição posterior à intervenção, não uma promessa associada a qualquer programa em concreto, o nosso incluído.
Correlação, como sempre. Que os nossos currículos estejam desenhados face a estas conclusões é uma opção de desenho. Não é prova de que rendam mais, e os nossos próprios dados de resultados são escassos porque os trabalhos que podemos citar são recentes.
A lacuna de competências em IA em 2026 não é sobretudo uma lacuna de oferta. É uma lacuna de visão: a capacidade medida mais escassa é justamente a que as organizações implementam com mais força, e o instrumento que quase toda a gente usa para apontar a sua formação — perguntar às pessoas como se estão a sair — acerta em cerca de um caso em nove.
O uso diário não é capacidade. A confiança não é capacidade. A única coisa que se comporta como capacidade é algo que uma pessoa fez e que outra pode inspecionar.
Se mudar uma só coisa na forma como compra formação em IA este trimestre, deixe de definir o âmbito a partir de um inquérito de autoavaliação e comece a defini-lo a partir do trabalho que a sua equipa produziu de facto.
Fontes: Workera, 2026 AI Skills Enterprise Benchmark Report — 88 753 avaliações a 32 422 pessoas, pontuadas de 1 a 300 com 201–300 como nível alto, em 14 competências; todos os números do benchmark e pós-formação são os aí publicados. The Conference Board, estudo sobre formação em IA, 28 de julho de 2026 — perto de 1 300 trabalhadores inquiridos mais entrevistas a 35 dirigentes; os números de utilização, participação em formação e recursos são os aí publicados. Os detalhes dos programas da Academy são nossos e vigoram à data de publicação. Para a versão deste problema do lado da oferta, veja 82% das empresas dão formação em IA e 59% continuam a reportar lacuna de competências, e para a lacuna de perceção entre quem compra e quem participa, 47% dos colaboradores acham que a formação em IA existe para automatizar o seu posto.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.