
Dois harnesses de agentes lançados em 48 horas — e fazem apostas opostas (2026)

By Surya Pratap
7 de agosto de 2026
11 min read
AI & Technology

7 de agosto de 2026
11 min read
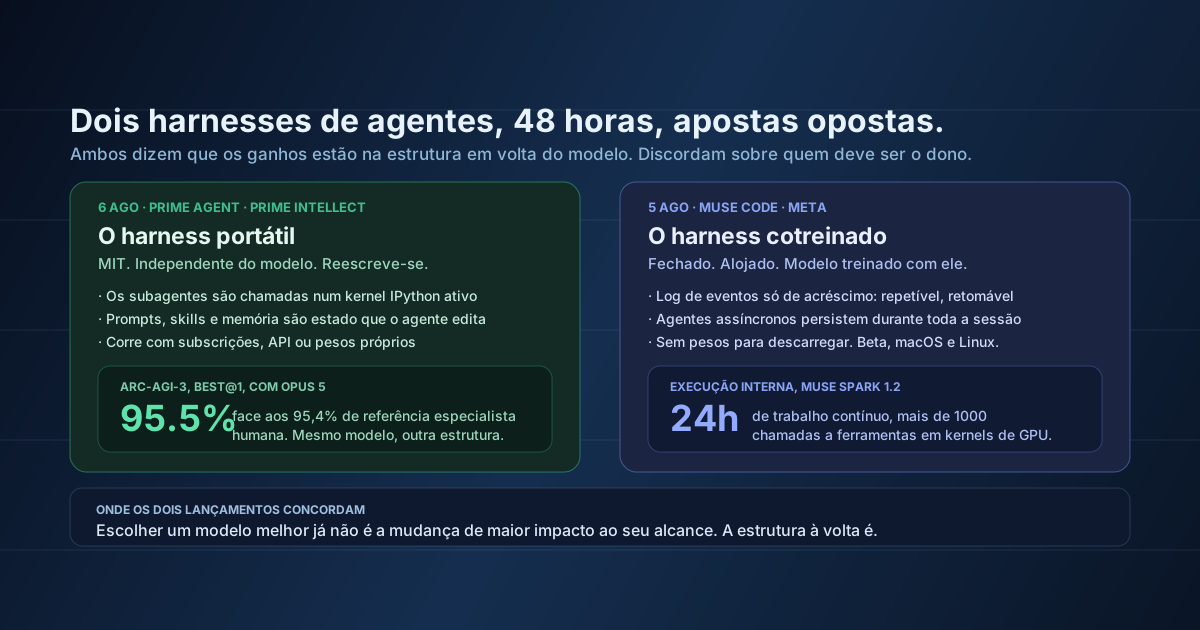
A 5 de agosto, a Meta lançou o Muse Code — um agente de programação para terminal que corre no Muse Spark 1.2, um modelo que treinou juntamente com o próprio agente. A 6 de agosto, a Prime Intellect abriu o código do Prime Agent com licença MIT, um harness pensado para correr qualquer modelo para onde o aponte, que obteve 95,5% no ARC-AGI-3 com o Opus 5 por trás.
Nenhum dos lançamentos é, no fundo, sobre um modelo. Ambos são sobre a estrutura que o envolve: como se gere o contexto, como se lançam os subagentes, o que sobrevive a uma falha, o que o agente pode mudar em si próprio a meio de uma tarefa. É uma mudança que merece ser nomeada. Durante dois anos, os lançamentos interessantes eram checkpoints, e a pergunta do fundador era para que modelo encaminhar. Estes dois dizem que o modelo já não é onde estão os ganhos que faltam.
O que torna o par verdadeiramente útil é que concordam na premissa e discordam por completo na conclusão. Um diz que o harness é portátil e deve ser seu. O outro diz que o harness só funciona quando o modelo foi treinado dentro dele, por isso deve ser do laboratório. Vai ter de escolher um lado, por isso vale a pena perceber o argumento.
O Prime Agent assenta em duas ideias, e ambas são invulgares o suficiente para valer a pena expô-las com clareza.
A primeira é o Recursive Language Model. Em vez de o contexto ser uma janela que enche e é truncada, o contexto é uma variável dentro de um kernel IPython persistente. O modelo escreve código que opera sobre o seu próprio histórico — pesquisando-o, cortando-o, resumindo partes — em vez de receber um prompt já montado. Delegar num subagente não é uma camada especial de orquestração; é uma chamada de função nesse mesmo REPL. Se alguma vez escreveu um nó supervisor no LangGraph, é o mesmo problema resolvido um nível abaixo: o agente programa a sua própria delegação em vez de ser o leitor a ligá-la.
A segunda é o Continual Harness. Prompts, skills, memória e definições de subagentes são tratados como estado que o agente pode criar, ler, atualizar e apagar a partir da sua própria execução. O comando /refine analisa a trajetória até ao momento e propõe alterações precisas a esse estado — planeadas em segundo plano para não bloquear, aplicadas entre turnos, apoiadas em evidências e reversíveis através de um histórico de rollback. O agente, num sentido limitado e auditado, está a reescrever a sua própria estrutura enquanto trabalha.
O número de destaque: 95,5% de RHAE Best@1 no ARC-AGI-3 com o Opus 5, face à referência de especialista humano de 95,4% indicada pelo ARC. As execuções deram 95,0, 95,2 e 95,5, por isso o resultado é estável e não uma amostra com sorte. O Best@3 chega aos 99,97%, com todos os 183 de 183 níveis concluídos. A Prime Intellect indica também melhor eficiência de tokens do que os harnesses nativos dos modelos, o que importa mais do que a pontuação.
No entanto, a afirmação que lhe deve chamar a atenção não é o número do ARC. É a comparação por baixo: o Prime Agent a correr o GLM-5.2 foi competitivo com o Claude Code a correr o Opus 5 e com o Codex a correr o GPT-5.6 Sol, ou melhor do que eles, num conjunto de benchmarks de contexto longo — OOLONG, OOLONG-Pairs, OBLIQ-Bench, LongBenchPro e ManyIH. Se isso se confirmar de forma independente, significa que um modelo aberto de gama média num harness melhor consegue igualar um modelo de fronteira no harness que o seu próprio laboratório construiu. É uma afirmação muito maior do que um recorde num benchmark.
As demos, para calibrar
O Prime Agent produziu emuladores funcionais em Rust da SEGA Genesis e da Game Boy Color sem código de referência, e chegou a uma pontuação de produção acima de 100 000 no Factorio em poucas horas. Leia-os como deve ler qualquer demo de lançamento — como prova de que o sistema consegue sustentar trabalho coerente muito longo, não como prova sobre a sua base de código. Os emuladores e os jogos de fábricas têm algo que o seu produto não tem: um sinal rápido, inequívoco e automático de que a última alteração estava correta.
O lançamento da Meta é menos novo do ponto de vista conceptual e bastante mais sério do ponto de vista operacional. O Muse Code é um agente de terminal em beta para macOS e Linux, instalado com um único comando, que corre o Muse Spark 1.2 através do Muse Code ou da Meta Model API. Não há pesos para descarregar.
Há três decisões de desenho que vale a pena copiar, quer o venha a correr quer não.
O log de eventos só de acréscimo. Cada chamada ao modelo, execução de ferramenta, aprovação e edição é acrescentada a um log local, o que torna o runtime repetível com exatidão e seguro para reiniciar. Quando o agente falha aos quarenta minutos de uma tarefa, retoma onde parou em vez de começar do zero. É a propriedade mais subestimada do lançamento. Quem já correu sessões longas de agentes em produção sabe que a falha que dói não é uma resposta errada — é perder trinta minutos de estado acumulado por causa de um timeout, sem forma de reconstituir o que o agente pensava no momento em que se enganou.
Agentes persistentes em segundo plano. Em vez de lançar um subagente novo por tarefa, o Muse Code mantém vivo um conjunto de agentes assíncronos em segundo plano durante toda a sessão. A razão apresentada é evitar recolher informação de forma redundante — o segundo subagente não volta a ler o repositório que o primeiro acabou de ler. Se a sua orquestração lança um agente limpo por passo, está a pagar essa portagem de redescoberta em cada passo, e ela acumula.
Planeamento com aprovação como skill predefinida. O Muse Code inclui /plan para transformar uma tarefa num plano que aprova antes da execução, /grill para pôr esse plano à prova até aguentar, e /goal para o levar até ao fim. Fazer uma passagem adversarial sobre o plano antes de escrever qualquer código é uma intervenção barata que a maioria das equipas salta.
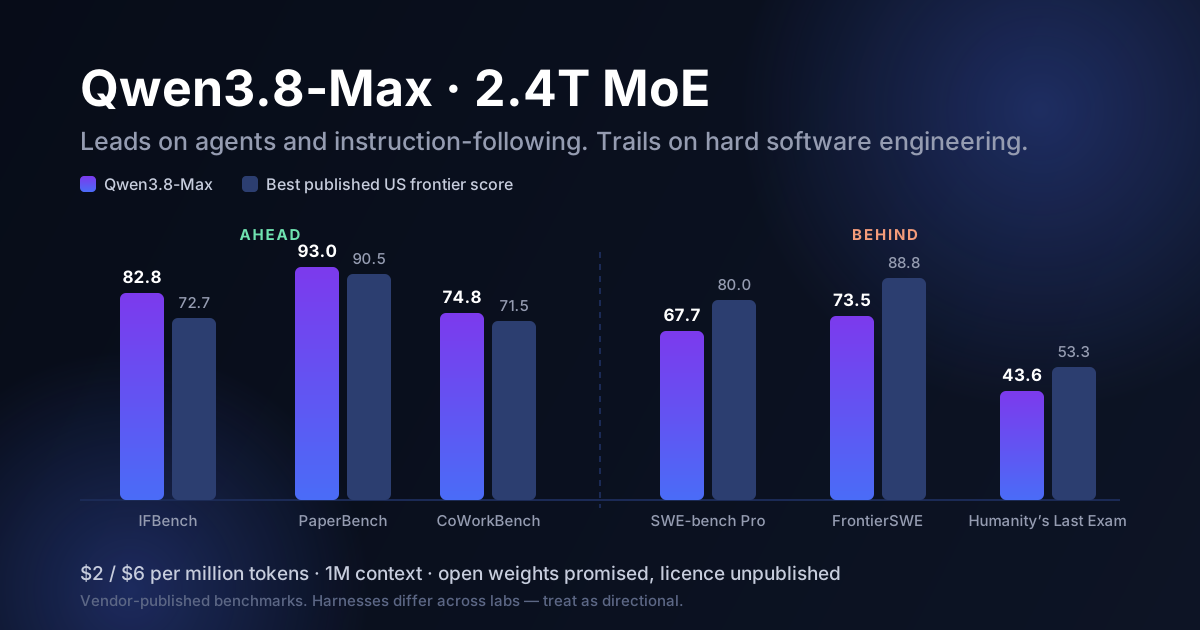
A Meta avaliou no Terminal-Bench 2.1 (89 tarefas, pass@1 em cinco tentativas), no DeepSWE v1.1 (113 tarefas em 91 repositórios e cinco linguagens) e num benchmark interno de 440 tarefas tiradas de pull requests reais, em comparação com o Grok 4.5, o Claude Opus 5, o GPT-5.6 Terra, o Gemini 3.6 Flash e o Kimi K3. Não consegui verificar os números publicados do Muse Spark 1.2 numa fonte primária — estão em imagens de gráficos no post da Meta —, por isso não os vou citar. Para referência: o Muse Spark 1.1 obteve 80,0 no Terminal-Bench 2.1, e o Qwen3.8-Max indicou 86,6 no mesmo benchmark na semana passada. A afirmação mais fácil de avaliar é a execução interna em que o modelo otimizou kernels de GPU ao longo de mais de 1000 chamadas a ferramentas e até 24 horas de trabalho contínuo. Uma duração a essa escala é uma propriedade do harness, não do modelo.
Esta é a parte que torna o par interessante e não apenas movimentado.
A Prime Intellect é invulgarmente franca sobre a sua própria limitação. O seu texto refere atrito ao correr o Prime Agent com vários modelos, e diz claramente que nenhum modelo foi treinado em torno do Prime Agent ou do seu conjunto de funcionalidades principal. Os 95,5% vêm de um modelo de fronteira a fazer algo para que nunca foi especificamente treinado, dentro de um harness que nunca viu. A empresa trata o atrito restante como a distância entre onde está e onde a abordagem poderia chegar.
A Meta fechou exatamente essa distância, na direção contrária. O Muse Spark 1.2 foi treinado juntamente com a ferramenta. O modelo e o harness foram desenvolvidos como um único artefacto, e é por isso que a Meta pode prometer sessões de 24 horas e recuperação com repetição exata — o modelo foi moldado para se comportar bem dentro desse runtime específico.
Ambas as partes concordam, portanto, no ponto técnico de fundo: o modelo e o harness estão acoplados, e o desempenho está nesse acoplamento. Discordam sobre quem fica com o acoplamento. A aposta da Prime Intellect é que um harness aberto, portátil e automodificável acumula melhorias mais depressa do que qualquer laboratório sozinho, e que os modelos acabarão por ser treinados para harnesses como o seu. A aposta da Meta é que o cotreino é um fosso, e que o melhor agente será sempre aquele cujo modelo cresceu lá dentro.
Porque é que isto lhe importa a si em concreto
Se a aposta portátil ganhar, a estrutura dos seus agentes é um ativo duradouro e trocar de modelo continua barato — é no seu harness que deve investir. Se a aposta cotreinada ganhar, a sua estrutura é uma ponte temporária para o laboratório que estiver à frente em cada momento, e é na capacidade de migrar que deve investir. As duas levam a decisões de engenharia diferentes já este trimestre, e é por isso que vale a pena ter uma opinião em vez de esperar pela resposta.
Quatro ressalvas, porque o número vai ser muito citado esta semana sem elas.
A maioria das equipas que leem isto não deve mudar de harness esta semana. Mas quase todas devem copiar de ambos.
/grill — gerar um plano e atacá-lo antes de o executar — apanha o tipo de falha em que o agente dá quarenta passos corretos rumo a um objetivo errado. Rever o diff no fim não consegue apanhá-lo.Na semana passada escrevi que as lacunas do Qwen3.8-Max nos benchmarks não estavam na inteligência bruta — 92,6 no GPQA Diamond é nível de fronteira —, mas no trabalho agêntico de longo horizonte, em que um modelo tem de manter um plano ao longo de quarenta passos e recuperar dos seus próprios erros. Esta semana, dois laboratórios lançaram produtos que atacam precisamente essa lacuna, e nenhum o fez tornando o modelo mais inteligente.
É esse o padrão a reter. A distância que falta entre uma demo impressionante e um sistema que aguenta uma carga de trabalho real está a ser fechada com engenharia: estado duradouro, capacidade de retomar, gestão de contexto, delegação que não perde o que aprendeu, um plano com que alguém discutiu antes da execução. Nada disso chega num checkpoint. Tudo pode ser construído por uma equipa competente, o que significa que está ao seu alcance, e que a vantagem não expira quando sai o próximo modelo.
A implicação incómoda é que, se o seu agente está aquém do esperado, o modelo provavelmente não é o seu problema. Trocar de checkpoint é a experiência mais fácil e, por isso, a que a maioria das equipas faz primeiro. Raramente é a que mexe no número. Construa o log, corrija a delegação, discuta com o plano — e só depois vá às compras de modelos.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.