
Qwen3.8-Max: a Alibaba abriu um modelo de 2,4T e deu-lhe preço de modelo fechado (2026)

By Surya Pratap
6 de agosto de 2026
12 min read
AI & Technology

6 de agosto de 2026
12 min read
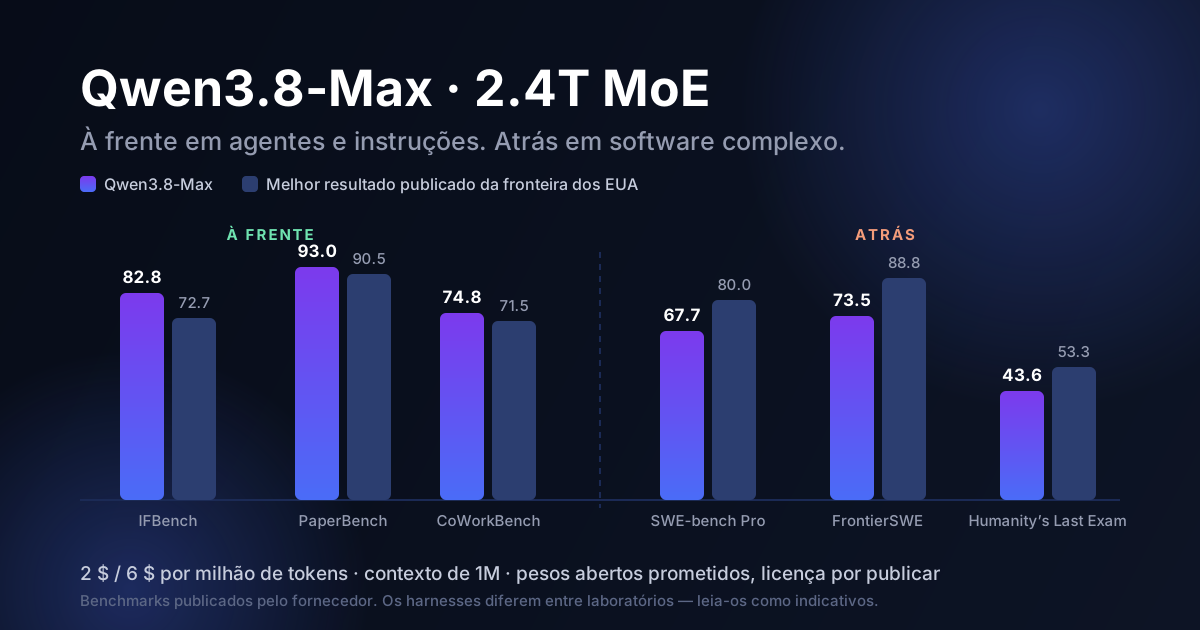
A 3 de agosto, a Alibaba lançou o Qwen3.8-Max: 2,4 biliões de parâmetros no total, 95 mil milhões ativos por token, uma janela de contexto de um milhão de tokens, e texto, imagem e vídeo como entrada. É o maior modelo alguma vez lançado pela equipa Qwen, e é o primeiro Qwen da classe Max que a Alibaba disse que vai abrir.
Há dois pormenores mais interessantes do que o número de parâmetros. O primeiro é o preço: 2 dólares por milhão de tokens de entrada, 6 dólares por milhão de saída. Isso não é um desconto. É mais ou menos o que cobram os laboratórios fechados dos EUA, vindo de uma empresa cujo argumento competitivo durante dois anos foi cortar-lhes o preço. O segundo é que, no momento em que escrevo, os pesos não estão no Hugging Face e nenhum texto de licença foi publicado — o anúncio dizia «na próxima semana».
Ambas as coisas dizem mais sobre o que fazer a seguir do que a tabela de benchmarks. Eis a leitura honesta.
O Qwen3.8-Max é um modelo esparso de mistura de especialistas: 2,4T no total, cerca de 95 mil milhões ativados por token, e é por isso que pode ser servido a um preço que nada tem a ver com o seu tamanho. A janela de contexto é de 1M de tokens — 991 000 de entrada no máximo, que descem para 983 000 com o raciocínio ligado, 131 000 de saída no máximo, e um orçamento de raciocínio que pode chegar aos 262 000 tokens. As entradas são texto, imagem e vídeo; a saída é só texto.
A API está disponível de imediato através do Alibaba Cloud Model Studio e do QwenCloud, em formatos compatíveis com a OpenAI e com o DashScope, e também com o protocolo da Anthropic. Os limites publicados são generosos: 2M de tokens por minuto, 15 000 pedidos por minuto. Chamadas de funções, saídas estruturadas, processamento em lote, preenchimento de prefixos e fine-tuning são todos suportados, a par de cinco ferramentas integradas — interpretador de código, pesquisa web, extrator web, e pesquisa de imagem para imagem e de texto para imagem.
É na cache que o preço fica interessante. As leituras de cache implícita custam 0,25 dólares por milhão de tokens, um oitavo do preço sem cache. A criação de cache explícita custa 2,50 dólares, com leituras a 0,17. Para um agente que repete um prefixo grande e estável a cada turno, essa é a linha da fatura que decide se um fluxo de trabalho é comportável.
Foi anunciado ao mesmo tempo um segundo checkpoint, o Qwen3.8-27B, também com pesos abertos previstos. Ainda não tem ficha técnica, nem tabela de benchmarks, nem preço. Guarde isto: para a maioria de quem está a ler, o 27B é o lançamento que importa, e é aquele sobre o qual menos sabemos.
A Alibaba publicou um conjunto amplo de comparações. Leia-o como duas histórias diferentes, porque é isso que é.
| Benchmark | Qwen3.8-Max | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| IFBench (seguimento de instruções) | 82,8 | 72,7 | 63,5 |
| PaperBench | 93,0 | 90,5 | — |
| CoWorkBench | 74,8 | 71,5 | — |
| WorkSpaceBench | 67,7 | 65,6 | — |
| GPQA Diamond | 92,6 | — | — |
| OmniDocBench 1.5 | 92,1 | — | — |
| Terminal-Bench 2.1 | 86,6 | 88,8 | — |
| SWE-bench Pro | 67,7 | — | 80,0 |
| DeepSWE 1.1 | 56,6 | — | 70,0 |
| FrontierSWE | 73,5 | — | 88,8 |
| Humanity's Last Exam | 43,6 | 47,2 | 53,3 |
| MRCR v2 (contexto longo) | 92,9 | 93,8 | — |
O padrão é claro o suficiente para encaminhar com base nele. O Qwen3.8-Max lidera em seguimento de instruções, compreensão de documentos, recuperação em contexto longo e trabalho agêntico de escritório bem delimitado. Fica atrás, por dois dígitos, em engenharia de software difícil e raciocínio aberto — 12 pontos abaixo no SWE-bench Pro, 15 no FrontierSWE, 13 no DeepSWE, 10 no Humanity's Last Exam.
O IFBench merece um segundo olhar, porque é o número mais subestimado da tabela e o que mais diretamente toca a fiabilidade em produção. 82,8 face a 72,7 e 63,5 não é uma vantagem marginal. O seguimento de instruções é o que decide se o seu esquema JSON volta válido, se o modelo para quando lhe dizem para parar, se a chamada a ferramenta tem a forma que o seu harness espera. Dez pontos de vantagem aí veem-se na sua taxa de erro antes de se verem em qualquer demo de capacidades.
Os resultados vistosos são vistosos. Num benchmark de comércio eletrónico simulado de 365 dias, o modelo terminou com 416 252 ¥, cerca de 38% acima do GLM 5.2 e mais do dobro do que o Qwen3.7-Max conseguiu. Numa tarefa de desenho de chips, reduziu um acelerador criptográfico de 8298 portas lógicas para 678, uma redução de 81% da área de silício. Tome-os como demonstrações de capacidade, não como evidência sobre a sua carga de trabalho.
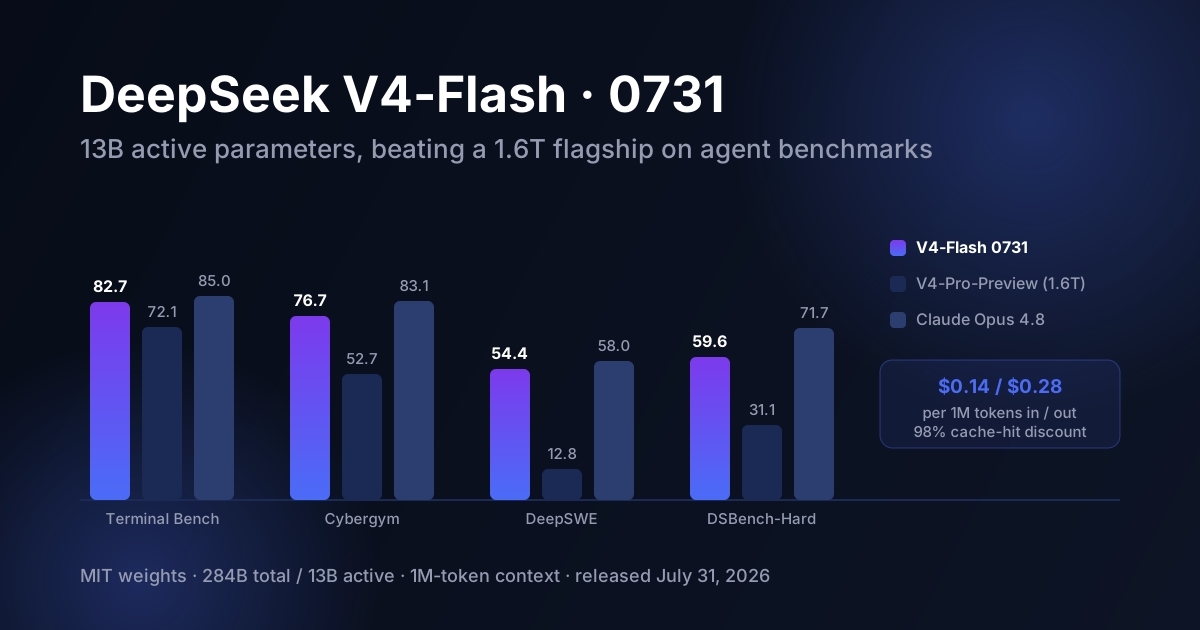
Ponha o Qwen3.8-Max ao lado do que saiu da China três dias antes. O V4-Flash da DeepSeek custa 0,14 dólares de entrada e 0,28 de saída. O Qwen3.8-Max custa 2 e 6 dólares — catorze e vinte e uma vezes mais caro, vindo do mesmo ecossistema em sentido lato, na mesma semana.
É um movimento de posicionamento deliberado, e marca uma mudança. Durante dois anos, os laboratórios chineses competiram por serem drasticamente mais baratos do que a fronteira. A Alibaba acabou de recusar fazê-lo. Pôs o preço ao nível dos modelos fechados dos EUA e deixou a tabela de benchmarks defender o argumento. A aposta é que as empresas que escolhem uma plataforma de agentes se importam mais com o modelo concluir a tarefa do que com ele custar um quinto.
O que isto significa para o seu modelo de custos
Se partia do princípio de que «a opção chinesa de pesos abertos é sempre o nível barato», esse pressuposto deixou de ser fiável. Há agora modelos de pesos abertos nos dois extremos da curva de preços, e o rótulo não lhe diz nada sobre a fatura. Ponha preço a este modelo específico face ao seu tráfego específico. O único dado independente que vale a pena citar aqui: o Vals Index mediu o Qwen3.8-Max empatado com o Claude Opus 4.7, 66,1 contra 66,1 — com um custo por teste cerca de 2,3× mais baixo. É uma vantagem real de eficiência face à fronteira fechada e, ao mesmo tempo, muito longe da economia da DeepSeek.
Esta é a parte que a maior parte da cobertura despacha. Há três coisas verdadeiras ao mesmo tempo, e precisa das três.
Uma: os pesos não saíram. A Alibaba prometeu-os para «a próxima semana» no Hugging Face e no ModelScope. A 6 de agosto, nada foi publicado para nenhum dos checkpoints, e não foi dada nenhuma data. Um lançamento prometido é um item de roadmap, não um ativo com que possa planear. Os precedentes apontam nos dois sentidos — o Qwen3.6-35B-A3B e o Qwen 4 Coder saíram com Apache 2.0 desde o primeiro dia, mas o Qwen3.6-Plus, o Qwen3.7-Max e o Qwen3.7-Plus ficaram todos fechados e só por API. Este lançamento inverte esse segundo padrão, e as inversões merecem confirmação antes de se construir em cima delas.
Duas: não foi publicado nenhum texto de licença. Profissionais que analisaram o anúncio assinalaram aparentes proibições geográficas que abrangeriam os EUA, a UE, o Reino Unido e a Coreia, e a Alibaba não esclareceu. Enquanto o ficheiro de licença não existir, não sabe se está a receber Apache 2.0, uma licença comunitária restritiva, ou algo com cláusulas territoriais que o tornem inutilizável para os seus clientes. Um modelo de 2,4T sob uma licença comunitária restritiva continua a ser tecnicamente de «pesos abertos», mudando por completo aquilo que pode lançar.
Três: com 2,4 biliões de parâmetros, «pode descarregá-lo» quase não significa nada para uma startup. Servir este modelo exige no mínimo oito GPU da classe H100 ou B200. Isso não é um portátil, nem uma estação de trabalho, nem uma instância de cloud que se arranca para experimentar algo. Para a esmagadora maioria das equipas, os pesos abertos não mudam nada do ponto de vista operacional: vai usar a API, exatamente como com um modelo fechado. O que os pesos compram de facto é opcionalidade para grandes empresas com requisitos de residência de dados, e uma base para o trabalho de destilação e fine-tuning que vai produzir os modelos que acabará por correr.
É por isso que o checkpoint interessante é o 27B. É o que corre em hardware que uma startup tem, o que pode ser afinado na sua base de código, o que pode fazer diferença nas suas margens. E neste momento não tem qualquer especificação publicada. Se o Qwen3.8 vier a importar para o seu negócio, será provavelmente através desse modelo — por isso esteja atento à ficha do 27B, não à manchete do Max.
reasoning_effort — sem aviso e sem efeito. Se o seu harness envia pedidos no formato da OpenAI, pode não estar a configurar nada enquanto julga ter configurado algo. Verifique que o comportamento muda quando muda o parâmetro; não confie na ausência de erro.Dada a forma das evidências, eis o que eu faria de facto.
A tentação com um lançamento desta dimensão é lê-lo como uma atualização do marcador. É mais útil como leitura de para onde se deslocou a concorrência.
Durante dois anos, os laboratórios chineses competiram no preço, e a pergunta estratégica para os fundadores era até onde desceria o chão. A Alibaba acabou de recusar esse jogo com o seu modelo de topo. Pôs o preço ao nível dos rivais, abriu os pesos de um modelo que quase ninguém consegue alojar por conta própria, e apontou todo o lançamento às cargas de agentes empresariais — tarefas de escritório, processamento de documentos, trabalho com contexto longo, cumprimento de instruções. A DeepSeek continua a empurrar o chão para baixo; a Alibaba está a competir pelo teto. São guerras diferentes, e agora travam-se em simultâneo.
Na prática, isso significa que a camada de modelos continua a ganhar capacidade em todos os escalões de preço e a diferenciar cada vez menos. O Qwen3.8-Max vai ser ultrapassado dentro de um trimestre, provavelmente por algo da mesma família. A decisão de encaminhamento que tomar esta semana estará errada dentro de dois. Isso não é razão para ignorar lançamentos — é razão para construir de forma a que responder-lhes seja barato: um gateway em vez de um SDK fixo no código, um conjunto de avaliação em vez de uma impressão, prompts organizados para reutilizar a cache em vez de montados ao sabor do momento.
E vale a pena reparar no que a divisão dos benchmarks diz sobre isso. As lacunas não estão na inteligência bruta — 92,6 no GPQA Diamond é nível de fronteira. As lacunas estão no trabalho agêntico de software de longo horizonte, as tarefas em que o modelo tem de manter um plano ao longo de quarenta passos e recuperar dos seus próprios erros. É a mesma lacuna que os fundadores encontram um nível acima no stack, quando a demo funciona e a produção não. Seja qual for o modelo para onde encaminha, esse continua a ser o trabalho que é seu.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.