O DeepSeek V4-Flash saiu oficialmente e bateu o seu próprio modelo de topo: guia para fundadores (2026)

By Surya Pratap
4 de agosto de 2026
13 min read
AI & Technology

4 de agosto de 2026
13 min read
A 31 de julho, a DeepSeek tirou o V4-Flash da pré-visualização. No papel, é o tipo de lançamento menos interessante: nenhuma arquitetura nova, nenhum número novo de parâmetros, nenhuma janela de contexto nova. O modelo saiu exatamente com o mesmo corpo de mistura de especialistas 284B/13B que tinha em abril. O que mudou foi o pós-treino.
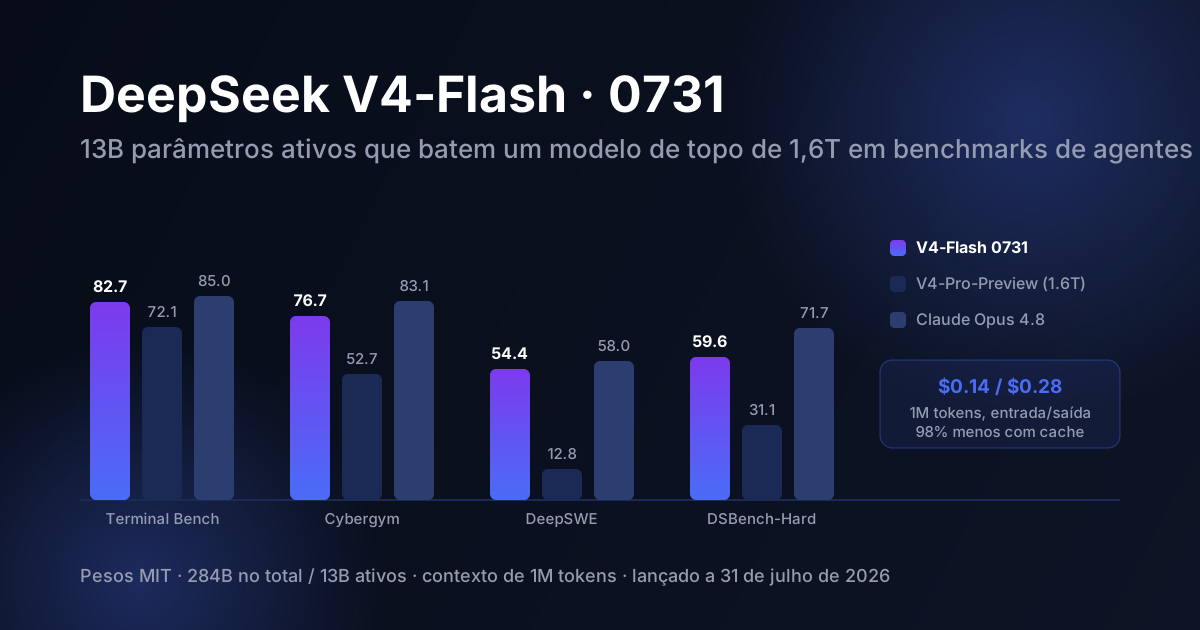
E esse modelo pequeno, com um pós-treino novo, supera agora o próprio modelo de topo da DeepSeek, o V4-Pro-Preview de 1,6 biliões de parâmetros, nos nove benchmarks de agentes publicados — com margens entre 8,7 e 41,6 pontos. Custa 0,14 dólares por milhão de tokens de entrada e 0,28 por milhão de saída. Tem licença MIT. Pode descarregar os pesos.
Há aqui uma lição real para quem constrói um produto de IA, e não é «mude para a DeepSeek». É sobre de onde vem realmente a capacidade em 2026, e o que isso faz ao pressuposto — ainda embutido no modelo de custos da maioria dos fundadores — de que um melhor comportamento de agente exige um modelo maior e mais caro.
A entrada do registo de alterações é curta e merece ser lida à letra. O endpoint deepseek-v4-flash serve agora a versão 0731. A arquitetura e o tamanho não mudaram face à pré-visualização; o modelo voltou a ser pós-treinado, com um módulo de descodificação especulativa DSpark acrescentado para aumentar o débito. Ganhou suporte nativo ao formato da Responses API da OpenAI e uma adaptação ao Codex desde o primeiro dia. O controlo do raciocínio passou a ter três níveis explícitos — low, high, max —, que é a forma que os harnesses de agentes esperam de reasoning_effort.
As especificações de fundo: 284B parâmetros no total com 13B ativados, uma janela de contexto de 1M de tokens com até 384 000 tokens de saída, uma pilha de atenção híbrida que combina atenção esparsa comprimida e atenção fortemente comprimida, especialistas em FP4 com FP8 no resto, e cerca de 167 GB de pesos em disco com licença MIT. Os identificadores antigos deepseek-chat e deepseek-reasoner foram retirados a 24 de julho, pelo que agora só funcionam os dois endpoints do V4.
O contexto comercial também conta. A DeepSeek angariou 7,4 mil milhões de dólares com uma avaliação de cerca de 350 mil milhões de yuans, com a participação da Tencent e da NetEase, e disse que o dinheiro vai servir para mais ou menos duplicar a equipa, com foco nos agentes. A versão de pré-visualização do Flash já tinha passado sete semanas seguidas como o modelo mais usado no OpenRouter. Não é um laboratório a lançar uma curiosidade.
Eis os números de agentes publicados, com a versão de pré-visualização incluída para que veja quanto do ganho vem do pós-treino e não do marketing.
| Benchmark | Flash 0731 | Flash Preview | V4-Pro-Preview | Opus 4.8 |
|---|---|---|---|---|
| Terminal Bench 2.1 | 82,7 | 61,8 | 72,1 | 85,0 |
| Cybergym | 76,7 | 38,7 | 52,7 | 83,1 |
| DeepSWE | 54,4 | 7,3 | 12,8 | 58,0 |
| NL2Repo | 54,2 | 39,4 | 38,5 | 69,7 |
| Toolathlon-Verified | 70,3 | 49,7 | 55,9 | 76,2 |
| DSBench-FullStack | 68,7 | 37,0 | 41,8 | 71,6 |
| DSBench-Hard | 59,6 | 25,8 | 31,1 | 71,7 |
| Agents' Last Exam | 25,2 | 15,8 | 16,5 | 25,7 |
| AutomationBench Public | 25,1 | 10,8 | 12,8 | 27,2 |
Há duas coisas que saltam à vista. A primeira é o DeepSWE: de 7,3 para 54,4 com pesos idênticos. Um salto tão grande significa normalmente que o modelo de pré-visualização conseguia fazer a tarefa mas nunca lhe tinham ensinado o harness — falhava no formato, na disciplina das chamadas a ferramentas e em saber quando parar, não no raciocínio. O pós-treino corrigiu a interface, e a capacidade que já lá estava apareceu.
A segunda é a coluna do Opus 4.8. O Flash 0731 fica perto no Terminal Bench (82,7 contra 85,0), no Agents' Last Exam (25,2 contra 25,7) e no DeepSWE (54,4 contra 58,0) — e claramente atrás nos dois mais difíceis: NL2Repo (54,2 contra 69,7) e DSBench-Hard (59,6 contra 71,7). Esse padrão é coerente e é o que deve guiar o seu encaminhamento. A distância fecha-se em tarefas de agente delimitadas e bem especificadas. Continua aberta no trabalho longo, ambíguo e que abrange todo o repositório, em que uma má decisão no passo 40 lhe custa a execução.
As medições independentes concordam de forma geral. A Artificial Analysis coloca o V4-Flash 0731 em 50 no seu Intelligence Index — terceiro entre os modelos de pesos abertos, face a uma mediana de 25, ao nível do Gemini 3.6 Flash e atrás do Claude Opus 5, com cerca de 59. A velocidade de saída é de 113,5 tokens por segundo, face a uma mediana de 61,4 entre os seus pares, com um tempo até ao primeiro token de 1,31 segundos.
Os benchmarks ficam com as manchetes; a linha do preço é o que muda aquilo que consegue construir. A Artificial Analysis mediu o custo de correr toda a bateria do seu Intelligence Index em cada modelo:
É uma diferença de cerca de cem vezes para uma distância de capacidade de nove pontos num índice de cem. A economia da cache é ainda mais agressiva: um acerto de cache custa 0,003 dólares por milhão de tokens, um desconto de 98% e o maior do setor. Se o seu agente repete a cada turno um prompt de sistema grande e estável e um corpus fixo — o que a maioria dos agentes em produção faz —, esse desconto não é um arredondamento: é a diferença entre um fluxo de trabalho que pode oferecer num plano de 29 dólares e um que não pode oferecer de todo.
A DeepSeek também cortou os custos da API em até 50% com este lançamento, e o padrão é já conhecido o suficiente para a Axios o apresentar como uma corrida para zero, com a observação de que os descontos incessantes dos laboratórios chineses pressionam as futuras IPO da OpenAI e da Anthropic. Confirme-se ou não essa tese, a consequência operacional para si é imediata: o preço mínimo do trabalho agêntico competente voltou a descer, e qualquer modelo de preços que tenha construído no pressuposto de que a inferência é cara tem uma vida útil mais curta do que planeou.
O imposto da verbosidade
A Artificial Analysis assinala o V4-Flash como «muito verboso» — consumiu 210M de tokens de saída na avaliação, face a uma mediana de 100M entre os seus pares. Os tokens de saída são a metade cara da fatura. Um modelo com um décimo do preço de saída que emite o dobro dos tokens é uma poupança de cinco vezes, não de dez, e a sua proporção real depende dos seus prompts. Meça o custo por tarefa concluída nos seus próprios registos, não o custo por milhão de tokens de uma página de preços.
Segunda: os preços em hora de ponta. A DeepSeek anunciou um multiplicador de 2× entre as 09:00 e as 12:00 e entre as 14:00 e as 18:00, hora de Pequim. Ainda não estava em vigor no lançamento, mas, se o seu tráfego se concentra nas manhãs da Europa ou dos EUA, modele a tarifa multiplicada e não a anunciada antes de comprometer uma margem com um cliente.
Terceira, e a menos discutida: estes são benchmarks de agentes, e os benchmarks de agentes recompensam exatamente aquilo que acabou de ser pós-treinado. Um salto de 41 pontos no DeepSWE só por voltar a pós-treinar deve deixá-lo um pouco mais desconfiado do benchmark, e não apenas mais impressionado com o modelo. Diz-lhe que a pontuação é muito sensível ao encaixe com o harness. O seu harness não é o deles. Corra o seu próprio conjunto de avaliação — o pequeno, construído a partir de tarefas reais de utilizadores — antes de encaminhar tráfego de produção para algo novo.
A comparação não é bem justa, e perceber porquê é a parte útil. O Flash 0731 é um produto acabado e afinado para agentes. O V4-Pro-Preview é uma pré-visualização — uma demonstração de capacidade de base que não recebeu o mesmo tratamento. A DeepSeek diz que o lançamento oficial do V4-Pro está iminente, com suporte à Responses API e ao Codex no início de agosto, e quando chegar a ordem vai quase de certeza inverter-se de novo.
Mas «a comparação não é justa» é a conclusão. O que separou os dois modelos em nove benchmarks não foram um bilião e meio de parâmetros de capacidade bruta. Foi alguém ter ou não ensinado o modelo a comportar-se dentro de um ciclo de agente: quando chamar uma ferramenta, como formatar a chamada, quando parar de raciocinar e agir, como recuperar de um passo falhado. A escala comprou a capacidade de fundo. O pós-treino foi o que a converteu em tarefas concluídas.
Isso corresponde quase exatamente ao que os fundadores continuam a descobrir um nível acima no stack. A demo funciona porque o modelo é capaz. A produção falha porque nada à volta do modelo sabe correr um ciclo de forma fiável — a mesma razão pela qual a engenharia de contexto, os conjuntos de avaliação e os sistemas de permissões acabam sempre por importar mais do que o modelo de fronteira que escolheu. A DeepSeek acabou de demonstrar o mesmo princípio dentro dos próprios pesos.
O V4-Pro é o irmão de 1,6T, lançado como pré-visualização de pesos abertos com licença MIT a 24 de abril e com um preço de 0,435/0,87 dólares por milhão de tokens. Obtém cerca de 80,6 no SWE-bench Verified em modo de raciocínio máximo — competitivo, não líder. A história da arquitetura é realmente impressionante em termos de eficiência: com um contexto de 1M de tokens, o V4-Pro precisará de cerca de 27% dos FLOPs de inferência por token e de 10% da cache KV que o V3.2 exigia, e é isso que torna um contexto de um milhão de tokens economicamente plausível, e não apenas publicitado.
Uma comparação de custos de uma análise de um profissional merece ser retida: a implementação de uma funcionalidade representativa de dimensão média custa cerca de 0,12 dólares no V4-Pro, face a cerca de 10,00 dólares num nível premium de fronteira. Mesmo descontando a ressalva da verbosidade e a taxa de falhas que observar, é outra categoria de economia unitária — e é a razão pela qual «usar o melhor modelo para tudo» deixou de ser uma predefinição defensável há cerca de um ano.
A tentação com um lançamento destes é tratá-lo como um sinal de compra de um fornecedor. Não é. A DeepSeek está atrás do Kimi K3 da Moonshot, com 2,8 biliões de parâmetros, o Kimi vai ser batido no preço por alguma coisa em outubro, e o modelo competente mais barato de qualquer mês é um alvo em movimento sobre o qual nunca deve construir a identidade de um produto.
O que é duradouro é a direção. A capacidade a um dado preço está a cair depressa, o nível dos pesos abertos está agora tão perto da fronteira no trabalho agêntico delimitado que a escolha é uma decisão de encaminhamento e não de qualidade, e o custo marginal da camada de modelos caminha para o chão. Se a vantagem do seu produto é ter acesso a um bom modelo, essa vantagem está a ser desvalorizada em público, lançamento a lançamento.
A vantagem que sobrevive é exatamente aquela cuja importância a DeepSeek acabou de provar: o trabalho de tornar fiável um sistema capaz dentro de um ciclo específico, num domínio específico, para um utilizador específico. Foi essa a distância entre 7,3 e 54,4 com os mesmos pesos. É também, mais ou menos exatamente, a distância entre uma demo de IA e um negócio de IA.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.