
Contexto longo não é memória: dois estudos desta semana dizem que o estado do seu agente deve ficar fora do modelo

By Surya Pratap
5 de novembro de 2026
8 min read
AI & Technology

5 de novembro de 2026
8 min read
 Veja o que falhou, e a soluçãoHover to explore
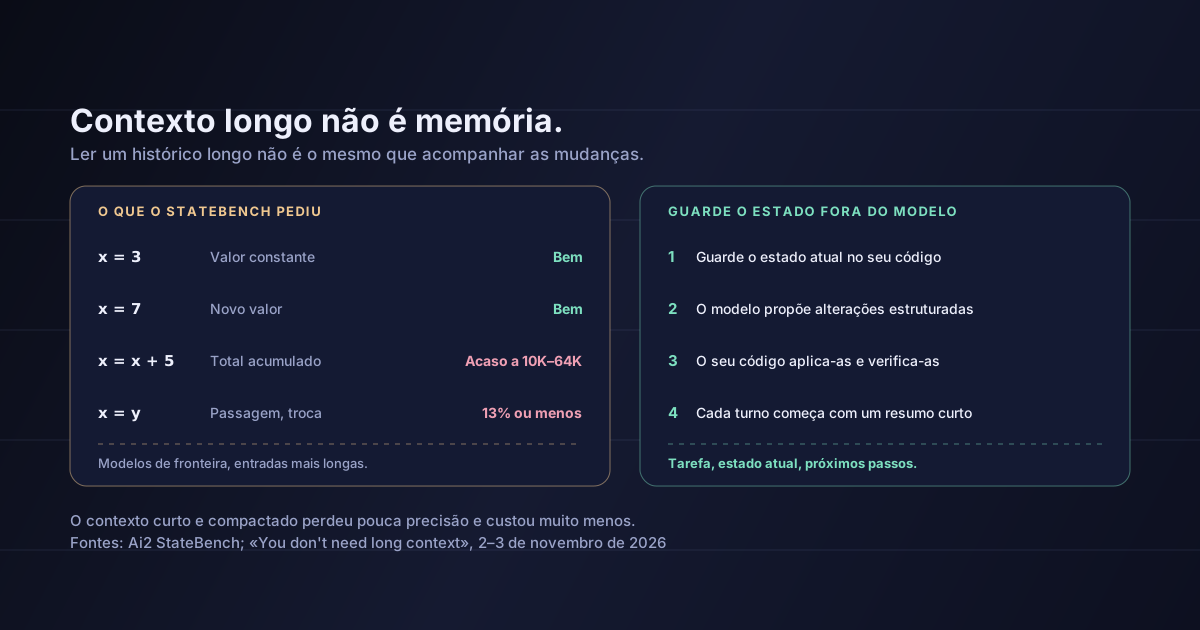
Se o seu agente percorre um histórico longo de alterações para perceber em que ponto estão as coisas, vale a pena dedicar dez minutos a dois estudos publicados esta semana. Pense num pedido de suporte reatribuído quatro vezes, numa contagem de stock ajustada a cada encomenda ou num orçamento que sobe e desce ao longo de cem mensagens. O primeiro estudo mostra que os modelos de fronteira conseguem ler esse histórico e, mesmo assim, errar o estado final quando ele é suficientemente longo. O segundo mostra que normalmente pode dar ao modelo muito menos contexto do que ele suporta, perder pouca ou nenhuma precisão e pagar bastante menos. Nenhum dos dois foi escrito a pensar em fundadores, mas juntos descrevem um desenho que pode adotar já esta semana.
Este artigo baseia-se no anúncio do StateBench pelo Ai2 e no respetivo relatório técnico, arXiv:2611.03094, e em arXiv:2611.05306, «You don't need long context». Os números e as citações vêm desses documentos. A interpretação a partir da secção 3 é minha.
O StateBench, publicado pelo Ai2 a 3 de novembro com um relatório técnico datado de 2 de novembro, testa uma única competência concreta: seguir uma sequência de atualizações e indicar o estado final. Os autores, Jackson Petty, William Merrill e Ashish Sabharwal, construíram quatro níveis de dificuldade que só diferem no tipo de atualização:
x = x + 5.x = y, ou dois valores trocam entre si.Cada problema é escrito em seis formatos com a mesma estrutura de fundo, desde código simples até preencher células de uma folha de cálculo ou seguir pessoas que mudam de sala. Os modelos de fronteira respondiam por palavras próprias, em vez de escolherem entre opções. Foram testados quatro: Gemini 3.8 Flash, Claude Opus 5.5 e GPT-6 Sol e Luna.
O resultado foi claro. Nas palavras do relatório, todos os modelos de fronteira «têm um desempenho forte nos problemas r-triviais e aperiódicos», mas «descem ao nível do acaso nos problemas solúveis e de estados finitos» quando a entrada chega aos 10K a 64K tokens. Os dois primeiros níveis aguentaram; os dois últimos ruíram. O anúncio do Ai2 coloca o caso mais difícil em «13% ou menos nos problemas finitos gerais mais longos».
Há outra conclusão que importa a quem escolhe modelos com base em benchmarks. Modelos pré-treinados pequenos que quase atingiam o máximo em problemas do tipo RULER, a família da agulha no palheiro, ficavam perto do nível do acaso quando os mesmos problemas eram apresentados como edições numa folha de cálculo. Conseguir encontrar um facto numa entrada longa não significa que o modelo consiga acompanhar a forma como esse facto mudou.
O segundo estudo, «You don't need long context», de Peter Belcak e mais onze coautores, publicado a 3 de novembro, parte do custo: «Os tokens posteriores são mais caros de gerar do que os anteriores.» Nos modelos de pesos abertos que serviram, gerar com uma janela de contexto de 256K custava 3,6 a 7 vezes mais do que com 16K.
Em seguida, testou duas formas de manter o contexto curto. Na primeira, o agente funciona normalmente até o contexto ultrapassar um limiar; escreve então um resumo delimitado do seu estado, e uma conversa nova começa a partir da tarefa original mais esse resumo. Na segunda, mais extrema, cada conversa executa uma única ação, atualiza o resumo e é descartada. Os resumos que funcionavam continham uma cópia quase literal da tarefa, as intenções e os próximos passos do agente, e os artefactos de que o trabalho seguinte precisaria. Os autores chamam-lhes «resumos cuidadosamente escolhidos a dedo», não narrativas.
Em tarefas de horizonte longo, incluindo SWE-bench Verified e Terminal-Bench 2.1, a precisão variou entre -3,7 e +5,6 pontos percentuais para o Claude Opus 4.5 e entre -3,3 e +4,4 para o GPT 5.6 Sol, contra poupanças estimadas a preços de tabela de 2,2 a 8,8 vezes e de 2,4 a 5,0 vezes. Em tarefas com entradas longas, a precisão mudou entre -0,4 e +40,0 pontos para o Opus, com poupanças estimadas de 6,5 a 54,6 vezes. Até uma única ação por conversa aguentou: o Opus passou de 70,0 para 70,2 no SWE-bench Verified, enquanto o GPT 5.6 Sol passou de 84,4 para 82,4.
Um estudo mostra o modelo a perder a contagem num histórico longo. O outro mostra que raramente precisava desse histórico. Ambos apontam no mesmo sentido: guarde o estado noutro lugar.
A maioria dos agentes em produção acompanha estado, quer alguém lhe chame assim quer não. Um agente de suporte descobre quem é o responsável por um pedido depois de três passagens. Um agente de compras mantém um total acumulado face a um orçamento. Um agente de operações responde a «qual é o estado atual?» a partir de um registo de eventos. Nos termos do StateBench, um total acumulado é uma autoatualização e uma passagem é uma atribuição por referência. São precisamente os dois níveis em que os modelos de fronteira desceram ao nível do acaso à medida que a entrada crescia.
O desenho habitual agrava o problema. Muitos agentes guardam no contexto a transcrição completa e cada resultado de ferramenta, e pedem ao modelo que deduza o estado atual a partir de tudo isso em cada turno. Funciona numa demo com vinte mensagens. É o padrão que o StateBench quebra entre 10K e 64K tokens, uma extensão que um agente com ferramentas muito verbosas pode atingir numa única sessão de trabalho.
O estudo sobre compactação sugere que a solução custa pouco. Se um resumo curto mantém a precisão a poucos pontos em tarefas difíceis de agentes, não há grande razão para obrigar o modelo a reconstruir o estado a partir de um histórico longo. E, de qualquer forma, o modelo não é o sítio certo para guardar a cópia de referência desse estado.
O padrão é simples. O seu código guarda o estado atual. O modelo lê esse estado, propõe alterações como operações estruturadas e o seu código aplica-as. Cada turno começa com um resumo curto, não com o histórico completo.
from dataclasses import dataclass, field

@dataclass
class OrderState:
    status: str = "draft"
    quantity: int = 0
    assignee: str | None = None
    log: list[dict] = field(default_factory=list)

ALLOWED_OPS = {"set_status", "add_quantity", "assign"}

def apply(state: OrderState, op: dict) -> OrderState:
    kind = op.get("op")
    if kind not in ALLOWED_OPS:
        raise ValueError(f"unknown operation: {kind}")
    if kind == "set_status":
        state.status = op["value"]
    elif kind == "add_quantity":
        state.quantity += int(op["value"])  # arithmetic happens here, not in the model
    elif kind == "assign":
        state.assignee = op["value"]
    state.log.append(op)  # full history kept for audit, not for the prompt
    return state

def brief(task: str, state: OrderState, next_steps: list[str]) -> str:
    return (
        f"TASK: {task}\n"
        f"CURRENT STATE: status={state.status}, quantity={state.quantity}, "
        f"assignee={state.assignee}\n"
        f"NEXT STEPS: {'; '.join(next_steps)}"
    )
Guarde o estado de referência em código. Uma linha de base de dados ou um objeto tipado, não um parágrafo na transcrição. Se o estado importa, deve ser algo que possa consultar, e não algo que o modelo tenha de voltar a deduzir.
Deixe o modelo propor, não calcular. Peça operações estruturadas como add_quantity ou assign. O seu código faz a aritmética e resolve as referências, que é exatamente onde o StateBench viu os modelos falhar.
Comece cada turno com um resumo. A tarefa tal como foi escrita, o estado atual e os próximos passos. Guarde o histórico completo num registo para auditorias e vá buscá-lo apenas quando um passo precisar dele.
Encontre o seu próprio ponto de rutura. Execute o seu agente nas suas tarefas reais com históricos cada vez mais longos e registe onde o estado final começa a falhar. Compacte bem antes desse ponto.
Dois avisos. Um resumo escrito pelo modelo é uma saída do modelo: em setembro, mostrámos como os modelos escreviam instruções nos seus próprios resumos de compactação, por isso construa o resumo a partir do estado guardado sempre que possível e verifique o que o modelo acrescenta. E acrescente casos de acompanhamento de estado ao seu conjunto de avaliação, com históricos longos, reatribuições e totais acumulados, porque uma boa pontuação na agulha no palheiro não o vai avisar.
Artigos anteriores relacionados
Em julho, escrevemos sobre porque é que os agentes se esquecem no segundo mês e sobre a arquitetura de memória que resiste ao uso real. Em outubro, medimos quanto custa por tarefa uma janela de contexto sobrecarregada. Os estudos desta semana acrescentam a peça que faltava: um contexto longo não é apenas caro, é também um mau sítio para acompanhar mudanças.
Que os modelos de fronteira não conseguem acompanhar estado. Saíram-se bem nos dois níveis mais simples. O colapso aconteceu nas autoatualizações e nas referências, a partir de 10K tokens.
Que o StateBench descreve o seu produto. Usa sequências sintéticas. Pelo que li, o relatório não indica que definições de raciocínio os modelos de fronteira usaram, e o uso de ferramentas, como executar código, pode mudar o quadro. Meça as suas próprias tarefas.
Que a compactação é gratuita. Os autores dizem-no claramente: «Perde-se informação em consequência de compactar um histórico de conversa.» Os modelos mais fracos sofreram com orçamentos apertados. O Qwen 3 Coder Next caiu de 53,0% para 3,6% no SWE-bench Verified na definição mais restritiva.
Que o contexto longo não serve para nada. O estudo sobre compactação afirma que as suas provas «não excluem a existência de tarefas em que o contexto longo é benéfico». Ler uma vez um contrato longo é um trabalho diferente de acompanhar mudanças ao longo de uma sessão longa.
Dois estudos publicados a 2 e 3 de novembro chegam à mesma conclusão prática a partir de direções opostas. O StateBench mostrou que os modelos de fronteira lidam bem com valores constantes e reatribuições simples, mas descem ao nível do acaso a acompanhar autoatualizações e referências quando a entrada chega aos 10K a 64K tokens. «You don't need long context» mostrou que compactar o contexto de um agente num resumo curto perdia pouca ou nenhuma precisão em tarefas difíceis de agentes, reduzindo várias vezes o custo estimado.
Para os fundadores, a lição é sobre onde vive o estado. A janela de contexto é onde o modelo lê, não onde o seu produto deve guardar os seus registos.
Esta semana, encontre o único ponto em que o seu agente deduz o estado atual a partir de um histórico longo. Passe esse estado para o código, faça o modelo propor alterações como operações estruturadas e comece cada turno com um resumo.
Fontes: Ai2, anúncio do StateBench (3 de novembro de 2026) — os quatro níveis de dificuldade, os modelos de fronteira testados e o número de «13% ou menos» nos problemas finitos gerais mais longos; Jackson Petty, William Merrill e Ashish Sabharwal, A Fine-Grained Hierarchy and Benchmark for State Tracking in Language Models, arXiv:2611.03094 (2 de novembro de 2026) — os seis formatos, a avaliação generativa dos modelos de fronteira, o resultado ao nível do acaso entre 10K e 64K tokens e a comparação entre RULER e folha de cálculo; Peter Belcak et al., You don't need long context, arXiv:2611.05306 (3 de novembro de 2026) — a comparação de custos de serviço de 3,6 a 7 vezes, os dois métodos de compactação e o conteúdo dos resumos eficazes, as variações de precisão e as poupanças estimadas para o Claude Opus 4.5 e o GPT 5.6 Sol, o resultado do Qwen 3 Coder Next e as limitações declaradas. O código da secção 4 é uma ilustração minha, e a interpretação das secções 3 a 5 também é minha.

IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.