
O muro do segundo mês: porque é que o seu agente de IA esquece, e a arquitetura de memória que resolve o problema (2026)

By Surya Pratap
27 de julho de 2026
10 min read
AI & Technology

27 de julho de 2026
10 min read
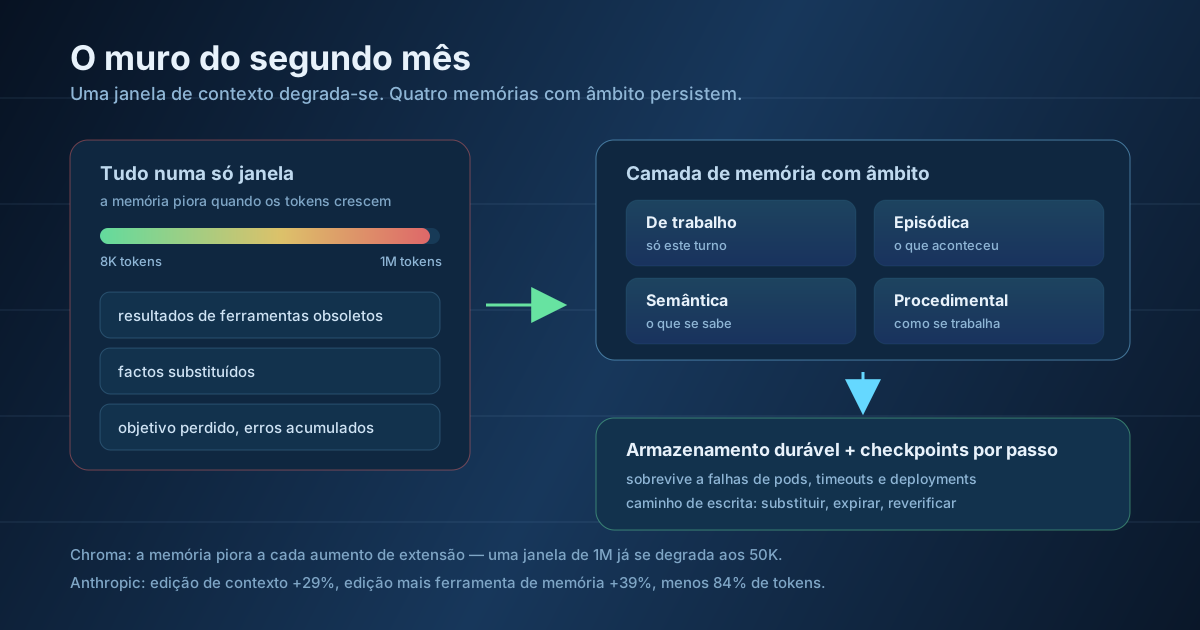
Circula neste momento uma queixa muito concreta nos cantos do Reddit onde se constroem agentes (r/AI_Agents, r/Automation, r/n8n), e chega sempre com o mesmo calendário. A demo funcionou. O piloto funcionou. Depois, algures por volta da sexta ou oitava semana, com uso real e sessões de duração real, o agente começou a errar de forma subtil. Voltou a fazer uma pergunta a que já tinham respondido. Agiu com base num dado do cliente que tinha mudado duas semanas antes. Perdeu o fio a uma tarefa longa e concluiu com toda a confiança a tarefa errada. Quem constrói agentes começou a chamar-lhe o muro do segundo mês, e o mais frustrante é que nada se partiu. Nenhum erro, nenhuma exceção, nenhum deployment falhado. O agente foi simplesmente piorando em silêncio.
O instinto é culpar o modelo e fazer upgrade. Isso quase nunca resolve, porque isto não é uma falha do modelo: é uma falha da arquitetura de memória. A maioria das falhas de agentes em produção são falhas de contexto, e a forma do problema tornou-se suficientemente clara em 2026 para ter um nome, um conjunto de medições por trás e uma série de soluções aborrecidas no melhor sentido possível. Este é um guia para fundadores sobre o que corre realmente mal, porque é que janelas de contexto maiores não salvaram ninguém e como deve ser a camada de memória antes de o seu agente chegar ao segundo mês.
A evidência mais clara vem da investigação Context Rot da Chroma, que avaliou 18 modelos de fronteira, entre eles o GPT-4.1, o Claude 4, o Gemini 2.5 e o Qwen3, em oito comprimentos de entrada e em tarefas deliberadamente simples como a recuperação e a replicação de texto. O resultado é desconfortável: os modelos não processam o contexto de forma uniforme. A capacidade de recordar degrada-se a cada aumento de comprimento, não apenas perto do limite. Um modelo com uma janela de contexto de um milhão de tokens já mostra uma degradação mensurável aos cinquenta mil tokens.
Há dois pormenores que importam mais do que a manchete. Primeiro, a degradação acelera à medida que cai a semelhança semântica entre o facto enterrado e a pergunta, de modo que, quanto mais difícil a recuperação, mais rápida a degradação. Segundo, os distratores e a estrutura do palheiro alteram a curva independentemente do comprimento bruto. Juntos apontam para a mesma conclusão: a relação sinal-ruído importa mais do que a capacidade. Encher uma janela maior não é uma estratégia; é precisamente o que causa o problema.
Porque é que o muro aparece precisamente no segundo mês
As demos são curtas. Os pilotos são curtos. É no uso real que as sessões se alongam, o histórico se acumula e os factos aprendidos na primeira semana ficam desatualizados. O contexto que estava limpo no lançamento é, ao segundo mês, um grande monte de resultados de ferramentas meio relevantes e de verdades já substituídas, e é exatamente esse o regime em que a capacidade de recordar se desfaz.
A mudança de perspetiva mais útil é perceber que a «memória» não é uma coisa só. Os sistemas de agentes em produção separam pelo menos quatro tipos, e a maioria dos primeiros MVP comprime os quatro numa única transcrição de conversa que não para de crescer. A memória de trabalho é aquilo de que o agente precisa para o passo atual e deve ser descartável sem hesitação. A memória episódica é o que aconteceu: o registo de sessões e resultados anteriores. A memória semântica é o que se sabe: factos duradouros sobre um utilizador, uma conta, um domínio. A memória procedimental é a forma como o trabalho se faz: os fluxos e padrões aprendidos que devem sobreviver a cada sessão.
Têm tempos de vida completamente diferentes, e é esse o ponto. A memória de trabalho deve ser limpa constantemente; a semântica deve persistir durante meses mas poder ser corrigida; a procedimental deve ser versionada como código. Quando as quatro vivem numa única janela de contexto, obtém a pior política para cada uma: nada é alguma vez limpo, nada é alguma vez atualizado como deve ser, e cada facto disputa a atenção com cada resultado de ferramenta obsoleto. Degradação do contexto, deriva da memória, objetivos perdidos e erros acumulados são o que esse desenho de janela única produz sob carga.
Além dos tipos, o âmbito importa. Os sistemas de memória maduros indexam a recuperação pela identidade: utilizador, agente, sessão ou execução, e organização. Um facto aprendido sobre um utilizador não deve passar para a sessão de outro; um fluxo aprendido ao nível da organização deve estar disponível em todo o lado. Se o seu agente não tem um modelo de âmbito, ou esquece demasiado ou lembra-se de coisas que não lhe compete lembrar, e a segunda falha é um incidente de privacidade à espera de acontecer.
O lado animador de 2026 é que as soluções são mensuráveis, e são de arquitetura em vez de dependerem do modelo. Os resultados publicados pela Anthropic sobre as suas próprias avaliações de pesquisa agêntica são o exemplo mais limpo: a edição de contexto, que retira automaticamente da janela as chamadas e resultados de ferramentas desatualizados, trouxe uma melhoria de 29% em tarefas complexas de vários passos. Juntar uma ferramenta de memória, com a qual o modelo lê e escreve ficheiros num diretório de memória que vive fora da janela de contexto, levou o ganho combinado aos 39%. Numa avaliação de pesquisa na web com cem turnos, a edição de contexto permitiu aos agentes terminar fluxos que antes morriam por esgotamento do contexto, reduzindo ao mesmo tempo o consumo de tokens em 84%.
Leia essa combinação com atenção, porque é a lição de desenho. A edição sozinha ajuda porque melhora a relação sinal-ruído. A edição mais uma memória externa ajuda mais porque o agente deixa de ter de escolher entre esquecer algo e afogar-se nisso. A redução de 84% dos tokens é a parte que os fundadores devem ver duas vezes: é um dos raros casos em que a correção de fiabilidade e a correção de custo são a mesma alteração.
As camadas de memória dedicadas reportam ganhos semelhantes nos benchmarks habituais: pontuações entre o início e o meio dos noventa no LoCoMo e no LongMemEval com cerca de sete mil tokens por consulta, e saltos de dois dígitos em raciocínio temporal e multi-salto face a abordagens anteriores. Mas o número honesto é o da avaliação em grande escala: no BEAM, o desempenho cai de cerca de 64 com um milhão de tokens de histórico para cerca de 49 com dez milhões. Mesmo os bons sistemas de memória se degradam à medida que o histórico cresce. A qualidade da recuperação é uma limitação real, não um problema resolvido, e qualquer roteiro que assuma que «basta acrescentar memória» está a saltar a metade difícil.
O primeiro passo mais barato
Antes de avaliar um único fornecedor de memória, acrescente edição de contexto: faça expirar os resultados de ferramentas assim que tenha agido com base neles, e descarte os traços de raciocínio que já não informam o passo seguinte. São poucos dias de trabalho, não exige infraestrutura nova e é a alteração com melhor retorno medido por hora investida.
Quase todas as conversas sobre memória se centram na recuperação: embeddings, rerankers, pesquisa híbrida. Mas as falhas que quem constrói agentes descreve no Reddit são esmagadoramente falhas do caminho de escrita. O agente lembrou-se corretamente de algo e depois o mundo mudou. O cliente passou para outro plano. A política foi atualizada. O contacto que aprovava as coisas saiu. A memória não está errada sobre o passado; está errada sobre o agora, e o sistema não tem nenhum mecanismo para o notar.
Um comentador nesses tópicos disse-o melhor do que a maioria da documentação dos fornecedores: a fiabilidade a longo prazo precisa de uma forma de esquecer, substituir e voltar a verificar factos. São três operações distintas. Esquecer é um tempo de vida para memórias que só eram circunstanciais. Substituir é escrever um facto novo que retira explicitamente o antigo em vez de ficar ao lado dele, porque duas memórias contraditórias num índice de recuperação são um cara ou coroa, não uma base de conhecimento. Voltar a verificar é confirmar novamente os factos críticos junto do sistema de origem antes de agir com base neles, em vez de confiar numa nota com seis semanas.
A desatualização da memória é abertamente reconhecida como um problema por resolver, mesmo pelas equipas que constroem infraestrutura de memória, a par da abstração temporal e da resolução de identidades. Por isso, não espere que uma biblioteca trate disso. Decida, por categoria de facto, quanto tempo continua verdadeiro e o que acontece quando deixa de o ser, e escreva essa política no sistema e não num documento de desenho.
A outra metade do muro do segundo mês não tem nada de cognitivo: é de infraestrutura. Os agentes que correm durante horas ou dias vão deparar-se com timeouts do fornecedor, falhas de pods, deployments agendados e interrupções de rede. Não são casos extremos; num horizonte suficientemente longo, são garantidos. Se o estado da sessão vive na memória do processo ou no disco efémero de um pod, cada um desses eventos destrói em silêncio tudo o que o agente sabia, e o agente recomeça o fluxo do início, a queimar tokens e por vezes a repetir efeitos secundários que nunca deveria repetir.
O padrão que funciona é aborrecido e bem conhecido: estado em armazenamento durável, checkpoints escritos antes da execução de cada passo e retoma no ponto exato da falha em vez do início. A observação dessas mesmas comunidades é taxativa: os agentes que dão dinheiro têm caminhos de recuperação duráveis, e os que falham em produção não têm. É também por isso que a crítica recorrente no debate deste verão no X sobre grafos versus ciclos na orquestração teve tanto impacto: como apontou o criador do XState, o setor continua a redescobrir padrões de engenharia de software com décadas, com nomes novos. As máquinas de estado duráveis são um deles. O seu agente precisa das mesmas garantias de recuperação de que qualquer trabalho de longa duração precisou nos últimos trinta anos.
Se vai lançar um MVP com IA no próximo trimestre, não precisa de um sistema de memória de nível de investigação. Precisa de não bater no muro. É um trabalho muito mais pequeno, e consiste sobretudo em tomar quatro decisões de forma explícita em vez de por acaso.
Este último ponto é o que a maioria das equipas salta. Toda a razão pela qual o muro do segundo mês é uma surpresa é que ninguém testou o segundo mês: o conjunto de avaliação foi construído a partir de tarefas limpas, curtas e de primeira sessão, por isso continuou a passar enquanto a fiabilidade real escorregava. Se tirar uma única coisa de tudo isto, que seja esta: ponha na sua bateria de testes uma sessão deliberadamente longa e deliberadamente desatualizada, com um facto que mudou a meio, e veja se o seu agente dá por isso.
A mudança de fundo merece ser nomeada. Em 2026, os compradores deixaram de se impressionar com demos de agentes, porque toda a gente tem uma. O que compram de facto é a conclusão de tarefas que aguenta à centésima execução, e isso é decidido quase inteiramente por uma arquitetura que a demo nunca põe à prova. É na memória que essa batalha se ganha: não pelo modelo que escolhe, mas por aquilo que decide guardar, aquilo que decide deitar fora e aquilo que garante que sobrevive a um deployment.


IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.