Lange context is geen geheugen: twee papers van deze week zeggen dat de state van je agent buiten het model hoort

By Surya Pratap
5 november 2026
8 min read
AI & Technology

5 november 2026
8 min read
 Bekijk wat er misging, en de oplossingHover to explore
Als je agent een lange geschiedenis van wijzigingen doorloopt om te bepalen hoe het er nu voor staat, zijn twee papers van deze week tien minuten van je tijd waard. Denk aan een ticket dat vier keer is doorgezet, een voorraadtelling die bij elke order wordt bijgesteld, of een budget dat over honderd berichten op en neer gaat. Het eerste paper laat zien dat frontier-modellen die geschiedenis kunnen lezen en toch de eindstand fout hebben zodra ze lang genoeg is. Het tweede laat zien dat je het model meestal veel minder context kunt geven dan het aankan, weinig tot geen nauwkeurigheid verliest en veel minder betaalt. Geen van beide is voor founders geschreven, maar samen beschrijven ze een ontwerp dat je deze week kunt overnemen.
Dit artikel is gebaseerd op de aankondiging van StateBench door Ai2 en het technische rapport, arXiv:2611.03094, en op arXiv:2611.05306, 'You don't need long context'. Cijfers en citaten komen uit die documenten. De interpretatie vanaf sectie 3 is van mij.
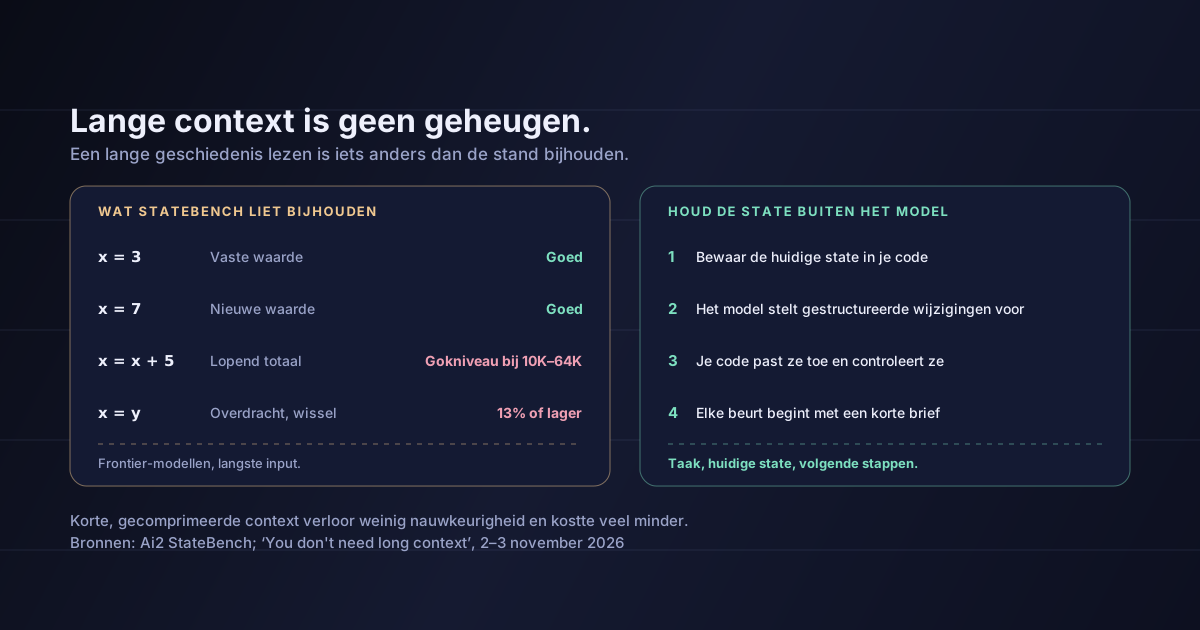
StateBench, op 3 november door Ai2 gepubliceerd met een technisch rapport gedateerd 2 november, test één afgebakende vaardigheid: een reeks updates volgen en de eindstand geven. De auteurs, Jackson Petty, William Merrill en Ashish Sabharwal, bouwden vier moeilijkheidsniveaus die alleen verschillen in het soort update:
x = x + 5.x = y, of twee waarden wisselen.Elk probleem is uitgeschreven in zes formaten met dezelfde onderliggende structuur, van kale code tot het invullen van spreadsheetcellen en het volgen van mensen die tussen kamers wisselen. De frontier-modellen antwoordden in eigen woorden in plaats van uit opties te kiezen. Er werden er vier getest: Gemini 3.8 Flash, Claude Opus 5.5, en GPT-6 Sol en Luna.
De uitkomst was duidelijk. Volgens het rapport "presteren alle frontier-modellen sterk op r-triviale en aperiodieke problemen", maar "vallen ze terug tot gokniveau op oplosbare en eindige state-trackingproblemen" zodra de input tussen 10K en 64K tokens komt. De eerste twee niveaus hielden stand; de laatste twee stortten in. De aankondiging van Ai2 plaatst het moeilijkste geval op "13% of lager bij de langste algemene eindige problemen".
Nog een bevinding is van belang voor wie een model kiest op benchmarkscores. Kleine voorgetrainde modellen die bijna het maximum haalden op RULER-achtige problemen, de needle-in-a-haystack-familie, zaten bijna op gokniveau als dezelfde problemen werden geformuleerd als spreadsheetbewerkingen. Een feit kunnen vinden in een lange input betekent niet dat het model kan bijhouden hoe dat feit veranderde.
Het tweede paper, 'You don't need long context' van Peter Belcak en elf co-auteurs, verschenen op 3 november, begint bij de kosten: "Latere tokens zijn duurder om te genereren dan eerdere tokens." Bij de open-weight-modellen die zij serveerden, kostte genereren met een contextvenster van 256K 3,6 tot 7 keer zoveel als met 16K.
Daarna testte het twee manieren om de context kort te houden. In de eerste draait de agent normaal tot de context een drempel overschrijdt; dan schrijft hij een begrensde brief over zijn state en begint een nieuw gesprek vanaf de oorspronkelijke taak plus die brief. In de tweede, extremere variant voert elk gesprek één actie uit, werkt de brief bij en wordt het weggegooid. De briefs die werkten bevatten een vrijwel letterlijke kopie van de taak, de huidige intenties en volgende stappen van de agent, en de artefacten die het vervolgwerk nodig had. De auteurs noemen ze "zorgvuldig uitgekozen briefs", geen verhalen.
Bij long-horizon-taken, waaronder SWE-bench Verified en Terminal-Bench 2.1, bewoog de nauwkeurigheid tussen -3,7 en +5,6 procentpunt voor Claude Opus 4.5 en tussen -3,3 en +4,4 voor GPT 5.6 Sol, tegenover geschatte besparingen op retailprijzen van 2,2 tot 8,8 keer en 2,4 tot 5,0 keer. Bij taken met lange input veranderde de nauwkeurigheid met -0,4 tot +40,0 punt voor Opus, met geschatte besparingen van 6,5 tot 54,6 keer. Zelfs één actie per gesprek hield stand: Opus ging van 70,0 naar 70,2 op SWE-bench Verified, terwijl GPT 5.6 Sol van 84,4 naar 82,4 ging.
Het ene paper laat het model de tel kwijtraken in een lange geschiedenis. Het andere laat zien dat het die geschiedenis zelden nodig had. Beide wijzen dezelfde kant op: bewaar de state ergens anders.
De meeste agents in productie houden state bij, of iemand ze zo noemt of niet. Een supportagent bepaalt wie eigenaar is van een ticket na drie overdrachten. Een inkoopagent houdt een lopend totaal bij tegenover een budget. Een operations-agent beantwoordt "wat is de huidige status?" op basis van een eventlog. In StateBench-termen is een lopend totaal een zelf-update en een overdracht een toewijzing op referentie. Dat zijn precies de twee niveaus waarop frontier-modellen terugvielen tot gokniveau naarmate de input groeide.
Het gangbare ontwerp maakt het erger. Veel agents houden het volledige transcript en elk toolresultaat in de context, en vragen het model om daar elke beurt de huidige state uit af te leiden. Dat werkt in een demo met twintig berichten. Het is het patroon dat StateBench breekt tussen 10K en 64K tokens, een lengte die een agent met breedsprakige tooloutput binnen één werksessie kan bereiken.
Het compaction-paper suggereert dat de oplossing weinig kost. Als een korte brief de nauwkeurigheid op lastige agenttaken binnen een paar punten houdt, is er weinig reden om het model de state te laten reconstrueren uit een lange geschiedenis. En het model is sowieso niet de juiste plek voor de leidende kopie van die state.
Het patroon is eenvoudig. Je code houdt de huidige state bij. Het model leest die state, stelt wijzigingen voor als gestructureerde operaties en je code past ze toe. Elke beurt begint met een korte brief, niet met de volledige geschiedenis.
from dataclasses import dataclass, field

@dataclass
class OrderState:
    status: str = "draft"
    quantity: int = 0
    assignee: str | None = None
    log: list[dict] = field(default_factory=list)

ALLOWED_OPS = {"set_status", "add_quantity", "assign"}

def apply(state: OrderState, op: dict) -> OrderState:
    kind = op.get("op")
    if kind not in ALLOWED_OPS:
        raise ValueError(f"unknown operation: {kind}")
    if kind == "set_status":
        state.status = op["value"]
    elif kind == "add_quantity":
        state.quantity += int(op["value"])  # arithmetic happens here, not in the model
    elif kind == "assign":
        state.assignee = op["value"]
    state.log.append(op)  # full history kept for audit, not for the prompt
    return state

def brief(task: str, state: OrderState, next_steps: list[str]) -> str:
    return (
        f"TASK: {task}\n"
        f"CURRENT STATE: status={state.status}, quantity={state.quantity}, "
        f"assignee={state.assignee}\n"
        f"NEXT STEPS: {'; '.join(next_steps)}"
    )
Houd de leidende state in code. Een databaserij of een getypeerd object, geen alinea in het transcript. Als de state ertoe doet, moet je hem kunnen opvragen in plaats van dat het model hem opnieuw moet afleiden.
Laat het model voorstellen, niet rekenen. Vraag om gestructureerde operaties zoals add_quantity of assign. Je code doet het rekenwerk en lost de referenties op, precies waar StateBench modellen zag falen.
Begin elke beurt met een brief. De taak zoals die is geschreven, de huidige state en de volgende stappen. Bewaar de volledige geschiedenis in een log voor audits en haal er alleen iets uit als een stap dat nodig heeft.
Vind je eigen breekpunt. Draai je agent op je echte taken met steeds langere geschiedenissen en noteer waar de eindstand fout begint te gaan. Comprimeer ruim vóór dat punt.
Twee kanttekeningen. Een brief die het model schrijft, is modeloutput: in september beschreven we hoe modellen instructies in hun eigen compaction-samenvattingen schreven, dus bouw de brief waar mogelijk op uit je opgeslagen state en controleer wat het model toevoegt. En voeg state-trackingcases toe aan je evaluatieset, met lange geschiedenissen, hertoewijzingen en lopende totalen, want een needle-in-a-haystack-score waarschuwt je niet.
Eerdere artikelen die hierbij aansluiten
In juli schreven we over waarom agents in maand twee vergeten en welke geheugenarchitectuur echt gebruik overleeft. In oktober maten we wat een overvol contextvenster per taak kost. De papers van deze week voegen het ontbrekende stuk toe: een lange context is niet alleen duur, het is ook een onbetrouwbare plek om veranderingen bij te houden.
Dat frontier-modellen geen state kunnen bijhouden. Ze deden het goed op de twee eenvoudigere niveaus. De ineenstorting zat bij zelf-updates en referenties, vanaf 10K tokens.
Dat StateBench jouw product beschrijft. Het gebruikt synthetische reeksen. Voor zover ik het rapport heb gelezen, staat er niet in welke redeneerinstellingen de frontier-modellen gebruikten, en toolgebruik zoals het uitvoeren van code kan het beeld veranderen. Meet je eigen taken.
Dat compaction gratis is. De auteurs zeggen het zonder omwegen: "Er gaat informatie verloren als gevolg van het comprimeren van een gespreksgeschiedenis." Zwakkere modellen leden onder krappe budgetten. Qwen 3 Coder Next zakte bij de strengste instelling van 53,0% naar 3,6% op SWE-bench Verified.
Dat lange context nutteloos is. Het compaction-paper zegt dat het bewijs "het bestaan van taken waarvoor lange context gunstig is niet uitsluit". Eén keer een lang contract lezen is ander werk dan veranderingen volgen over een lange sessie.
Twee papers van 2 en 3 november komen vanuit tegengestelde richtingen tot dezelfde praktische conclusie. StateBench liet zien dat frontier-modellen vaste waarden en eenvoudige hertoewijzingen goed aankunnen, maar terugvallen tot gokniveau bij het volgen van zelf-updates en referenties zodra de input 10K tot 64K tokens bereikt. 'You don't need long context' liet zien dat het comprimeren van de context van een agent tot een korte brief weinig tot geen nauwkeurigheid kostte op lastige agenttaken, terwijl de geschatte kosten meervoudig daalden.
Voor founders gaat de les over waar state woont. Het contextvenster is waar het model leest, niet waar je product zijn administratie hoort bij te houden.
Zoek deze week de ene plek waar je agent de huidige state afleidt uit een lange geschiedenis. Verplaats die state naar code, laat het model wijzigingen voorstellen als gestructureerde operaties en begin elke beurt met een brief.
Bronnen: Ai2, aankondiging van StateBench (3 november 2026) — de vier moeilijkheidsniveaus, de geteste frontier-modellen en het cijfer van "13% of lager" bij de langste algemene eindige problemen; Jackson Petty, William Merrill en Ashish Sabharwal, A Fine-Grained Hierarchy and Benchmark for State Tracking in Language Models, arXiv:2611.03094 (2 november 2026) — de zes formaten, de generatieve evaluatie van frontier-modellen, het resultaat op gokniveau tussen 10K en 64K tokens en de vergelijking tussen RULER en spreadsheet; Peter Belcak et al., You don't need long context, arXiv:2611.05306 (3 november 2026) — de vergelijking van serveerkosten van 3,6 tot 7 keer, de twee compaction-methoden en wat effectieve briefs bevatten, de nauwkeurigheidsverschillen en geschatte besparingen voor Claude Opus 4.5 en GPT 5.6 Sol, het resultaat van Qwen 3 Coder Next en de genoemde beperkingen. De code in sectie 4 is mijn illustratie en de interpretatie in secties 3 tot en met 5 is van mij.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.