De muur van maand twee: waarom je AI-agent vergeet, en de geheugenarchitectuur die het oplost (2026)

By Surya Pratap
27 juli 2026
10 min read
AI & Technology

27 juli 2026
10 min read
Er circuleert op dit moment een heel specifieke klacht in de hoeken van Reddit waar agents worden gebouwd (r/AI_Agents, r/Automation, r/n8n), en die komt altijd volgens hetzelfde schema. De demo werkte. De pilot werkte. Dan, ergens rond week zes of acht, met echt gebruik en sessies van echte lengte, begon de agent subtiel dingen fout te doen. Hij stelde opnieuw een vraag die al beantwoord was. Hij handelde op basis van een klantgegeven dat twee weken eerder was veranderd. Hij raakte de draad van een lange taak kwijt en maakte vol overtuiging de verkeerde af. Bouwers zijn het de muur van maand twee gaan noemen, en het frustrerende is dat er niets kapotging. Geen fout, geen exception, geen mislukte deploy. De agent werd gewoon stilletjes slechter.
De reflex is het model de schuld te geven en te upgraden. Dat lost het bijna nooit op, want dit is geen modelfout: het is een fout in de geheugenarchitectuur. De meeste agentfouten in productie zijn contextfouten, en de vorm van het probleem is in 2026 duidelijk genoeg geworden om een naam te hebben, een stapel metingen erachter en een reeks oplossingen die in de best mogelijke zin saai zijn. Dit is een gids voor founders over wat er echt misgaat, waarom grotere contextvensters niemand hebben gered en hoe de geheugenlaag eruit moet zien voordat je agent zijn tweede maand ingaat.
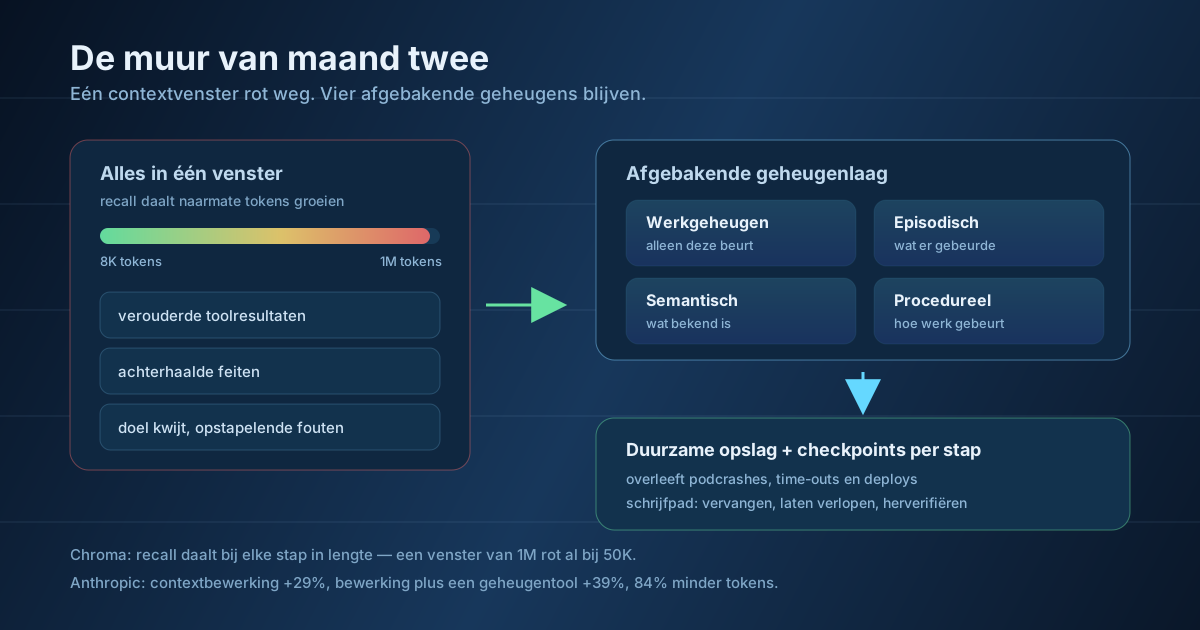
Het duidelijkste bewijs komt uit het Context Rot-onderzoek van Chroma, dat 18 frontiermodellen evalueerde, waaronder GPT-4.1, Claude 4, Gemini 2.5 en Qwen3, over acht invoerlengtes op bewust eenvoudige taken zoals retrieval en tekstreplicatie. De uitkomst is ongemakkelijk: modellen verwerken context niet gelijkmatig. Recall verslechtert bij elke stap in lengte, niet alleen in de buurt van de limiet. Een model met een contextvenster van een miljoen tokens vertoont al bij vijftigduizend tokens meetbare achteruitgang.
Twee details zijn belangrijker dan de kop. Ten eerste versnelt de achteruitgang naarmate de semantische gelijkenis tussen het weggestopte feit en de vraag afneemt, dus hoe moeilijker de retrieval, hoe sneller het rotten. Ten tweede veranderen afleiders en de structuur van de hooiberg de curve, los van de ruwe lengte. Samen wijzen ze naar dezelfde conclusie: de signaal-ruisverhouding is belangrijker dan de capaciteit. Een groter venster volproppen is geen strategie; het is juist wat het probleem veroorzaakt.
Waarom de muur juist in maand twee opduikt
Demo's zijn kort. Pilots zijn kort. In echt gebruik worden sessies lang, stapelt de geschiedenis zich op en raken feiten uit week één verouderd. De context die bij de lancering schoon was, is in maand twee een grote berg half relevante toolresultaten en achterhaalde waarheden, en dat is precies het regime waarin recall uit elkaar valt.
De nuttigste herformulering is dat 'geheugen' niet één ding is. Agentsystemen in productie scheiden minstens vier soorten, en de meeste vroege MVP's persen ze alle vier in één groeiend gesprekstranscript. Werkgeheugen is wat de agent nodig heeft voor de huidige stap en moet zonder pardon weggegooid kunnen worden. Episodisch geheugen is wat er is gebeurd: het verslag van eerdere sessies en uitkomsten. Semantisch geheugen is wat bekend is: duurzame feiten over een gebruiker, een account, een domein. Procedureel geheugen is hoe het werk wordt gedaan: de geleerde workflows en patronen die elke sessie moeten overleven.
Ze hebben totaal verschillende levensduren, en daar draait het om. Werkgeheugen moet voortdurend worden gewist; semantisch geheugen moet maandenlang blijven maar corrigeerbaar zijn; procedureel geheugen moet worden geversioneerd zoals code. Als alle vier in één contextvenster leven, krijg je voor elk het slechtste beleid: niets wordt ooit gewist, niets wordt ooit goed bijgewerkt, en elk feit concurreert om aandacht met elk verouderd toolresultaat. Context rot, geheugendrift, verloren doelen en opstapelende fouten zijn wat dat ontwerp met één venster onder belasting oplevert.
Naast de typen telt de scope. Volwassen geheugensystemen koppelen retrieval aan identiteit: gebruiker, agent, sessie of run, en organisatie. Een feit dat over de ene gebruiker is geleerd, mag niet weglekken naar de sessie van een ander; een workflow die organisatiebreed is geleerd, moet overal beschikbaar zijn. Heeft je agent geen scopemodel, dan vergeet hij te veel of onthoudt hij dingen die hij helemaal niet hoort te onthouden, en die tweede fout is een privacy-incident dat op het punt staat te gebeuren.
Het bemoedigende aan 2026 is dat de oplossingen meetbaar zijn, en dat ze architectonisch zijn in plaats van modelafhankelijk. De gepubliceerde resultaten van Anthropic op zijn eigen evaluaties van agentisch zoeken zijn het zuiverste voorbeeld: contextbewerking, waarbij verouderde toolcalls en -resultaten automatisch uit het venster worden gehaald, leverde 29% verbetering op complexe taken met meerdere stappen. Een geheugentool erbij, waarmee het model bestanden leest en schrijft in een geheugenmap buiten het contextvenster, bracht de gecombineerde winst op 39%. In een webzoekevaluatie van honderd beurten konden agents dankzij contextbewerking workflows afronden die eerder strandden op uitgeputte context, terwijl het tokengebruik met 84% daalde.
Lees die combinatie goed, want daarin zit de ontwerples. Bewerken alleen helpt omdat het de signaal-ruisverhouding verbetert. Bewerken plus een extern geheugen helpt meer, omdat de agent niet langer hoeft te kiezen tussen iets vergeten en erin verdrinken. De 84% minder tokens is het deel waar founders twee keer naar moeten kijken: dit is een van de zeldzame gevallen waarin de betrouwbaarheidsverbetering en de kostenbesparing dezelfde wijziging zijn.
Speciale geheugenlagen melden vergelijkbare winst op de standaardbenchmarks: scores in de lage tot middelste negentig op LoCoMo en LongMemEval bij ongeveer zevenduizend tokens per query, met sprongen van dubbele cijfers in temporeel en multi-hop-redeneren ten opzichte van eerdere aanpakken. Maar het eerlijke getal komt uit evaluatie op grote schaal: op BEAM zakt de prestatie van rond 64 bij een miljoen tokens aan geschiedenis naar rond 49 bij tien miljoen. Zelfs goede geheugensystemen gaan achteruit naarmate de geschiedenis groeit. De kwaliteit van retrieval is een echte beperking, geen opgelost probleem, en elke roadmap die ervan uitgaat dat 'we gewoon geheugen toevoegen' slaat de moeilijke helft over.
De goedkoopste eerste stap
Voordat je ook maar één geheugenleverancier evalueert: voeg contextbewerking toe. Laat toolresultaten verlopen zodra erop is gehandeld en gooi redeneersporen weg die de volgende stap niet meer informeren. Het is een paar dagen werk, het vraagt geen nieuwe infrastructuur, en het is de wijziging met het beste gemeten rendement per bestede uur.
Bijna elk gesprek over geheugen draait om retrieval: embeddings, rerankers, hybride zoeken. Maar de fouten die bouwers op Reddit beschrijven, zijn overweldigend fouten in het schrijfpad. De agent onthield iets correct en daarna veranderde de wereld. De klant stapte over op een ander abonnement. Het beleid werd bijgewerkt. De contactpersoon die dingen goedkeurde, vertrok. Het geheugen heeft het niet mis over het verleden; het heeft het mis over nu, en het systeem heeft geen mechanisme om dat op te merken.
Eén reageerder in die threads verwoordde het beter dan de meeste leveranciersdocumentatie: betrouwbaarheid op lange termijn vraagt om een manier om feiten te vergeten, te vervangen en opnieuw te verifiëren. Dat zijn drie verschillende bewerkingen. Vergeten is een time-to-live op herinneringen die alleen situationeel waren. Vervangen is een nieuw feit schrijven dat een oud feit expliciet buiten werking stelt in plaats van ernaast te blijven staan, want twee tegenstrijdige herinneringen in een retrieval-index zijn kop of munt, geen kennisbank. Opnieuw verifiëren is feiten met grote gevolgen opnieuw controleren tegen het bronsysteem voordat je erop handelt, in plaats van te vertrouwen op een notitie van zes weken oud.
Verouderd geheugen wordt zelfs door de teams die geheugeninfrastructuur bouwen openlijk erkend als onopgelost probleem, naast temporele abstractie en identiteitsresolutie. Wacht dus niet tot een library het voor je regelt. Bepaal per categorie feiten hoe lang ze waar blijven en wat er gebeurt als dat niet meer zo is, en leg dat beleid vast in het systeem in plaats van in een ontwerpdocument.
De andere helft van de muur van maand twee is helemaal niet cognitief: ze is infrastructureel. Agents die uren of dagen draaien, krijgen te maken met time-outs bij de provider, crashende pods, geplande deploys en netwerkonderbrekingen. Dat zijn geen randgevallen; over een lange genoeg horizon zijn ze gegarandeerd. Als de sessiestate in het procesgeheugen of op de vluchtige schijf van een pod leeft, vernietigt elk van die gebeurtenissen stilletjes alles wat de agent wist, en begint de agent de workflow opnieuw vanaf het begin, waarbij hij tokens verbrandt en soms neveneffecten herhaalt die hij nooit had mogen herhalen.
Het patroon dat werkt, is saai en goed begrepen: state in duurzame opslag, checkpoints die worden geschreven voordat elke stap wordt uitgevoerd, en hervatten op het exacte punt van de fout in plaats van bij het begin. De observatie uit diezelfde bouwerscommunity's is bot: de agents die geld verdienen, hebben duurzame herstelpaden, en de agents die in productie falen niet. Dat is ook waarom de terugkerende kritiek in het debat van deze zomer op X over grafen versus loops voor orkestratie zo hard aankwam: zoals de maker van XState opmerkte, herontdekt de sector steeds weer decennia oude software-engineeringpatronen onder nieuwe namen. Duurzame state machines zijn er een van. Je agent heeft dezelfde herstelgaranties nodig die elke langlopende job al dertig jaar nodig heeft.
Lanceer je volgend kwartaal een AI-MVP, dan heb je geen geheugensysteem van onderzoeksniveau nodig. Je moet de muur niet raken. Dat is een veel kleinere klus, en die draait vooral om vier beslissingen die je bewust neemt in plaats van per ongeluk.
Dat laatste punt slaan de meeste teams over. De hele reden dat de muur van maand twee een verrassing is, is dat niemand op maand twee heeft getest: de evaluatieset bestond uit schone, korte taken uit de eerste sessie, dus die bleef slagen terwijl de echte betrouwbaarheid wegzakte. Neem je één ding mee uit dit alles, laat het dit zijn: zet een bewust lange, bewust verouderde sessie in je testsuite, met een feit dat halverwege veranderde, en kijk of je agent het merkt.
De bredere verschuiving is het benoemen waard. Kopers zijn in 2026 niet meer onder de indruk van agentdemo's, omdat iedereen er een heeft. Wat ze echt kopen, is taakvoltooiing die bij de honderdste run nog standhoudt, en dat wordt bijna volledig bepaald door architectuur die de demo nooit op de proef stelt. Daar wordt het gewonnen, in het geheugen: niet door het model dat je kiest, maar door wat je besluit te bewaren, wat je besluit weg te gooien en wat je zeker weet dat een deploy overleeft.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.