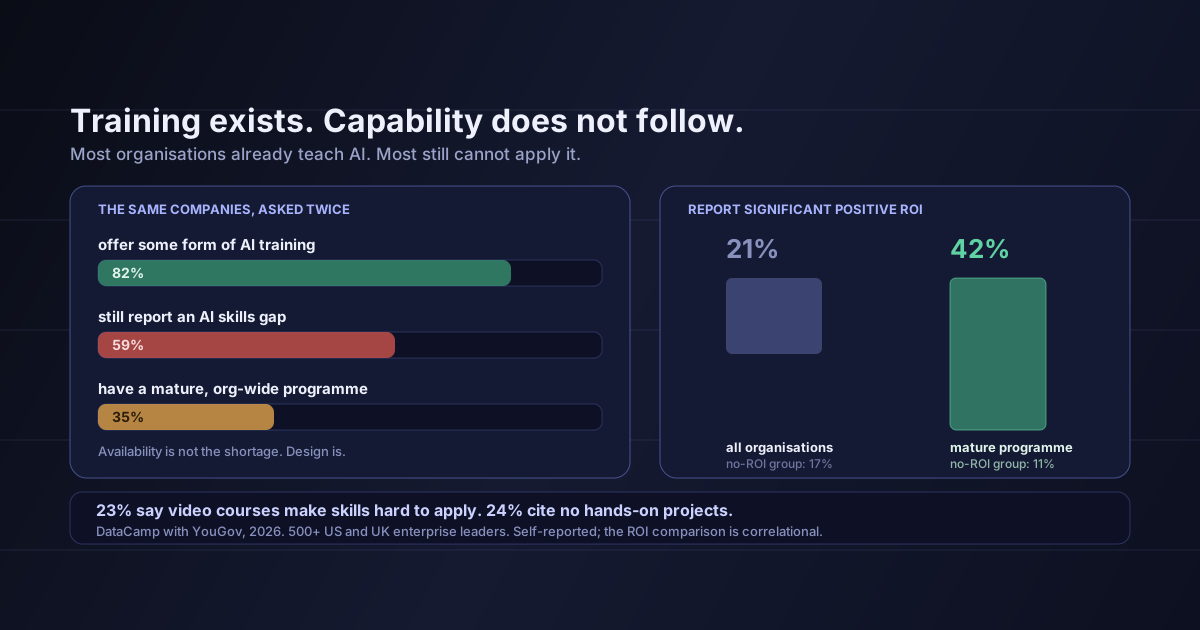
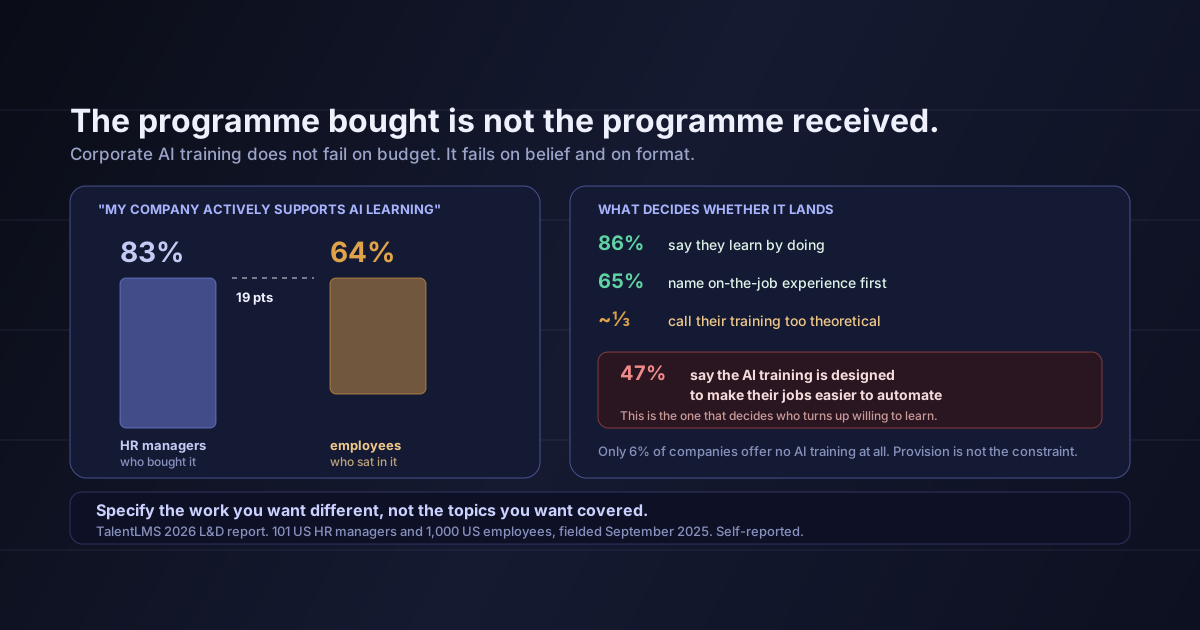
Maar 13% kan met AI-agents werken. Erger nog: maar 11% weet waar ze staan

By Surya Pratap
17 september 2026
10 min read
AI & Technology

17 september 2026
10 min read
 De vaardigheid die niemand bij zichzelf zietHover to explore
Het meeste dat over de AI-vaardighedenkloof wordt geschreven, discussieert of die bestaat. Een dit jaar gepubliceerde benchmark doet iets nuttigers: hij meet de kloof, rangschikt hem, en meldt dan terloops de bevinding die verklaart waarom zoveel trainingsgeld zo weinig oplevert.
De cijfers in dit artikel komen uit Workera's 2026 AI Skills Enterprise Benchmark Report en het AI-bijscholingsonderzoek van The Conference Board uit juli 2026. Beide zijn samengevat zoals gepubliceerd; de interpretatie ervan, en alles in paragraaf 6, is van mij.
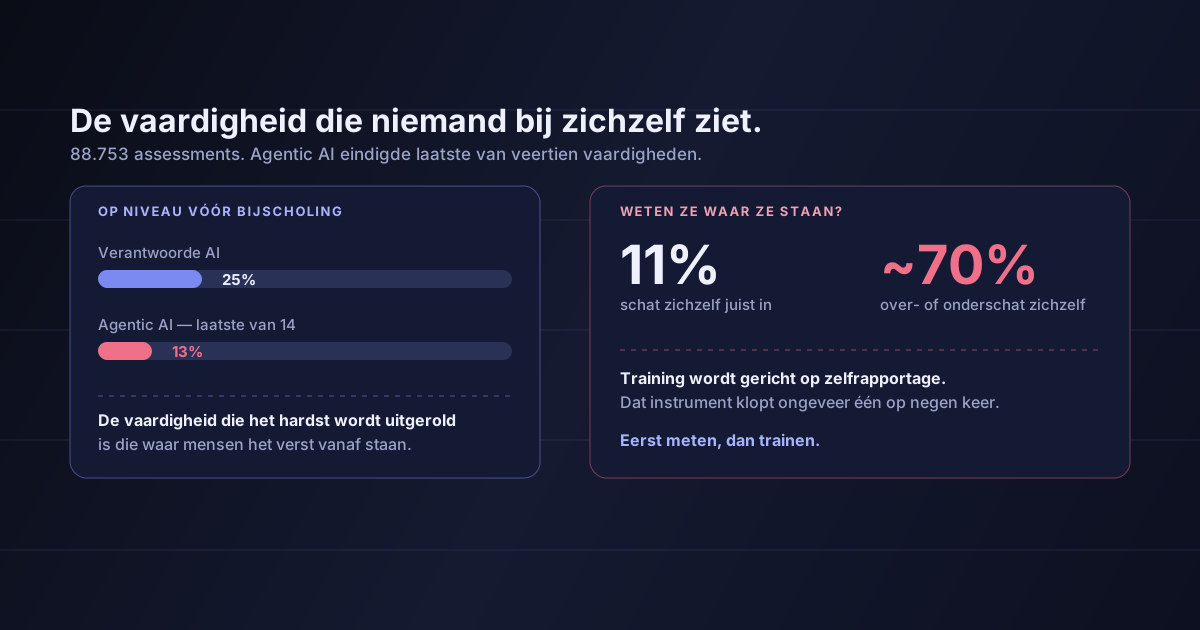
Workera analyseerde 88.753 assessments onder 32.422 mensen, verspreid over zakelijke dienstverlening, farmacie en zorg, financiële dienstverlening, consumentengoederen en de Amerikaanse federale overheid. Mensen werden gescoord op een schaal van 300 punten over 14 AI- en datavaardigheden, waarbij 201–300 geldt als "op niveau".
Die steekproefomvang doet ertoe, want hij verandert het soort bewering. Een enquête vraagt mensen wat ze denken. Een assessment zoekt het uit.
De kop: 13% van de medewerkers was op niveau in agentic AI-vaardigheden vóór enige bijscholing — het laagste van alle veertien gemeten vaardigheden.
De capaciteit die bedrijven het hardst uitrollen, is precies die waar hun mensen het verst vandaan staan.
Agentic AI scoorde niet laag omdat het nieuw en onbelangrijk is. Het scoorde laag terwijl het precies is waar in 2026 elke leveranciersroadmap, elke boardpresentatie en elke inkoopronde op gericht staat. De schaarste vaardigheid is de vaardigheid die nu wordt ingekocht.
Het getal dat je uitgaven écht zou moeten veranderen, staat verderop.
Maar 11% van de medewerkers beoordeelde het eigen vaardigheidsniveau juist. Bijna 70% schatte zichzelf te hoog of te laag in.
Sta daar even bij stil, want vrijwel elk bestaand trainingsprogramma wordt gericht met precies het instrument dat zojuist faalde. Vaardigheidsenquêtes, vrijwillige aanmelding voor cursussen, "beoordeel je vertrouwen van 1 tot 5"-formulieren, managers die vragen wie hulp nodig heeft: ze lezen allemaal een signaal dat ongeveer zeven van de tien keer fout is.
Het gaat twee kanten op mis, en die twee fouten kosten verschillend:
Wie zich bekwaam waant, meldt zich niet aan, vraagt niets, en levert werk dat niemand scherp nakijkt. Dit is de dure richting. Een engineer die denkt retrieval te begrijpen bouwt een pipeline die het goed doet in de demo en in stilte verslechtert.
Capabele mensen blijven weg van werk dat ze aankunnen, en de organisatie huurt capaciteit in die ze al heeft. Goedkoper, maar het vertekent het plan.
Waarom dit juist bij agents verergert
Agentic systemen falen in stilte. Een model dat fout zit in een chatvenster zit zichtbaar fout. Een agent die fout zit voert een actie uit, en de kosten komen later boven, in een supportticket of een afstemming. Het gat tussen "ik kan dit gebruiken" en "ik zie wanneer dit faalt" is precies het gat dat zelfinschatting niet ziet — en bij agents wordt dat gat operationeel.
The Conference Board ondervroeg bijna 1.300 werkenden en sprak 35 bestuurders in juli 2026. De relevante cijfers:
Leg de twee onderzoeken naast elkaar en het beeld is ondubbelzinnig. Een meerderheid gebruikt deze systemen wekelijks. Een derde had recent training. Ongeveer één op de acht is op niveau voor het agentic deel. En niemand — zijzelf incluis — kan betrouwbaar zeggen wie wie is.
Het praktische gevolg:
Dagelijks gebruik is geen capaciteit, en het is er ook geen bewijs van. Het is blootstelling. Blootstelling zonder meting is hoe een organisatie tegelijk zelfverzekerd en fout eindigt.
Het zou makkelijk zijn dit te lezen als een betoog dat training niets oplevert. De benchmark zegt het tegendeel, en specifiek.
Na gerichte bijscholing bereikte 81% van de medewerkers het niveau "op niveau" in verantwoorde AI, tegenover 25% aan het begin. Ook andere vaardigheden bewogen fors: 72% gemiddelde verbetering in datavisualisatie en storytelling, 53% in generatieve AI-basis, 47% in AI-basis.
Dat zijn grote bewegingen. De variabele is niet óf er training is — Conference Board zegt dat een derde dit jaar iets volgde — maar of ze gericht was op een gemeten tekort in plaats van een gevoeld tekort.
Een programma dat met een assessment begint, lost een ander probleem op dan een programma dat met een inschrijflijst begint. Het eerste weet wat het dicht. Het tweede gokt, met een instrument dat volgens datzelfde rapport onbetrouwbaar is.
Ga je komend kwartaal zakelijke AI-training specificeren, dan vertalen de bevindingen zich in een korte lijst eisen.
Bepaal de scope niet alleen met een vaardigheidsenquête. Zelfrapportage is precies wat faalde. Gebruik werkvoorbeelden, een kort assessment, of een review van iets dat het team echt heeft opgeleverd.
Specificeer het werk, niet de onderwerpen. "Ons team ziet niet wanneer een retrieval-antwoord fout is" is een opdracht. "Inleiding tot LLM's" is een catalogusregel.
Vraag hoe het programma omgaat met de zelfverzekerde deelnemer. Wie zichzelf overschat haakt het snelst af en is het duurst om ongecontroleerd te laten.
Eis een artefact. Iets dat de deelnemer heeft gemaakt en dat je achteraf kunt bekijken. Het is het enige capaciteitssignaal dat niet van iemands zelfinschatting afhangt.
En één vraag die elke aanbieder verdient, wij incluis: hoe zou dit programma eruitzien als het zich vergist in het startniveau van ons team? Een programma met een antwoord heeft over meten nagedacht. Een programma zonder antwoord verkoopt een syllabus.
Waar de IdeaToMVP Academy op elk van deze punten staat:
Onze zakelijke programma's zijn gescheiden per doelgroep in plaats van verkocht als één cursus, omdat een finance-team en een engineeringteam niet hetzelfde tekort hebben en niet langs dezelfde lat moeten. Elk traject publiceert zijn ingangseisen, zijn leerdoelen en het resultaat waarmee een deelnemer vertrekt.
Twee eerlijke grenzen. Wij nemen geen gestandaardiseerd psychometrisch assessment af zoals Workera dat doet — wil je een vergelijkende score over veertien vaardigheden, dan is dat een ander product en dat zeggen we ook. En een cohort lost geen strategieprobleem op: als niemand heeft besloten waarvoor AI in jouw organisatie dient, beslist een cursus dat niet voor je.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.
De benchmark is niet van ons, en zijn populatie is niet die van jou. Workera's steekproef neigt naar grote ondernemingen en de Amerikaanse federale overheid. Een startup van twaalf mensen is die populatie niet, en de percentages lees je als richting, niet als de waarschijnlijke score van je team.
De verbetercijfers komen van mensen die eerst gemeten en daarna getraind zijn. Dat is een geselecteerde groep, en de 81% bij verantwoorde AI is een meting ná de interventie, geen belofte die aan enig specifiek programma hangt, het onze incluis.
Correlatie, zoals altijd. Dat onze curricula tegen deze bevindingen zijn ontworpen, is een ontwerpkeuze. Het is geen bewijs dat ze beter presteren, en onze eigen resultaatdata is dun omdat de opdrachten waar we naar kunnen wijzen recent zijn.
De AI-vaardighedenkloof in 2026 is niet vooral een kloof in aanbod. Het is een kloof in zicht: de schaarste gemeten capaciteit is precies die welke organisaties het hardst uitrollen, en het instrument waarmee vrijwel iedereen zijn training richt — mensen vragen hoe het gaat — klopt in ongeveer één op de negen gevallen.
Dagelijks gebruik is geen capaciteit. Zelfvertrouwen is geen capaciteit. Het enige dat zich als capaciteit gedraagt, is iets dat iemand heeft gemaakt en dat een ander kan inspecteren.
Verander je dit kwartaal één ding aan hoe je AI-training inkoopt, stop dan met scopen vanuit een zelfinschattingsenquête en begin te scopen vanuit werk dat je team echt heeft geproduceerd.
Bronnen: Workera, 2026 AI Skills Enterprise Benchmark Report — 88.753 assessments onder 32.422 mensen, gescoord van 1 tot 300 met 201–300 als "op niveau", over 14 vaardigheden; alle benchmark- en na-bijscholingscijfers zijn zoals daar gepubliceerd. The Conference Board, AI-bijscholingsonderzoek, 28 juli 2026 — bijna 1.300 werkenden ondervraagd plus gesprekken met 35 bestuurders; de cijfers over gebruik, deelname en middelen zijn zoals daar gepubliceerd. Details over Academy-programma's zijn van ons en gelden op de publicatiedatum. Voor de aanbodkant van dit probleem, zie 82% van de bedrijven traint op AI en 59% meldt nog steeds een vaardighedenkloof, en voor de perceptiekloof tussen inkopers en deelnemers, 47% van de medewerkers denkt dat de AI-training er is om hun baan te automatiseren.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.