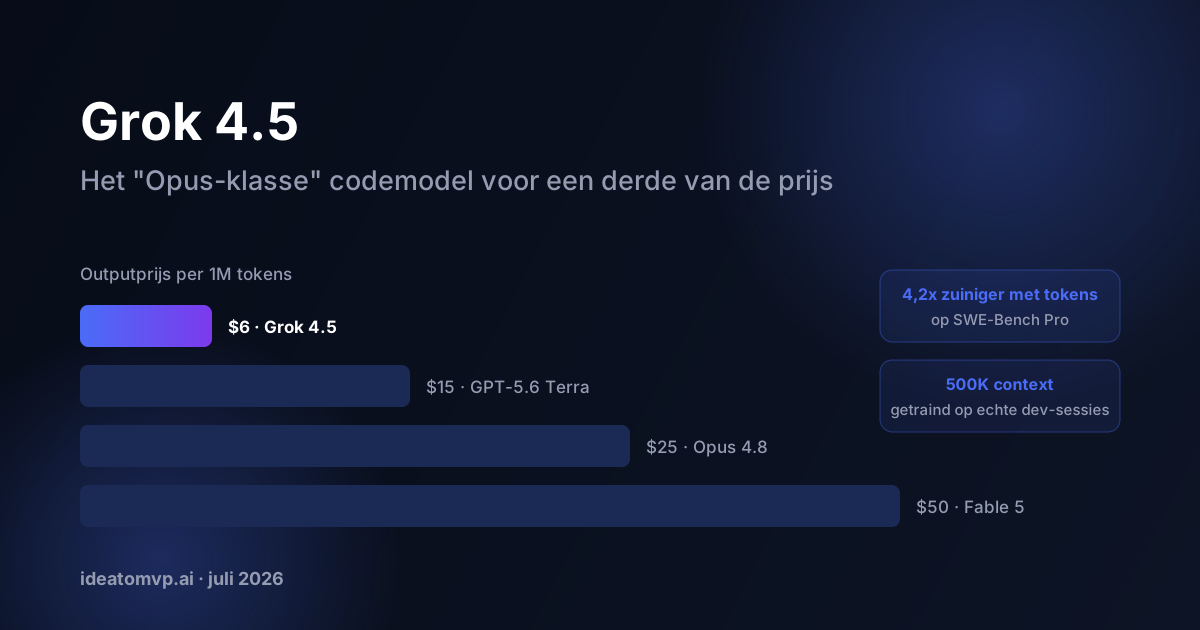
Juli 2026 zal worden herinnerd als de maand waarin de modellenoorlog een prijzenoorlog werd. Een dag voordat OpenAI GPT-5.6 uitbracht, lanceerde xAI Grok 4.5, zijn eerste model dat specifiek is getraind voor programmeren en autonome agents, voor $2 per miljoen inputtokens en $6 per miljoen outputtokens. Elon Musk positioneerde het zoals gewoonlijk zonder omwegen: "Het is een model van Opus-klasse, maar sneller, zuiniger met tokens en goedkoper." Niet het slimste model ter wereld, maar het voordeligste dat goed genoeg is voor echt engineeringwerk.
Die framing, "goedkoper en goed genoeg" als strategie in plaats van als excuus, is nieuw voor een frontier-lab, en de reacties op X en LinkedIn in de lanceringsweek splitsten zich precies langs die lijn. Hier lees je wat het model werkelijk is, wat de eerste gebruikers zeggen en hoe een founder ernaar moet kijken.
Wat Grok 4.5 werkelijk is
- Een model dat in de eerste plaats voor code en agents is gebouwd. xAI trainde het op data van echte developersessies uit zijn samenwerking met Cursor: volledige sessies in echte codebases, niet alleen statische codecorpora. Het ontwerpdoel is een agent die een lange sessie volhoudt zonder te ontsporen.
- $2 / $6 per miljoen tokens, 500K context. Dat is meer dan 60% goedkoper dan Opus 4.8 en GPT-5.5 op lijstprijs, met gecachete input voor $0.50.
- Extreem zuinig met tokens. Op SWE-Bench Pro meldt xAI dat Grok 4.5 taken oplost met gemiddeld ~16K outputtokens, tegenover ~67K voor Opus 4.8 in max-modus: een verschil van 4,2x. Omdat je voor outputtokens het meest betaalt, vermenigvuldigt die efficiëntie de korting op de lijstprijs: Artificial Analysis mat $0.49 per voltooide taak, bijna 90% goedkoper dan de modellen die boven het model staan in zijn ranglijst.
De benchmarks, eerlijk gelezen
Het eerlijke beeld is gemengd, en daardoor juist interessanter. Op de Intelligence Index van Artificial Analysis scoort Grok 4.5 een 54, vierde in het totaal, achter Fable 5 (60), Opus 4.8 (56) en GPT-5.5 (55). Van de vier benchmarks die xAI koos te publiceren, verslaat het Opus 4.8 op twee (DeepSWE 1.0 en Terminal-Bench 2.1) en verliest het op twee (DeepSWE 1.1 met 6 punten, SWE-Bench Pro met 4.5).
Met andere woorden: het is niet het beste model. Het is een model dat terecht tegen de frontier aan zit, voor een fractie van de kosten per taak, en xAI doet niet alsof het anders is. Musk zelf omschreef het doel als "de cirkel rondmaken voor bruikbaarheid in de echte wereld, niet voor benchmarks", en verwees naar doorgewinterde engineers bij Tesla en SpaceX die het echt nuttig vinden.
Wat X en LinkedIn zeggen
- Vroege Cursor-gebruikers zijn onder de indruk. De meest gedeelde vroege review, van developer Danny Limanseta, noemde het "Opus 4.8 op dubbele snelheid tegen een veel lagere prijs", na een volledige sessie van brainstormen, plannen en implementeren van een complexe gamefeature zonder handmatige correcties tussen de stappen.
- De LinkedIn-lezing gaat over het verdienmodel. Het commentaar dat het verst reikte, ging helemaal niet over capaciteit: het ging erover dat een frontier-lab nu vooral concurreert op prijs per voltooide taak, een metriek waarvan analisten zeiden dat die de margestructuur van zowel Anthropic als OpenAI kan doen wankelen.
- Sceptici wijzen op de keuze van benchmarks. De twee benchmarks die je wint naast de twee die je verliest publiceren, levert wat geloofwaardigheid op, maar critici op X merkten op dat "Opus-klasse" vergelijkt met het vorige niveau van Anthropic, niet met Fable 5. Zelfs Musk vergeleek het met "ongeveer Opus 4.7".
Het getal dat telt: kosten per voltooide taak
De prijs per token is het prijskaartje; de kosten per voltooide taak zijn de rekening. Een model dat 20% minder capabel is, maar 4x minder tokens gebruikt en 60% minder per token kost, wint de economie bij elke taak die het daadwerkelijk kan afronden. De juiste vraag is nooit "is het slimmer?", maar "welk deel van mijn workload kan het voltooien, en tegen welke kosten per voltooide taak?"
Waar Grok 4.5 past in de stack van een startup
- De rol van uitvoerder heeft er een serieuze kandidaat bij. In de stack plannen → uitvoeren → reviewen die we vorige week bespraken, valt Grok 4.5 precies in de uitvoeringslaag, met meer capaciteit dan de gebruikelijke goedkope uitvoerders. Voor agentische programmeerlussen waarin het tokenverbruik pijn doet, is dit efficiëntieprofiel precies waar de groep die $200 per dag uitgeeft om heeft gevraagd.
- Lange sessies zijn zijn thuisbasis. Getraind op echte data van volledige sessies en met 500K context, is het gebouwd voor het patroon "blijf een uur doorwerken in deze codebase" in plaats van losse snippets. Benchmark het eerst op je langstlopende agent-workflows.
- Houd planning en review voorlopig elders. Een vierde plaats op algemene intelligentie is uitstekend voor de prijs, maar architectuurbeslissingen en de laatste review horen nog steeds bij de sterkste redeneerder die je je kunt veroorloven, en review door een andere modelfamilie wordt belangrijker, niet minder belangrijk, nu elk lab harder optimaliseert voor agentische benchmarks.
- Benut de prijzenoorlog tussen drie partijen. Grok 4.5 op 8 juli, GPT-5.6 op 9 juli, Anthropic dat binnen het uur limieten reset: drie frontier-labs bieden in dezelfde week op je workload. Heb je je prijzen bij je AI-leverancier meer dan een kwartaal geleden vastgelegd, dan betaal je te veel.
De kern
Grok 4.5 is tot nu toe het duidelijkste signaal dat de frontier zich splitst in twee races: één voor maximale intelligentie en één voor minimale kosten per voltooide taak. Founders hoeven geen kant te kiezen: een goed gerouteerde stack profiteert van allebei. Zet Grok 4.5 in je uitvoeringslaag, laat het een week draaien op je echte workloads, en laat de cijfers beslissen, niet de lanceringstweets, hoeveel van je workload het verdient.
Hulp nodig bij het benchmarken van de nieuwe modellen op de echte workloads van je product? Plan een gratis discovery call: we bouwen en tunen elke maand stacks voor modelroutering voor founders.
IdeaToMVP Academy
Want to build with AI — not just read about it?
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.