Verticale AI-integratie voor enterprises: de GPU-, model- en applicatielaag in eigen hand in 2026

Surya Pratap
By Surya Pratap

7 juli 2026

11 min read

AI & Technology
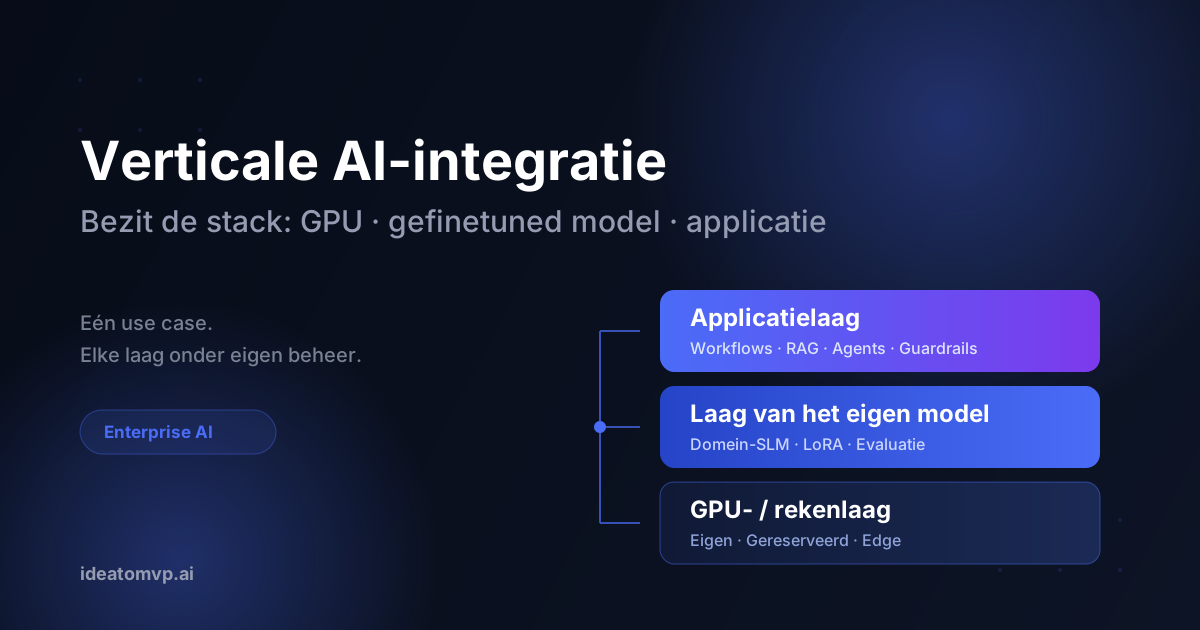
Verticale AI-integratie: de GPU-laag, de laag van het gefinetunede model en de applicatielaag

De afgelopen drie jaar was de standaard AI-architectuur in enterprises horizontaal: huur een frontier-model via een API, koppel het aan een dozijn workflows en betaal per token. Dat was snel om mee te beginnen en duur om bij te blijven. In 2026 doen de grootste en operationeel serieuste enterprises stilletjes het tegenovergestelde: ze integreren hun AI-stack verticaal, laag voor laag, rond de use cases die hun winst-en-verliesrekening echt bewegen.

Verticale integratie in AI betekent hetzelfde als voor Ford en staal of Apple en silicium: de lagen van je waardeketen die onderscheid opleveren zelf bezitten, in plaats van ze te huren van een leverancier die ook je concurrenten bedient. In AI zijn dat drie lagen: de rekenlaag (GPU), de modellaag en de applicatielaag. Dit artikel loopt ze een voor een door, legt uit waarom de rekensom van integratie eindelijk klopt, en beschrijft de volgorde waarmee een enterprise de overstap kan maken zonder het bedrijf op het spel te zetten.

Waarom verticale integratie, en waarom nu

Drie krachten kwamen samen, waardoor het bezitten van de stack rationeel werd voor enterprises die in 2024 om het idee zouden hebben gelachen.

  • API-kosten groeiden niet meer mee met de waarde. Enterprises die AI in productieworkflows draaien, melden maandelijkse API-rekeningen van vijf en zes cijfers, waarbij de meeste tokens opgaan aan repetitieve, smalle taken (classificatie, extractie, samenvatting) die helemaal geen frontier-model nodig hebben. Topprijzen betalen voor routine-inferentie is het AI-equivalent van batchjobs draaien op dure on-demand cloudinstances.
  • Open-weight-modellen dichtten de kwaliteitskloof op smalle taken. Een klein gefinetuned model, getraind op je eigen gelabelde data, verslaat nu routinematig een frontier-model met prompts op precies de taak waarvoor het is getraind, tegen een fractie van de latency en kosten. De kloof doet er alleen toe bij open redeneren, en dat is een minderheid van de workloads in enterprises.
  • Datasoevereiniteit werd een onderwerp voor de raad van bestuur. Gereguleerde sectoren (zorg, financiën, defensie, juridisch) kunnen hun waardevolste data steeds minder naar een API van derden sturen, punt. De keuze is niet "huren of bezitten"; het is "bezitten of niet uitrollen".

De strategische logica is dezelfde die Alex Karp van Palantir publiekelijk blijft herhalen: houd controle over je rekenkracht, je modelgewichten en je data, of zie de waarde van je eigen kennis wegvloeien naar de trainingsrun van een ander. Verticale integratie is hoe dat principe architectuur wordt.

Laag 1: de GPU- / rekenlaag

De rekenlaag bezitten betekent niet dat je een datacenter bouwt. Het betekent overstappen van prijzen per token naar capaciteit die je zelf beheert, in de vorm die bij je schaal past:

  • Gereserveerde GPU-cloud: vastgelegde A100/H100-capaciteit bij aanbieders als CoreWeave, Lambda of de gereserveerde niveaus van de hyperscalers. Het instappunt voor de meeste enterprises: voorspelbare kosten, geen investeringen vooraf en geen eigen hardwareteam.
  • Eigen inferentiehardware: een klein rack met L40S- of RTX-kaarten voor stabiele, latency-gevoelige inferentie. Eén moderne GPU serveert een gefinetuned 7B-model aan honderden gelijktijdige gebruikers; de hardware verdient zich tegenover API-rekeningen terug in maanden, niet in jaren.
  • Edge-inferentie: gekwantiseerde modellen die on-premises of op het apparaat draaien waar data het gebouw niet mag verlaten: ziekenhuisnetwerken, fabrieksvloeren, handelsdesks.

De beslisregel is benutting. Is je inferentievolume stabiel en voorspelbaar, dan winnen eigen of gereserveerde capaciteit. Is het grillig en experimenteel, houd die workload dan op gehuurde rekenkracht en integreer eerst de stabiele.

Laag 2: de laag van het gefinetunede model

Dit is de laag waar verticale integratie een slotgracht oplevert. Een frontier-API geeft elke concurrent dezelfde intelligentie voor dezelfde prijs. Een model dat is gefinetuned op je transactiegeschiedenis, je supportgesprekken, je contracten en je defectrapporten: dat is intelligentie die alleen jij hebt.

De moderne fine-tuningpipeline is veel lichter dan de meeste bestuurders denken:

  • Keuze van het basismodel: begin met een open-weight-model (Llama, Phi, Gemma, Mistral) op maat van de taak. De meeste enterprise-taken vallen in het bereik van 3B–8B.
  • Parameter-efficiënte training: LoRA en QLoRA passen een basismodel aan met duizenden voorbeelden op één GPU in een paar uur. Het echte werk zit niet in rekenkracht maar in datacuratie: de kwaliteit van je gelabelde voorbeelden bepaalt de kwaliteit van het model.
  • Evaluatielussen: een achtergehouden testset, gescoord op je echte bedrijfsmetriek en gedraaid bij elke hertraining. Dat is de discipline die modelprogramma's in productie onderscheidt van wetenschapsprojecten.
  • Ritme van hertraining: maandelijks of per kwartaal hertrainen op verse productiedata. Elke cyclus vergroot de afstand tussen jouw model en alles wat een concurrent met prompt engineering kan bereiken.

De integratietest voor de modellaag

Stel één vraag: profiteert deze taak van kennis die alleen wij hebben? Zo ja, fine-tune hem en neem hem in eigen hand. Zo nee, als een generiek model met goede prompts het werk doet, blijf die taak dan huren en besteed je trainingsbudget waar je data het voordeel is.

Laag 3: de applicatielaag

De applicatielaag is waar het model het bedrijf ontmoet, en het is de laag die enterprises het vaakst verkeerd aanpakken: ofwel door hem aan een SaaS-leverancier over te laten (en met de data ook de workflow kwijt te raken), ofwel door er minder in te investeren dan in het model. Een verticaal geïntegreerde applicatielaag omvat:

  • Serving-infrastructuur: vLLM of TGI voor inferentie met hoge doorvoer, met afgedwongen structured output zodat systemen verderop geldige JSON krijgen en geen proza.
  • Retrieval (RAG) over je eigen kennis: je documenten, ingebed en geïndexeerd op je eigen infrastructuur, zodat het model antwoordt vanuit jouw bron van waarheid in plaats van vanuit zijn trainingsdata.
  • Intelligente routering: het pragmatische hart van de stack. Stuur 70–80% van de verzoeken naar je gefinetunede model; escaleer de echt moeilijke, open 20–30% naar een frontier-API. Verticale integratie is geen zuiverheid: het is elk verzoek op de goedkoopste laag zetten die het goed afhandelt.
  • Guardrails en audit: filtering van input en output, omgang met persoonsgegevens en volledige logging van verzoeken. Als je de stack bezit, is compliance geen vragenlijst van een leverancier meer, maar een eigenschap van je architectuur.

De volgorde: hoe enterprises de overstap echt maken

Geen enkele enterprise integreert alles tegelijk verticaal. Het patroon dat werkt, loopt van boven naar beneden, het omgekeerde van hoe je het stackdiagram leest:

  • Neem eerst de applicatielaag in eigen hand. Bouw je workflows, retrieval en routering op gehuurde frontier-API's. Hier leer je hoe je echte verdeling van verzoeken eruitziet, en dat zijn de gegevens die je voor elke latere beslissing nodig hebt.
  • Integreer de modellaag voor je taak met het hoogste volume. Kies de workload die de meeste API-uitgaven opslokt, fine-tune er een klein model voor en zet dat achter de router. Meet kwaliteit en kosten tegenover de API-baseline.
  • Integreer rekenkracht zodra de benutting dat rechtvaardigt. Is je zelf gehoste inferentie stabiel, verplaats die dan van on-demand GPU-cloud naar gereserveerde of eigen capaciteit en leg zo je kostenvloer vast.

Elke stap wordt op zichzelf gerechtvaardigd door zijn eigen rendement, en elke stap is omkeerbaar. Dat maakt dit een strategie in plaats van een gok.

Wanneer je niet moet integreren

Verticale integratie is niets voor jou als je AI-workloads nog verkennend zijn, als je de gelabelde data mist die fine-tuning de moeite waard maakt, of als je kerntaken echt redeneren op frontier-niveau en brede wereldkennis vragen. In die gevallen is de gehuurde stack geen valkuil: het is het juiste gereedschap. De fout is erop blijven zitten als standaard nadat je workloads smal, stabiel en datarijk zijn geworden.

De kern

De enterprises die in 2026 winnen met AI, zijn niet die met de grootste API-budgetten. Het zijn die hun use case met de hoogste waarde en het hoogste volume vonden en de stack daaronder integreerden: applicatielogica die ze zelf beheren, een model getraind op data die alleen zij hebben, draaiend op rekenkracht die geprijsd is als infrastructuur in plaats van als nutsvoorziening met een meter. Begin bovenaan de stack, ga laag voor laag omlaag en laat het rendement van elke laag de volgende financieren.

Twijfel je waar je moet beginnen (welke workload je als eerste fine-tunet, of je volume eigen rekenkracht rechtvaardigt)? Plan een gratis discovery call en we brengen je stack samen met je in kaart.


IdeaToMVP Academy

Want to build with AI — not just read about it?

4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.

Explore the Academy →
Share this post :