
De multimodelstack: hoe startups in 2026 hun AI-programmeerkosten met 85% verlagen

By Surya Pratap
8 juli 2026
9 min read
AI & Technology

8 juli 2026
9 min read
Op 7 juli 2026 plaatste Paul Graham een gedachte-experiment van één regel dat tech-Twitter overnam: "Stel je voor hoe het zal zijn als modellen over 5 jaar evenveel beter zijn geworden dan Fable als Fable beter is dan GPT-3." De quote-tweets splitsten zich zoals altijd: half verwondering, half scepsis. Maar het nuttigste gesprek ging helemaal niet over 2031. Het stond in de reacties, waar werkende developers hun rekeningen deelden.
$200 per dag. $350 per dag. $500 per dag bij zware agent-loops. Geen uitschieters, maar een constante stroom founders en engineers die hetzelfde zeiden: de nieuwste frontier-modellen zijn verbluffend, en je hele ontwikkelworkflow erdoorheen jagen wordt stilletjes een van de grootste posten op het budget van een kleine startup. Diezelfde week ging een tegenpatroon viraal op Reddit en X: de multimodelstack, en de cijfers erachter verdienen de aandacht van elke founder.
Dit is de ongemakkelijke rekensom. Huidige frontier-modellen kosten op lijstprijs zo'n $10 per miljoen inputtokens en $50 per miljoen outputtokens. Middenklassemodellen van dezelfde labs kosten een vijfde daarvan of minder. En voor een groot deel van wat een ontwikkelworkflow werkelijk doet (variabelen hernoemen, boilerplate schrijven, tests genereren uit een duidelijke spec, lintfouten oplossen, itereren op CSS) levert het middenklassemodel in wezen hetzelfde resultaat.
Als je alles door het frontier-model haalt, betaal je 100% van de tijd de meerprijs voor werk dat die misschien 20% van de tijd nodig heeft. Zo eindigt een solo-founder met een AI-rekening van $6,000/maand nog voordat er één betalende klant is.
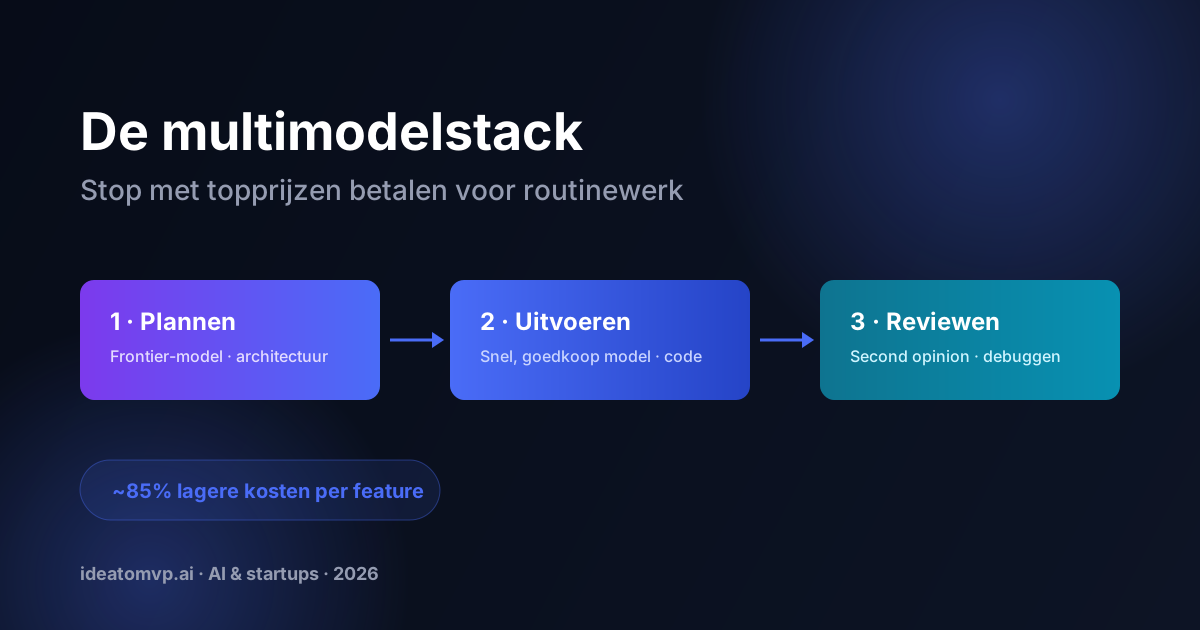
De multimodelstack die deze week viraal ging, heeft drie fasen, die elk worden gerouteerd naar het model dat het best geschikt, en het best geprijsd, is voor die klus:
De rekensom per feature
Teams die dit patroon gebruiken, melden ongeveer 85% lagere kosten per feature bij vergelijkbare of betere kwaliteit, omdat het dure model alleen de korte stappen met veel hefboom raakt en de tokenrijke generatie gebeurt op modellen die voor volume geprijsd zijn. Voor een team dat tientallen features per sprint shipt, is dat het verschil tussen AI-uitgaven als afrondingsfout en AI-uitgaven als je op één na grootste kostenpost na salarissen.
Een groot bedrijf kan een opgeblazen AI-rekening opvangen. Een pre-seed-startup niet, en belangrijker nog: de gewoonte stapelt zich op. Teams die modelroutering vroeg als een engineeringdiscipline behandelen, houden er drie structurele voordelen aan over:
De kloof tussen GPT-3 en de huidige frontier-modellen is moeilijk te overdrijven, en als de komende vijf jaar die sprong herhalen, zullen de meeste workflowdiscussies van nu ouderwets lijken. Maar die toekomst snijdt aan twee kanten: elk frontier-model uit het verleden werd uiteindelijk een standaardmodel. Het vlaggenschip van vandaag voor $50 per miljoen tokens is de goedkope uitvoerder van volgend jaar. Een multimodelstack is geen gok tegen AI-vooruitgang: het is de architectuur die er automatisch van profiteert, omdat elke nieuwe release in je routeringstabel landt op het niveau dat zijn prijs rechtvaardigt.
De startups die deze cyclus winnen, zijn niet degene die het meest aan tokens uitgaven. Het zijn degene die de discipline opbouwden om precies uit te geven wat elke taak waard is, en daardoor sneller shipten.
Bouw je een AI-product en wil je hulp bij het ontwerpen van een architectuur voor modelroutering die je burn voorspelbaar houdt? Plan een gratis discovery call: dit is precies het soort systeem dat we elke maand voor founders opleveren.



IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.