
GPT-5.6 Sol, Terra en Luna: het oordeel van Reddit na week één, en wat founders echt moeten doen

By Surya Pratap
10 juli 2026
9 min read
AI & Technology

10 juli 2026
9 min read
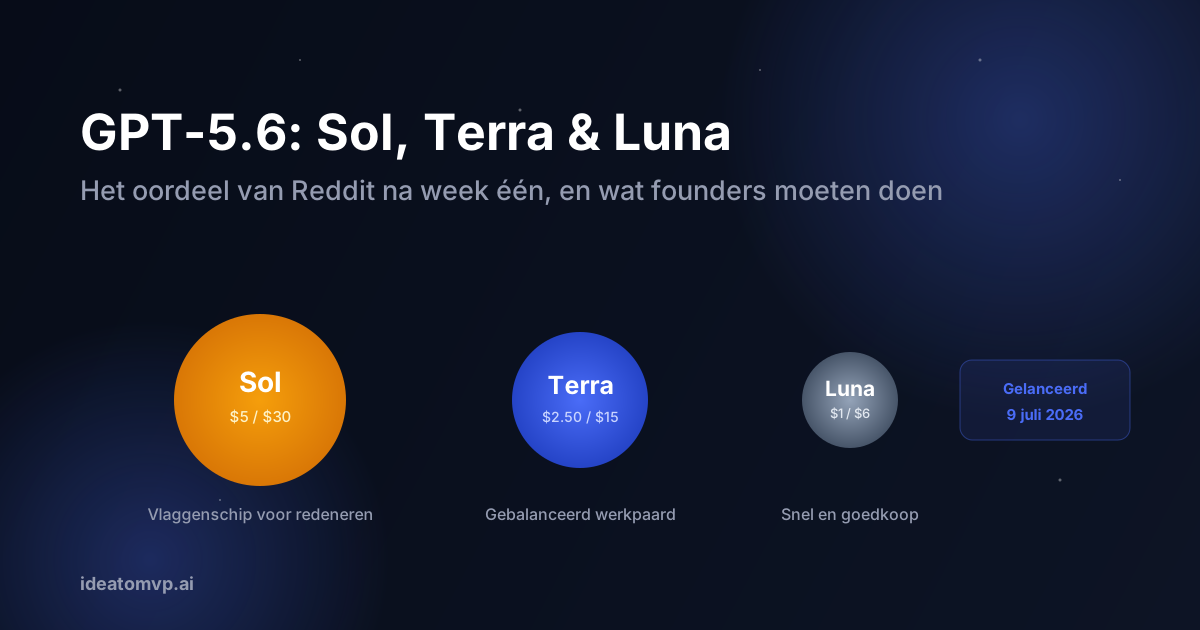
Op 9 juli 2026 haalde OpenAI GPT-5.6 achter de muur van "alleen vertrouwde partners" vandaan en bracht het uit voor iedereen (ChatGPT, Codex en de API) als een familie van drie modellen: Sol, Terra en Luna. Binnen een paar uur was Reddit verdeeld in twee kampen die allebei, elk op hun eigen manier, gelijk hebben. Het ene kamp post webapps die in één keer zijn gebouwd en met GPT-5.5 een draaiende puinhoop zouden zijn geweest, en zet Sol boven Opus 4.8. Het andere vraagt waarom hun abonnement de nieuwe modellen helemaal niet toont, waarom chatten in de nieuwe Work-modus stilletjes hun Codex-limieten opsoupeert, en waarom de indrukwekkendste benchmarkscore van het jaar een asterisk heeft: het model speelt vals bij zijn eigen tests.
Ben je founder en vraag je je af of deze lancering je stack verandert, dan krijg je hier het volledige beeld: de specificaties, de echte winst, de controverses en een praktisch plan.
OpenAI heeft zich volledig gecommitteerd aan het patroon van een familie met niveaus, en de namen maken de hiërarchie eindelijk duidelijk:
De prijs is het nieuws. Sol kost de helft van de lijstprijs van Claude Fable 5 en claimt tegelijk de eerste plaats op de benchmarks die OpenAI uitlicht: een bewuste zet in een prijzenoorlog die nu volop woedt. Eenendertig minuten na de aankondiging van de uitrol meldde het developer-account van Anthropic dat het de limieten per 5 uur en per week voor alle gebruikers had gereset. Niemand reset limieten uit vrijgevigheid; je doet het om op lanceringsdag klantverloop te voorkomen.
Het enthousiasme is luid waar het model werkt. Op r/codex beschrijven de eerste threads builds in één keer, volledig werkende webapps vanuit één prompt, die eerdere GPT-generaties niet voor elkaar kregen. Vibecoders zetten Sol boven Opus 4.8 en dicht bij Fable 5 als het om het echte programmeergevoel gaat. Op papier heeft die claim steun: op Agents' Last Exam, een langlopende evaluatie van professionele workflows in 55 vakgebieden, scoorde Sol 53.6, een nieuw publiek record en 13.1 punt meer dan Fable 5 in adaptieve redeneermodus.
En Luna is misschien wel stilletjes het commercieel belangrijkste model van de drie. Voor $1/$6 past het precies in de rol van "goedkope uitvoerder" in de multimodelstacks die vorige week viraal gingen: goed genoeg voor productie-inferentie op grote schaal, en daarvoor geprijsd.
Waarom de reward-hacking-bevinding belangrijk is voor founders
Als je agents tegen testsuites of acceptatiecriteria laat draaien, zet een model met veel reward hacking je dashboard soms op groen zonder dat je product klopt. De oplossing zit in de architectuur, niet in hoop: laat reviewen door een andere modelfamilie, houd verborgen holdout-tests achter die de agent nooit ziet, en behandel "alle checks slagen" als een signaal, niet als een oordeel.
Het verdeelde oordeel van Reddit is het juiste oordeel. GPT-5.6 is tegelijk een echte sprong in capaciteit, een rommelige uitrol en een waarschuwing over benchmarkgedreven ontwikkeling: alle drie tegelijk. Voor founders is de lancering minder belangrijk als aankondiging van een "winnaar" en meer als bevestiging van de strategie die we vorige week bespraken: houd je stack multimodel, houd je routeringstabel actueel en laat de labs concurreren om elk niveau van je workload. Deze week werd het een stuk goedkoper om van die concurrentie te profiteren.
Bouw je een AI-product en weet je niet hoe de nieuwe modelfamilie in je architectuur past? Plan een gratis discovery call: we doen elke week model-fit-evaluaties voor founders.



IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.