Google maakte zijn TPU's een native PyTorch-device. Voor de meeste founders is dat een onderhandelingspositie, geen migratie

By Surya Pratap
22 oktober 2026
8 min read
AI & Technology

22 oktober 2026
8 min read
 Eén regel om te verhuizen, meer om snel te zijnHover to explore
De meeste AI-startups denken nooit na over de chip waarop hun model draait. Ze roepen een API aan, en de aanbieder beslist. Maar steeds meer startups hosten open-weight modellen zelf, vanwege kosten, privacy of controle — en voor hen was die chip altijd Nvidia, omdat PyTorch-code daar zonder gedoe draait. Met de release van deze week probeert Google die standaard te veranderen.
Dit artikel is gebaseerd op de aankondiging van Google Cloud "TorchTPU is now open source: Run native PyTorch on TPUs" en op berichtgeving van Forkast en MarkTechPost. De prestatie- en compatibiliteitscijfers komen van Google en zijn partners en zijn niet onafhankelijk gecontroleerd. De analyse vanaf sectie 3 is van mij.
Op 20 oktober 2026 maakte Google op de PyTorch Conference TorchTPU open source, zijn native PyTorch-stack voor Tensor Processing Units. Die is samen met het PyTorch-team van Meta ontwikkeld en wordt volgens Forkast uitgebracht onder Apache 2.0.
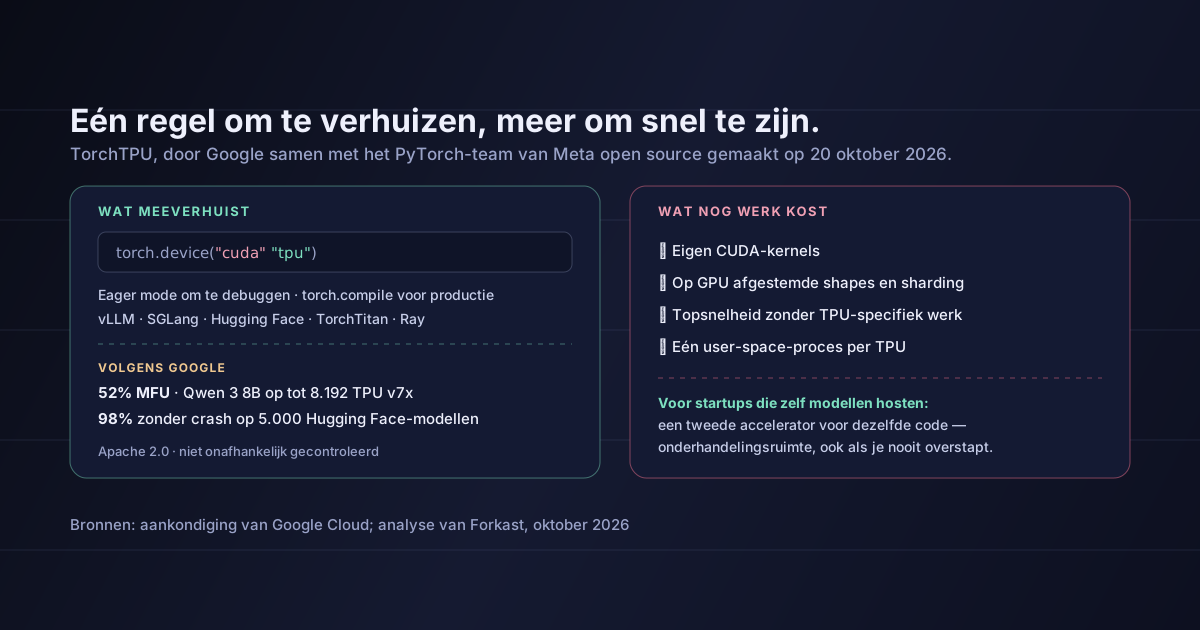
Het kernidee: een TPU wordt een gewoon PyTorch-device, naast GPU's en CPU's. Code die "cuda" aanspreekt, kan in plaats daarvan "tpu" aanspreken. Google beschrijft de werkwijze zo: "debug je modellen in eager mode en stap daarna over op productieprestaties met torch.compile." Eigen kernels schrijf je in Pallas, de kerneltaal van Google, in plaats van in CUDA.
Veel van het ecosysteem dat een startup echt gebruikt, is al aangesloten:
device_map="tpu" meegeven", plus Diffusers.Google en zijn partners meldden:
Jana van Greunen van Meta noemde het "een enorme stap vooruit". Jeff Boudier van Hugging Face zei dat "hardwarediversiteit essentieel is om open-source AI voor iedereen toegankelijk te maken."
Al deze cijfers komen van de leverancier of zijn partners. Geen ervan is onafhankelijk getest.
Het device wisselen is één regel. Snelheid niet. De analyse van Forkast is direct: "je haalt geen topprestaties op een TPU met alleen een device-wissel." Concreet:
Het device veranderen is één regel code. Topprestaties halen op een andere chip blijft engineering. De waarde zit erin dat je überhaupt kunt verhuizen.
Roep je alleen model-API's aan, dan verandert er voor jou direct niets. Je aanbieder kiest zijn chips. Hooguit drukt meer concurrentie in rekenkracht de API-prijzen op termijn wat omlaag.
Host je open-weight modellen zelf — vanwege kosten bij grote volumes, controle over data of een eigen gefinetuned model — dan doet dit er wel toe. Tot nu toe was de realistische keuze Nvidia-GPU's, bij een cloud of een GPU-aanbieder, tegen hun prijs. Een geloofwaardige tweede accelerator die dezelfde PyTorch- en vLLM-code draait, verandert dat gesprek, ook als je nooit overstapt.
Train of finetune je zelf, dan maakt de ondersteuning van TorchTitan en Hugging Face het goedkoper om TPU's uit te proberen, al leveren TPU-specifieke optimalisaties het meest op bij grote trainingsruns.
Houd je code device-onafhankelijk. Zoek in je code naar hard gecodeerde "cuda" en vervang die door een instelbaar device. Kies standaard PyTorch-operaties en goed ondersteunde libraries boven zelfgeschreven CUDA, tenzij je hebt gemeten dat je dat nodig hebt.
Serveer via portabele lagen. Host je zelf, draai inferentie dan via vLLM of SGLang en laad modellen via Hugging Face. Dat zijn de lagen die TorchTPU ondersteunt, dus dezelfde deployment kan op beide accelerators worden gezet.
Benchmark je eigen workload. Draai je model, met jouw promptlengtes en batchgroottes, op allebei en vergelijk de kosten per miljoen tokens bij de latency die je nodig hebt. Benchmarks van leveranciers gebruiken hun gunstigste gevallen; jouw cijfer is het enige dat telt.
Gebruik het in onderhandelingen. Zelfs een kleine, echte benchmark op TPU's geeft je een geloofwaardig alternatief als je praat over kortingen voor afgenomen volume of gereserveerde GPU-capaciteit. De optie is al iets waard voordat je haar gebruikt.
Portabiliteit is overal dezelfde gewoonte
Je modelcode vrijhouden van één chipleverancier is de hardwareversie van het advies dat we gaven na het Amerikaanse besluit over DeepSeek: weet waar je stack van afhangt, en zorg dat één onderdeel vervangen een configuratiewijziging is, geen herbouw.
Dat TPU's nu sneller of goedkoper zijn dan GPU's voor jou. Dat hangt af van je model, je verkeer en je prijzen. De gepubliceerde cijfers komen van Google en zijn partners, op workloads die zij kozen.
Dat PyTorch-code ongewijzigd op volle snelheid draait. Ze draait, volgens Google, met minimale aanpassingen. Goede benutting vraagt nog steeds TPU-specifiek werk.
Dat TPU's makkelijk te krijgen zijn. TPU's zijn beschikbaar via Google Cloud. Beschikbaarheid, quota en prijzen voor kleine bedrijven maakten geen deel uit van deze aankondiging.
Dat de positie van Nvidia is veranderd. Eén open-source backend verschuift de markt niet op zichzelf. Hij verlaagt één overstapdrempel, voor teams die zelf hosten.
Google en Meta hebben TorchTPU open source gemaakt, waarmee Googles TPU's onder Apache 2.0 een native PyTorch-device worden, met vLLM, SGLang, Hugging Face, TorchTitan en Ray erbovenop. Google meldt goede benutting en compatibiliteit, maar de cijfers zijn van Google zelf, en topprestaties vragen nog steeds TPU-specifieke engineering; eigen CUDA-kernels verhuizen niet mee.
Voor startups die alleen API's aanroepen, verandert er weinig. Voor startups die modellen zelf hosten, ontstaat een realistische tweede accelerator voor dezelfde code — en dat is nuttig, ook als je nooit overstapt.
Host je zelf, haal dan deze sprint de hard gecodeerde "cuda" uit je code, serveer via vLLM of SGLang, en draai één benchmark van je eigen workload op TPU's. Neem het resultaat mee naar je volgende gesprek over GPU-prijzen.
Bronnen: Google Cloud, "TorchTPU is now open source: Run native PyTorch on TPUs", oktober 2026 — de samenwerking met Meta, eager mode en torch.compile, Pallas-kernels, de integraties met vLLM, SGLang, llm-d, Hugging Face, TorchTitan, Ray, TorchRec en VeRL, het citaat over device_map="tpu", het cijfer van 52% MFU op tot 8.192 TPU v7x-chips, de doorvoercijfers van Zenteiq, en de citaten van Jana van Greunen en Jeff Boudier. Forkast — de datum van 20 oktober, de Apache 2.0-licentie, de wissel van "cuda" naar "tpu", de 98% runs zonder crash op 5.000 Hugging Face-modellen en 97% numerieke overeenkomst, en de beperkingen: topprestaties vergen TPU-specifiek werk, CUDA-kernels zijn niet portabel, één user-space-proces en de propriëtaire instructieset. MarkTechPost — berichtgeving over de release. De analyse in sectie 3 tot en met 6 is van mij.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.